Adresse eintragen
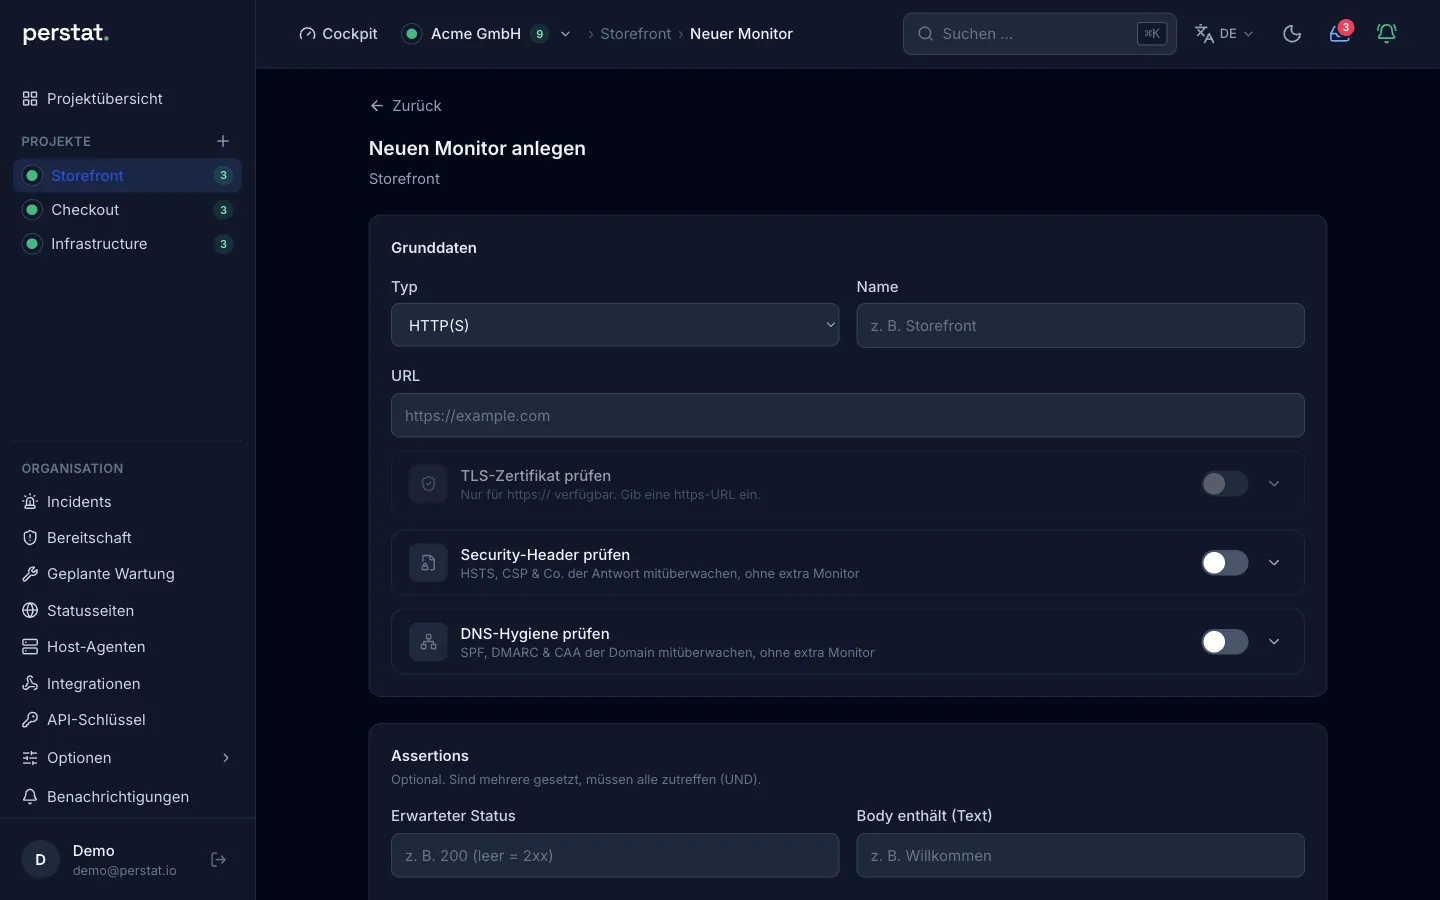
Lege einen HTTP-Monitor für deine Website oder API an. Wähle Regionen und Intervall passend zum Tarif.
Free · 0 € / Monat
10 Monitore für Websites und APIs, Prüfungen aus zwei Regionen und eine Statusseite. Erkenne Ausfälle und halte deine Kunden auf dem Laufenden.
Ohne Zeitlimit. Ohne Kreditkarte. Prüfungen alle 5 Minuten.
Perstats eigener StatusStatusseiteLege einen HTTP-Monitor für deine Website oder API an. Wähle Regionen und Intervall passend zum Tarif.
Aktiviere Push auf deinem iPhone oder wähle einen vorhandenen Connector. Persönliche SMS gibt es ab Pulse, Rufbereitschaft mit Anrufen ab Sentinel.
Lass einen eigenen Test-Endpunkt kontrolliert fehlschlagen. Warte auf den bestätigten Ausfall und prüfe den Alarm. Stelle danach den Endpunkt wieder her.
Die Schaltfläche „Testen“ prüft nur den Check. Sie erzeugt keinen gespeicherten Incident und ersetzt diesen Alarmtest nicht. Verwende einen Testdienst, keinen Kundendienst.
Ein Check schlägt fehl. Beim erreichten Quorum öffnet Perstat einen Incident. Ein Mensch übernimmt; nach bestätigter Erholung schließt der Incident. Automatische Incidents und Quittierung sind in jedem Tarif enthalten. Rufbereitschaft mit SMS und Anrufen beginnt bei Sentinel für 89 € netto im Monat.
Anleitung öffnenBeispiel: zehn Kunden, je ein Projekt und eine Statusseite unter eigener Domain. Sentinel enthält fünf Seiten; fünf zusätzliche Seiten ergeben 89 € + 5 × 9 € = 134 € netto pro Monat. White-Label erfordert Command für 249 € mit bis zu 20 Seiten.
Projekte sind keine eigene Kundenkonsole. HTTP-Inhaltschecks prüfen eine Anfrage, keinen kompletten Browser-Kaufweg oder alle Bilder einer Website.
Anleitung öffnenLege einen Heartbeat an, kopiere seine geheime Ping-URL und sende den ersten Ping. Melde danach nur echte Erfolge als Erfolg, Fehler an die Failure-URL. Für den Alarmtest lasse einen Testjob nach dem ersten Ping ausbleiben.
if /path/to/job.sh; then
  curl --fail --silent --show-error "$PERSTAT_PING_URL"
else
  curl --fail --silent --show-error "$PERSTAT_PING_URL/fail"
  exit 1
fi
Free enthält zwei Heartbeats. Das Signal bestätigt eine Meldung des Jobs, keine erfolgreiche Wiederherstellung eines Backups.
Anleitung öffnenVier öffentliche Vorfallsberichte zeigen, warum sich der Blick von außen lohnt.
Prüfen Sie die Erreichbarkeit außerhalb Ihrer eigenen Plattform.
Google Cloud
Beim Cloud-Ausfall fielen auch Monitoring-Systeme mancher Kunden aus.
Ein Check der Kunden-URL liefert ein eigenes Ausfallsignal.
Atlassian
Das erste Kundenticket kam 8 Minuten nach Beginn des Ausfalls.
DNS-Checks zeigen, wenn der Domainname nicht mehr aufgelöst wird.
Marketo
Ein DNS-Problem machte die Anmeldeseite unerreichbar.
Ein Heartbeat meldet, wenn ein erwartetes Erfolgssignal ausbleibt.
GitLab
Backup-Jobs scheiterten, ihre Fehler-E-Mails wurden abgewiesen.
Perstat deckt die Kette vom fehlschlagenden Check bis zum Nachweis ab. Eine Observability-Suite ist es bewusst nicht.
Statt UptimeRobot, Pingdom oder der Uptime-Checks einer größeren Suite: 13 Checktypen aus benannten Regionen.
Statt Atlassian Statuspage: öffentliche oder geschützte Seiten, gespeist aus denselben Monitoren und Incidents.
Statt des Uptime-Teils von Opsgenie oder PagerDuty: Quittieren am Telefon, dazu Bereitschaftspläne und Eskalation.
Logs, Traces, APM und Alarme anderer Werkzeuge bleiben, wo sie sind. Perstat nimmt sie nicht auf.
Der MCP-Endpunkt, der Monitore anlegt, bedient auch Agenten und Skripte. Jeder Schreibzugriff wird der Person zugerechnet, die den Schlüssel angelegt hat, und Perstat prüft bei jedem Aufruf deren aktuelle Rolle.
MCP-Dokumentation lesencreate_projectProjekt anlegencreate_monitorMonitor anlegenupdate_monitorName, Einstellungen, Intervall oder Regionen bearbeitenset_monitor_enabledMonitor pausieren oder fortsetzenarchive_monitorMonitor archivieren und sein Kontingent im Tarif freigebenrestore_monitorArchivierten Monitor wiederherstellen, pausiertacknowledge_incidentIncident quittierenresolve_incidentIncident schließendelete_monitorDie Apps zeigen Alarme im Vollbild, lassen Sie per Wisch quittieren und legen den offenen Incident als Live-Aktivität auf den Sperrbildschirm. Eine native Android-App gibt es nicht, aber SMS ab Pulse und Anrufe der Rufbereitschaft ab Sentinel erreichen jedes Telefon.
Im App Store ansehenFree kostet 0 € im Monat und bleibt ohne Zeitlimit nutzbar. Mehr Monitore und zusätzliche Funktionen buchen Sie, wenn Sie sie brauchen.
0 € im Monat. 10 Monitore, zwei Heartbeats und eine Statusseite. Automatische Incidents und Quittierung inklusive.
Persönliche SMS, 50 Monitore und drei Plätze. 29 € netto/Monat.
Rotationen, SMS und Anrufe, 150 Monitore und 15 Plätze. 89 € netto/Monat.
Eigene Statusdomains ab 89 €, White-Label ab 249 € netto/Monat. Seitenkontingente beachten.
Seitlich wischen, um alle Tarife zu vergleichen
| Was sich je Tarif ändert | Free0 €/ MonatDauerhaft kostenlos | Pulse29 €/ Monat | Sentinel89 €/ Monat | Command249 €/ Monat | Enterpriseab 690 €/ Monat |
|---|---|---|---|---|---|
| Monitore | 10 | 50 | 150 | 500 | individuell |
| Plätze | 1 | 3 | 15 | 30 | individuell |
| Kürzestes Intervall | 300 s | 60 s | 30 s | 15 s | 10 s |
| Prüfregionen | 2 von 6 | 3 von 6 | alle 6 | alle 6 | alle 6 |
| Öffentliche Historie* | 7 Tage | 30 Tage | 90 Tage | 1 Jahr | 2 Jahre |
| Statusseiten | 1 | 1 | 5 | 20 | individuell |
| Rufbereitschaft, manuelle Incidents, Post-mortems | nein | nein | enthalten | enthalten | enthalten |
Preise pro Monat in EUR, netto, zuzüglich Umsatzsteuer. Enterprise beginnt beim angezeigten Betrag. *Diese Werte begrenzen die öffentliche Historie geschlossener Incidents. Andere Datenobjekte folgen derzeit eigenen Speicher- und Löschregeln. Prüfen Sie vor der Beschaffung die dokumentierten Grenzen der Aufbewahrung.
Betrieben von der Datargo GmbH in Deutschland.
Prüfstandorte werden mit Namen genannt, statt hinter einer Weltkarte zu verschwinden.
Produktaufnahmen, die öffentliche Statusseite, der Beispielreport und die aktuellen Beschaffungsgrenzen sind ohne Login einsehbar.
Ein beispielhafter Agenten-Dialog zeigt die Einrichtung. Die Perstat-Bilder zeigen echte Produktoberflächen mit Beispieldaten, keine Aufnahme dieses Dialogs.
Ihre Website oder API geht live. Beauftragen Sie Ihren angebundenen Coding-Agenten mit dem Monitoring, ohne ein zweites Einrichtungsformular zu öffnen.
Das Beispiel setzt eine bestehende Perstat-Verbindung und Schreibrechte für dieses Projekt voraus.
Uptime-Monitoring ansehenDer Agent kann über MCP einen URL-Monitor anlegen oder einen vorhandenen bearbeiten. Er bestätigt die Einrichtung im Dialog.
Angelegt bedeutet noch nicht erfolgreich geprüft. Intervall und Regionen hängen vom Tarif ab.
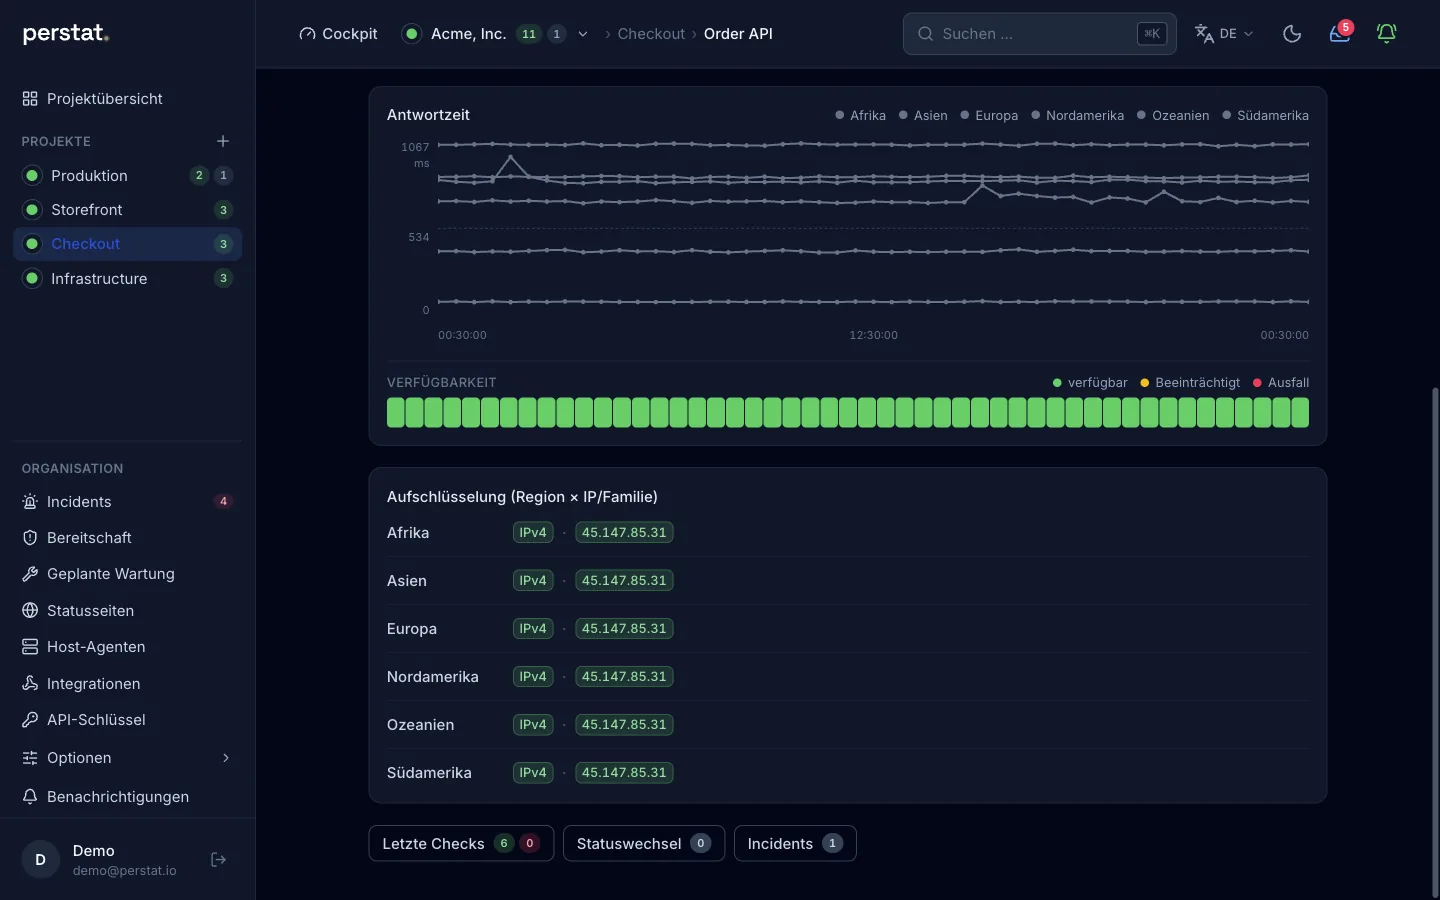
Uptime-Monitoring ansehenPerstat prüft die URL von außen. Ergebnisse und Antwortzeiten erscheinen im Monitor, auch wenn Sie den Coding-Agenten schließen.
Ein erfolgreicher HTTP-Check prüft den konfigurierten Endpunkt. Er testet keinen vollständigen Bestellablauf.
Uptime-Monitoring ansehen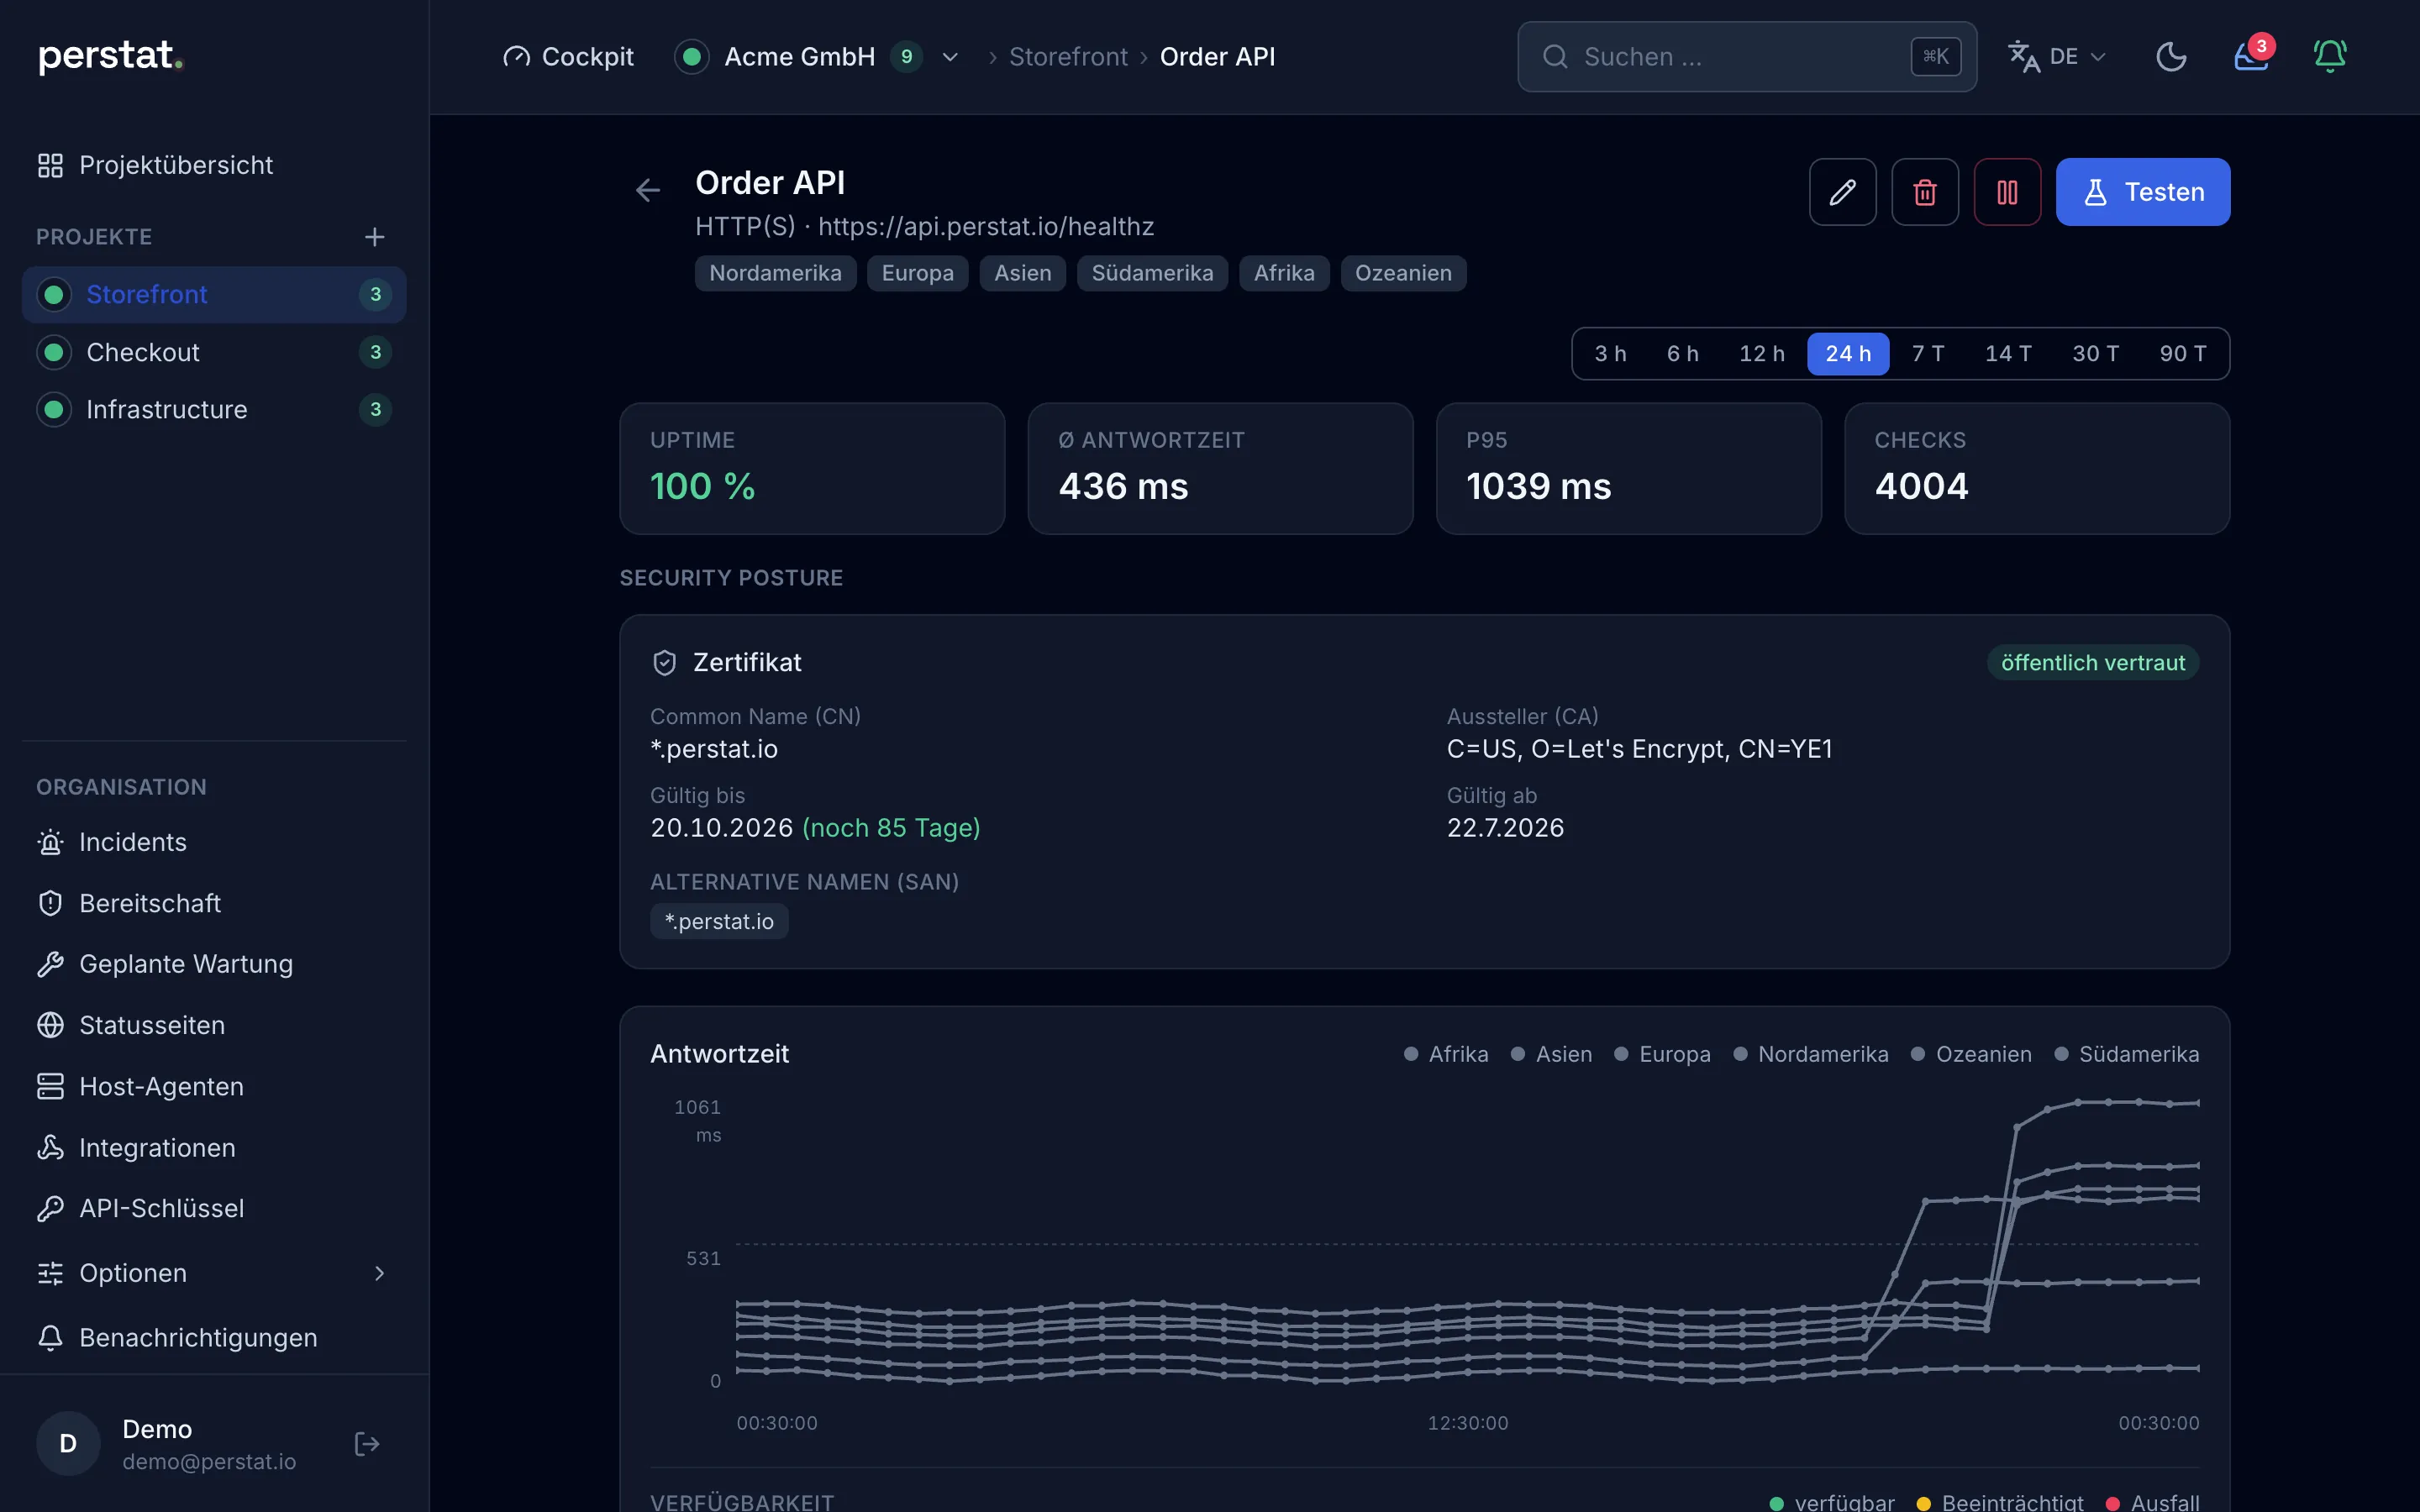
Sind die eingestellten Fehlerbedingungen erfüllt, öffnet Perstat einen Incident und benachrichtigt Sie über die eingerichteten Kanäle.
Regionale Checks benötigen standardmäßig die Bestätigung aus zwei Regionen. Das Quittieren eines Alarms behebt den Ausfall nicht.
Uptime-Monitoring ansehen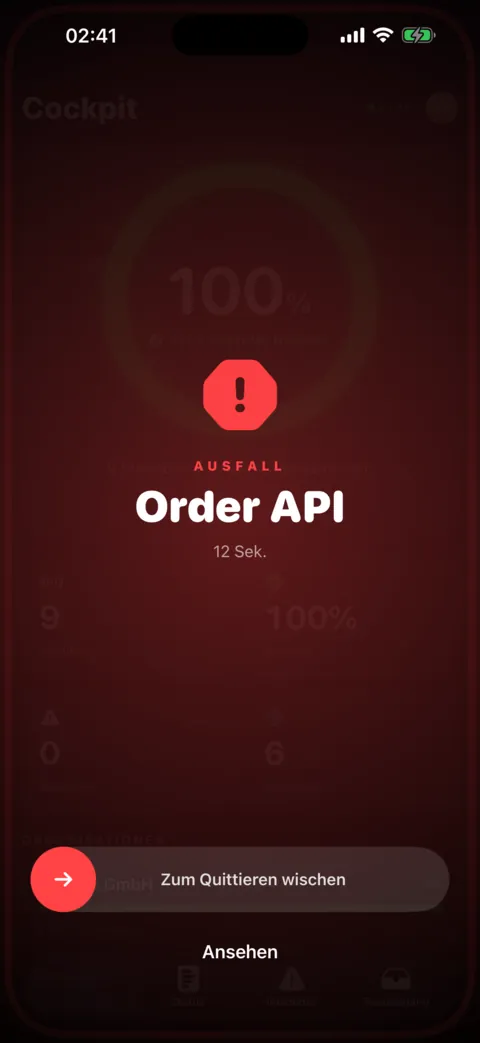
Ein Job kann ausbleiben, obwohl sein Server antwortet. Ein Heartbeat meldet Perstat, wann dieser Job ausgeführt wurde.
Das Beispiel zeigt einen stündlichen Bericht. Derselbe Ablauf eignet sich zur Überwachung eines Backup-Jobs.
Heartbeat-Monitoring ansehenLegen Sie den Heartbeat an und hinterlegen Sie seine geheime Ping-Adresse im Job. Senden Sie das Erfolgssignal nach erfolgreichem Abschluss.
Die Adresse bleibt geheim. Die MCP-Unterstützung hängt vom angebundenen Server und Client ab.
Heartbeat-Monitoring ansehenFühren Sie den Job aus und prüfen Sie den Signaleingang in Perstat. Weitere Läufe melden sich nach demselben Zeitplan.
Ein Backup-Heartbeat bestätigt die Job-Meldung. Er prüft nicht, ob das Backup wiederherstellbar ist.
Heartbeat-Monitoring ansehenBleibt das nächste Signal über Intervall und Toleranz hinaus aus, kann Perstat einen Incident öffnen und die eingerichteten Empfänger benachrichtigen.
Heartbeats richten sich nach dem Job-Zeitplan. Sie verwenden kein regionales Quorum.
Heartbeat-Monitoring ansehenAPI und MCP sind zusätzliche Einrichtungswege. Der Ablauf unten zeigt ein gekennzeichnetes Beispiel.
Ablauf überspringenorder-api 2.16.0 bringt einen Payments-Webhook mit. Von den letzten 8 Deploys haben 3 einen Endpunkt, einen Job oder einen Dienst ohne Monitor ausgeliefert, weil das Anlegen ein eigener Arbeitsschritt war.
09-10 11:47search-indexer 1.9.3worker poolüberwacht09-09 09:15auth-service 3.1.1token rotationüberwacht09-08 10:05mail-relay 1.4.2patchüberwacht09-05 15:30order-api 2.15.4patchüberwacht09-05 08:12status-sync 0.3.0cron jobüberwacht3 von 8 Deploys brachten etwas ohne Monitor
Ein Schritt nach dem Release-Job legt den Monitor über die REST-API an. Der API-Schlüssel der Organisation braucht monitors:write und Zugriff auf das Projekt. HTTP-Fehler lassen den Job scheitern.
# nach dem Release-Job: Monitor anlegen
- name: Register monitor
  run: |
    curl --silent --show-error --fail-with-body \
      "https://api.perstat.io/projects/$PERSTAT_PROJECT_ID/monitors" \
      --header "Authorization: Bearer $PERSTAT_API_KEY" \
      --header "Content-Type: application/json" \
      --data '{
        "name": "Order API", "type": "http",
        "config": {"url": "https://orders.example.com/health"},
        "interval_seconds": 300,
        "regions": ["na", "eu", "as", "sa", "af", "oce"]
}'Die API liefert den Monitor mit seiner ID zurück. Speichern Sie die ID und ändern Sie den Monitor später mit PATCH. Erneutes Anlegen unter demselben Namen meldet einen Konflikt und gilt nicht stillschweigend als Erfolg.
{
  "id": "mon_…",
  "name": "Order API",
  "type": "http",
  "enabled": true,
  "interval_seconds": 300,
  "regions": [
    "na",
    "eu",
    "as",
    "sa",
    "af",
    "oce"
  ]
}Die gespeicherte Monitor-ID mit PATCH /monitors/{monitor_id} aktualisieren.
Prüfpunkte auf 6 Kontinenten führen den Check in seinem Intervall aus. Perstat speichert jedes Ergebnis mit der Region, die es gemessen hat.
naNordamerikasaSüdamerikaeuEuropaafAfrikaasAsienoceOzeanienEin Fehler in einer Region ist ein leiser Hinweis, noch kein Alarm. Meldet auch eine zweite Region einen Fehler, bestätigt das Standard-Quorum den Ausfall und öffnet genau einen Incident.
naewrNewarkOKFehlersagruSão PauloOKeufraFrankfurtOKafjnbJohannesburgOKassgpSingapurOKFehlerocesydSydneyOKna (Newark) meldet einen Fehler: leiser Hinweis, noch wird niemand alarmiert.
Auch as (Singapur) meldet einen Fehler: Quorum erreicht, Incident geöffnet um 02:41:12 UTC.
Perstat alarmiert iPhone und Apple Watch, über Connectoren auch Slack, Teams oder PagerDuty. Die Eskalation der Rufbereitschaft geht per SMS und Anruf weiter, bis jemand quittiert.
Eskalation der Rufbereitschaft: ab Sentinel
Persönliche SMS-Alarme ohne Rufbereitschaft: ab Pulse
acknowledge_incidentOder aus dem Terminal: Ihr Agent ruft acknowledge_incident über MCP auf, zugerechnet der Person, der der Schlüssel gehört.
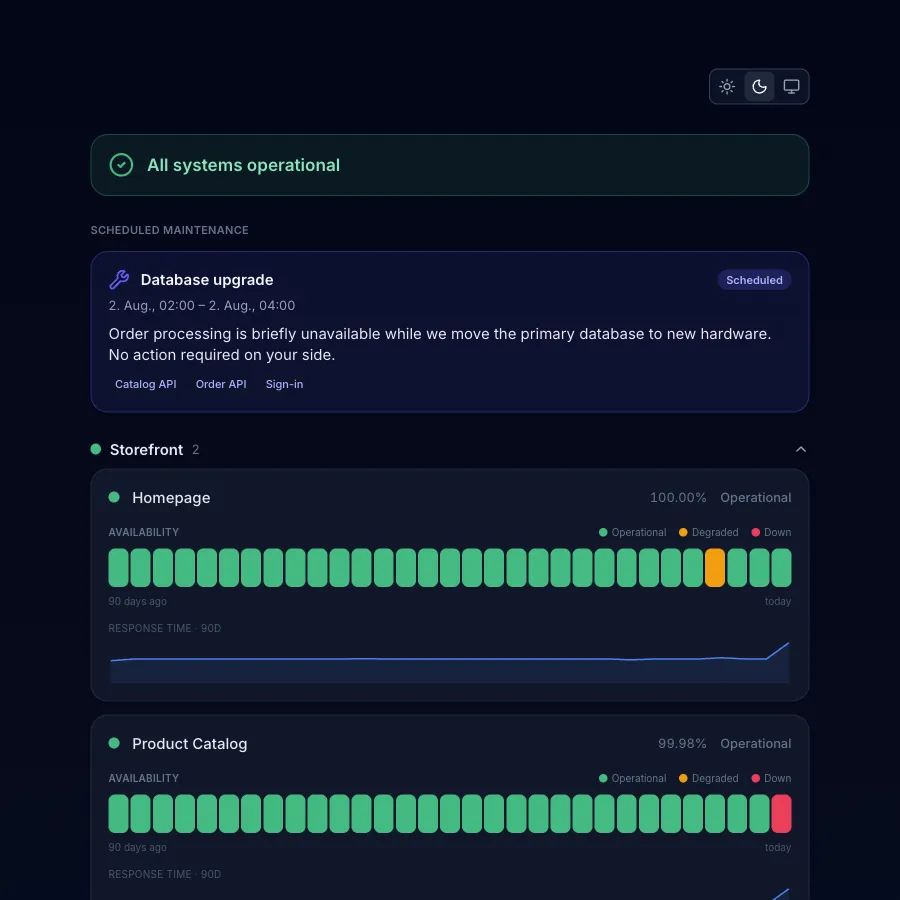
Der vom Quorum geöffnete Incident erscheint mit seiner aktuellen Phase auf der verknüpften Statusseite, und die Komponente wechselt auf Down. Niemand muss ihn von Hand übertragen.
02:41:12 UTCMelden die Regionen die Wiederherstellung, schließt der Incident mit bestätigtem Beginn, Ende und Dauer. Angekündigte Wartung wird für ihr Fenster ausgeschlossen. Perstat berechnet die Verfügbarkeit aus derselben Aufzeichnung.
Order APIQ2 20262026-05-03 02:41:12Incident, per Quorum bestätigt00:07:122026-05-17 22:00:00Wartung, angekündigt und ausgeschlossen01:30:00Export: PDF-Report je Monitor für 7 bis 90 Tage. CSV mit Manifest auf Anfrage.
Ihre Statusseite unter Ihrer eigenen Domain zeigt den Zustand, etwa dieses geplante Datenbank-Upgrade. Die Seite und das Badge auf Ihrer Website lesen aus der Aufzeichnung hinter der Verfügbarkeitszahl.
Eigene Domain: ab Sentinel

<img src="https://status.example.com/badge.svg" alt="Service status">
Dasselbe Badge auf Ihrer Website, ausgeliefert unter Ihrer Domain. Es zeigt, was die Seite zeigt.Starte mit einer Website oder API. Free enthält 10 Monitore, zwei Prüfregionen und eine Statusseite, ohne Kreditkarte und ohne Zeitlimit.
