Auf dieser Seite
Was er prüft
Ein Heartbeat-Monitor prüft, ob ein Job gelaufen ist, wenn er laufen sollte. Beim Anlegen des Monitors entsteht eine geheime URL, und der Job ruft sie am Ende jedes Laufs auf. Etwa alle 30 s vergleicht die Control Plane das Alter des letzten Pings mit der erwarteten Periode plus Toleranz. Ein älterer Ping oder ein letzter Ping auf die Failure-URL ist ein Verstoß. Bis der erste Ping eintrifft, ist der Monitor ausstehend, nicht ausgefallen.
Wann Sie ihn einsetzen
- Ein geplanter Job hat keine Adresse, die sich prüfen ließe: ein Cronlauf, ein nächtliches Backup, ein Importer oder ein Worker, der pünktlich fertig sein muss.
- Der Fehler, den Sie sehen müssen, ist, dass etwas nicht passiert ist. Ein Job, der nie gestartet ist, hinterlässt nichts Kaputtes, das ein Prüfpunkt erreichen könnte.
- Der Job kann seinen eigenen Lauf beurteilen. Er ruft nach Erfolg die Ping-URL auf und die Failure-URL, wenn seine eigenen Prüfungen fehlschlagen. Der Monitor wechselt dann bei der nächsten Bewertung auf ausgefallen, ohne den Zeitplan abzuwarten.
Der Check zeichnet nur auf, wann der Aufruf eintrifft. Ein Dienst, der auf einem Port lauscht, braucht den HTTP(S)- oder TCP-Check. Für CPU, Speicher, Platte und Prozesse des Hosts selbst gibt es den Host-Agent-Check.
Konfiguration
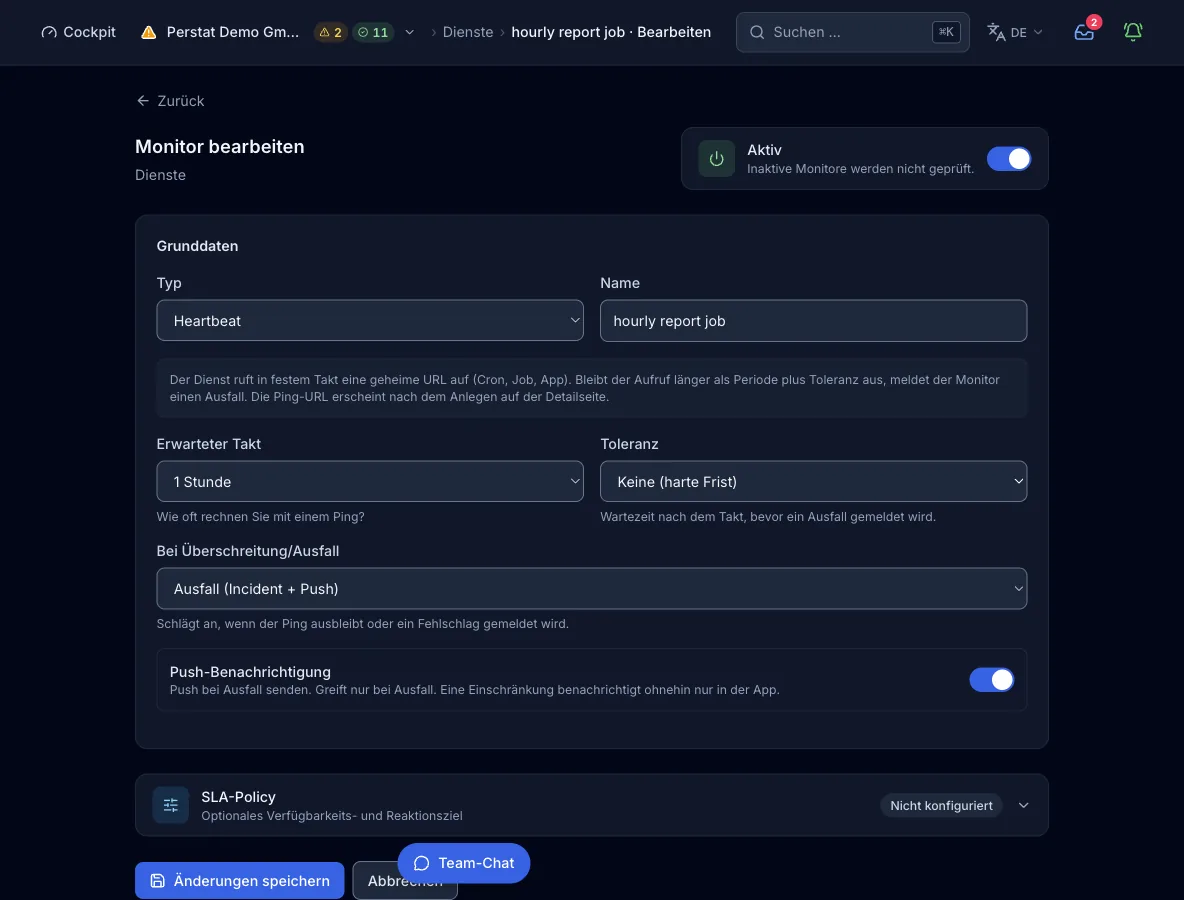
Ziel. Keines. Ein Heartbeat hat kein Ziel, keine Prüfregionen, keine IP-Familien und kein eigenes Prüfintervall. Das Formular blendet diese Felder aus, und die Control Plane bewertet den Monitor etwa alle 30 s unter der Pseudo-Region heartbeat. Beim Anlegen des Monitors entsteht die geheime URL https://api.perstat.io/ping/{token}; die Monitoransicht zeigt sie zusammen mit der Failure-URL (/fail angehängt).
| Feld | Pflicht | Werte und Voreinstellung | Bedeutung |
|---|---|---|---|
period_secondsErwartet alle | optional | Sekunden, 30 bis 2.592.000 (30 Tage), Voreinstellung 3600 | Wie oft der Job pingen soll. Das Formular bietet Vorgaben, und die API normalisiert jede Sekundenzahl in den Bereich. |
grace_secondsToleranzzeit | optional | Sekunden, 0 bis 86.400 (24 h). Voreinstellung: ein Fünftel der Periode, begrenzt auf 60 bis 3600 | Wie lange ein Ping nach Ablauf der Periode noch eintreffen darf, bevor der Monitor einen Verstoß wertet. Der Wert 0 setzt eine harte Frist. Setzen Sie die Toleranz auf einen echten Bruchteil der Periode, denn ein nächtliches Backup mit 60 s Toleranz alarmiert in jeder langsamen Nacht. |
breach_severityBei Verstoß / Ausfall | optional | critical (Voreinstellung) oder degraded | critical setzt den Monitor auf ausgefallen und öffnet einen Incident, mit Push gemäß notify_push. degraded setzt ihn auf eingeschränkt, nur mit In-App-Hinweis, und jeder andere Wert wird als critical gespeichert. |
notify_pushPush-Benachrichtigung | optional | true (Voreinstellung) oder false | Sendet bei einem Ausfall mit critical eine Push-Benachrichtigung. Ein eingeschränkter Verstoß benachrichtigt ohnehin in der App. |
So läuft ein Check ab
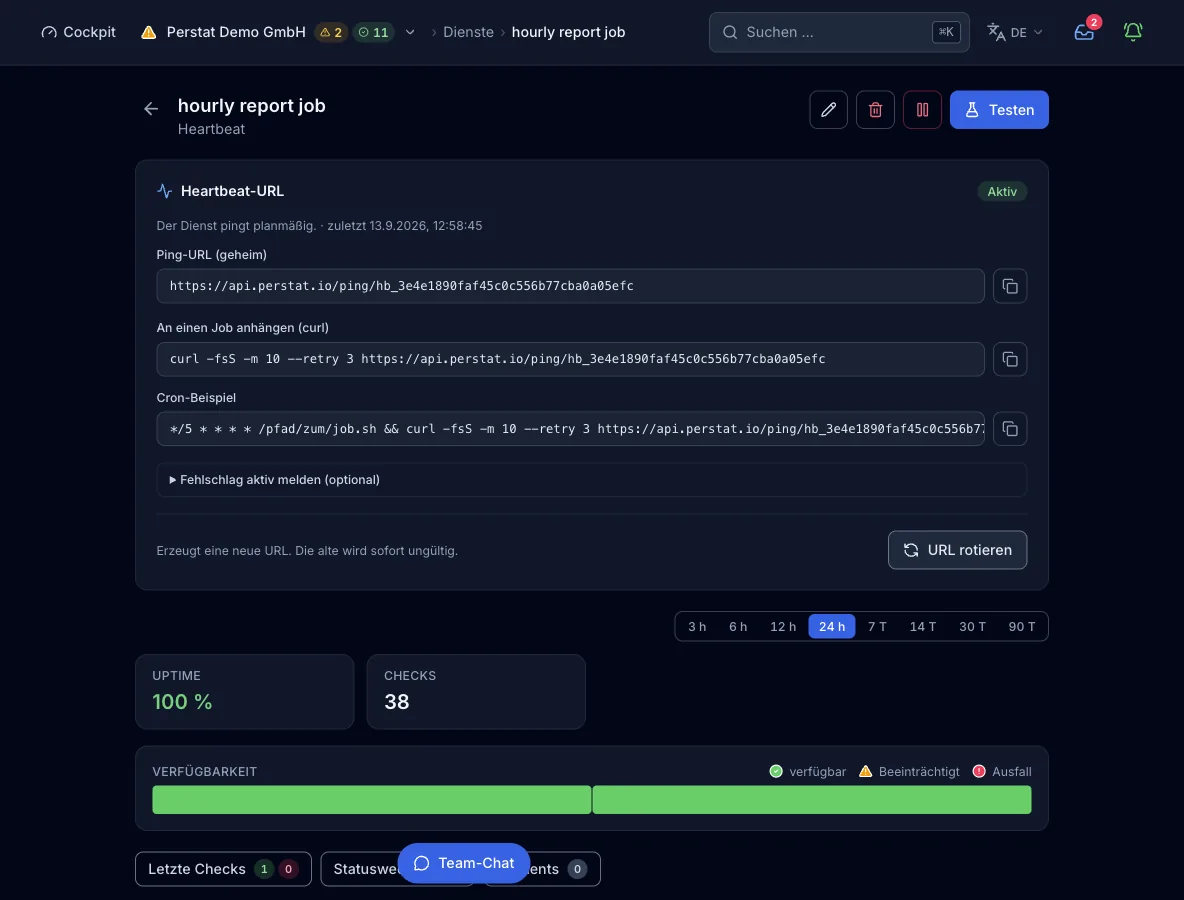
- Beim Anlegen des Monitors entsteht das Token, und die Monitoransicht zeigt Ping-URL und Failure-URL. Binden Sie die Ping-URL in den Job ein, zum Beispiel als letzten Befehl der Cron-Zeile.
- Der Job ruft die Ping-URL per GET oder POST auf, wenn ein Lauf fertig ist. Stuft sich der Lauf als fehlgeschlagen ein, ruft der Job stattdessen die Failure-URL auf.
- Etwa alle 30 s bewertet die Control Plane den Monitor. Bis zum ersten Ping bleibt er ausstehend, und kein Ergebnis wird geschrieben.
- Ein letzter Ping auf die Failure-URL ist ein Verstoß. Dasselbe gilt für einen letzten Ping, der älter ist als Periode plus Toleranz.
- Ein Verstoß nimmt die konfigurierte Schwere an.
criticalsetzt den Monitor auf ausgefallen und öffnet einen Incident, mit Push, wenn aktiviert.degradedsetzt ihn auf eingeschränkt, nur mit In-App-Hinweis. Alarm und Erholung liegen fest bei je 1 Check, deshalb schließt der nächste gesunde Ping den Incident bei der nächsten Bewertung. - Die Schaltfläche Testen führt dieselbe Bewertung auf Abruf aus und zeigt das Ergebnis nur Ihnen. Nichts wird gespeichert, und kein Incident wird geöffnet.
Was ein Ergebnis enthält
- Zustand und Schwere
- Bestanden, fehlgeschlagen oder eingeschränkt, mit Schwere ok, degraded oder critical. Ein Heartbeat, der nie gepingt hat, zeigt ausstehend.
- Detailzeile
- Eine Zeile, die sagt, was passiert ist. Sie meldet einen aktuellen Heartbeat mit dem Alter des letzten Pings, keinen Heartbeat seit N Sekunden gegen erwartete Periode und Toleranz oder einen Fehlschlag, den der Job gemeldet hat.
- Letzter Ping
- Das Heartbeat-Feld der Monitoransicht zeigt den Zeitpunkt des letzten Pings. Er steht in der Statuszeile über der Ping-URL, neben der Kennzeichnung Aktiv oder Wartend. Ob dieser Ping gesund oder ein Fehlschlag war, meldet die Detailzeile der nächsten Bewertung, nicht das Feld.
- Region
- Jedes Ergebnis trägt die Pseudo-Region
heartbeat. Es gibt keine Latenz, keinen Antwortcode und kein Teilergebnis.
Zustände und Schwere
- okDer letzte Ping kam innerhalb von Periode plus Toleranz an und war ein gesunder Ping.
- eingeschränktEin Verstoß mit
breach_severityaufdegraded. Er löst einen In-App-Hinweis aus, ohne Incident und ohne Push. - ausgefallenEin Verstoß bei der voreingestellten Schwere
critical: Der letzte Ping ist älter als Periode plus Toleranz, oder der Job hat die Failure-URL aufgerufen. Der Verstoß öffnet einen Incident, mit Push gemäßnotify_push. - ausstehendNoch kein Ping eingetroffen. Der Monitor zeigt ausstehend, bis der Job die URL zum ersten Mal aufruft.
Das Signal kommt von Ihrem Host oder Ihrem Job, ohne Regionen und ohne Quorum. Deshalb zählt schon eine ausgebliebene Meldung. Die Control Plane bewertet etwa alle 30 s, mit Alarm und Erholung fest bei je 1 Check. Ein Verstoß wird bei der nächsten Bewertung nach Ablauf von Periode plus Toleranz zum Incident.
Tarife und Grenzen
- Bewertungsintervall
- Etwa 30 s in jedem Tarif, vom Server gesetzt. Die Untergrenze des Intervalls gilt nur für regionale Checktypen.
- Regionen
- Keine. Der Job meldet sich, und nichts wird geprüft, deshalb gilt die Regionszahl des Tarifs nicht.
- Heartbeats
- 2 in Free, 10 in Pulse, 50 in Sentinel und 200 in Command. In Enterprise gelten individuelle Kontingente. Heartbeats haben ein eigenes Kontingent und belegen kein Kontingent regionaler Monitore. Ein Paket mit 25 weiteren kostet 9 €.
Aus der Pipeline oder von einem Agenten
Dieselbe config gilt im Deploy-Schritt, in einem MCP-Client wie Claude Code und im Formular oben. create_monitor braucht einen API-Schlüssel für die ganze Organisation. Wenn Sie regions weglassen, wählt der Tarif seine Voreinstellung.
{
  "name": "Nightly backup",
  "type": "heartbeat",
  "config": {
    "period_seconds": 86400,
    "grace_seconds": 1800,
    "breach_severity": "critical",
    "notify_push": true
  }
}
Jede Schnittstelle mit ihrer Grenze
Grenzen
- Gemessen wird nur der Zeitpunkt des Aufrufs, ohne Laufzeit, ohne Exit-Code und ohne Nutzdaten.
- Bis zum ersten Ping ist der Monitor ausstehend. Ein Heartbeat, den kein Job aufruft, sieht aus wie Abdeckung und ist keine.
- Die Ping-URL verlangt keine Authentifizierung, deshalb kann jeder pingen, der das Token hat. Behandeln Sie sie wie Zugangsdaten. Wird sie bekannt, rotieren Sie sie in der Monitoransicht, und die alte URL funktioniert sofort nicht mehr.
- Der Ping-Endpunkt nimmt 240 Anfragen je 60 s und Quell-IP an. Ein unbekanntes Token bekommt 404.
- Eine Anfrage zum Anlegen über die API oder MCP gibt die Ping-URL nicht zurück. Lesen Sie sie in der Monitoransicht ab und binden Sie sie in den Job ein.
- Die Bewertung läuft etwa alle 30 s, ein Verstoß fällt also bis zu etwa 30 s nach Ablauf von Periode plus Toleranz auf.