Auf dieser Seite
Ein Weg für Dienste, Netze, Hosts und Jobs
Jeder Tarif enthält 13 Checktypen: HTTP, HTTP-Header, TCP, DNS, DNS-Hygiene, Domain, TLS-Zertifikat, SMTP, IMAP, Ping, Traceroute, Agent und Heartbeat. Sie decken von außen erreichbare Dienste ab, dazu Signale eines Hosts und Jobs, die ihr Ergebnis selbst melden. Jedes Ergebnis folgt einem Monitor und einem Incident-Pfad, statt auf getrennte Werkzeuge verteilt zu sein.
Perstat beschränkt sich bewusst auf Uptime und die Aufzeichnung, die daraus entsteht. Es ist kein APM und verwaltet keine Logs.
Vom einzelnen Ergebnis zum bestätigten Incident
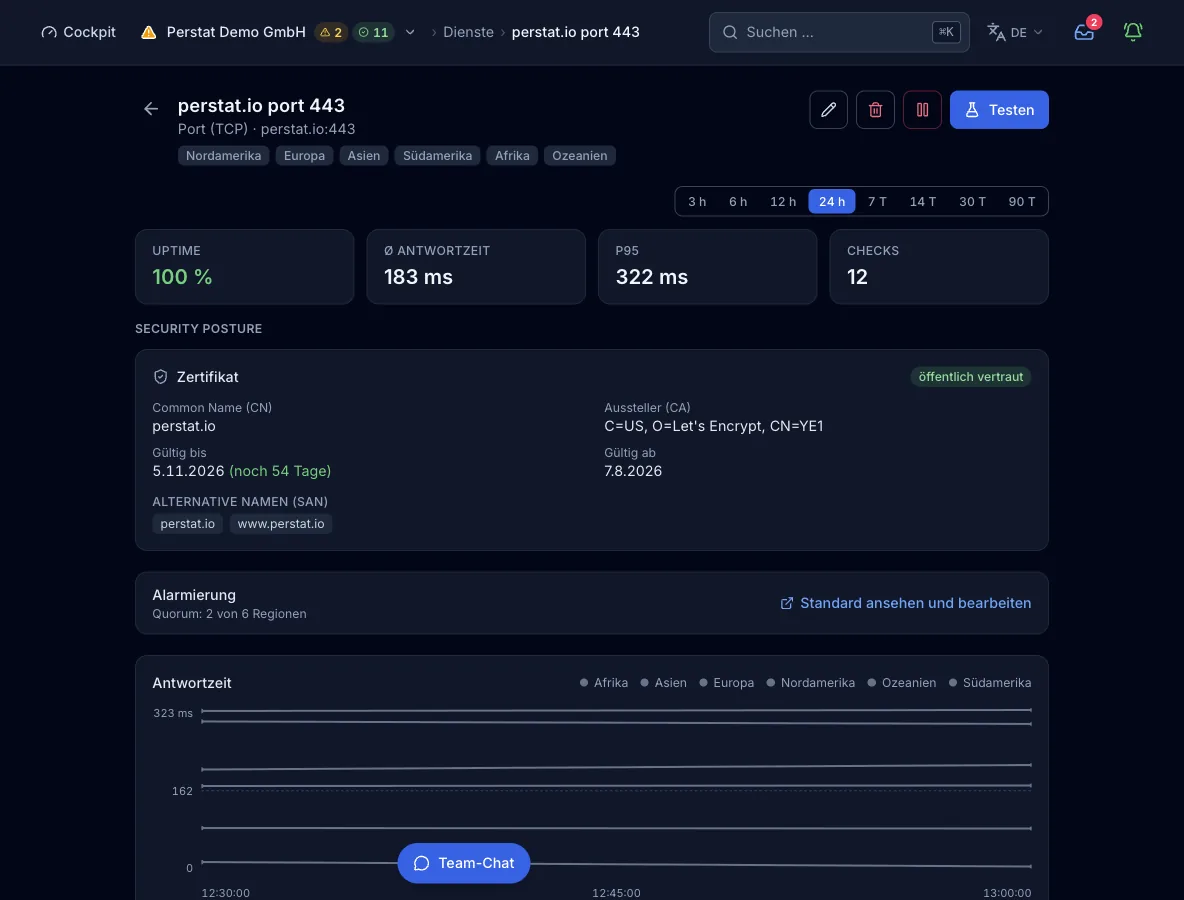
Elf Checktypen laufen über regionale Prüfpunkte. Nach der Standardregel öffnet eine einzelne Region keinen Incident. Der Monitor braucht ein Quorum von 2 Regionen, und diese Regel ist konfigurierbar.
Agent und Heartbeat sind die beiden Ausnahmen. Sie melden direkt und nutzen weder Prüfregionen noch ein regionales Quorum.
Die Quorum-Dokumentation beschreibt beide Wege. Die Seite zum Prüfnetz dokumentiert die aktuelle Topologie und die regionale Zusammenfassung.
Das Signal sehen, bevor jemand alarmiert wird
Perstat zeigt einen sich anbahnenden Zustand an, bevor die konfigurierte Regel einen regionalen Ausfall bestätigt. Die Beobachtungsliste hält Abweichungen einzelner Regionen, IP-Familien, IP-Adressen und Knoten fest. So erhält der Betrieb ein frühes Signal, ohne die erste Abweichung als Incident zu behandeln.
Bestätigte Ergebnisse behalten außerdem ihren Diagnosekontext. Wo es zutrifft, weist Perstat die DNS-Zeit getrennt aus und ordnet einen Fehler einer dieser Ebenen zu:
- Zielanwendung
- Ziel-DNS
- Netz
- Perstat-Resolver
- Prüfpunkt
HTTP, Netz und DNS bleiben prüfbar
Ein HTTP-Monitor kann einen erwarteten Status, ein Stichwort oder einen regulären Ausdruck prüfen. Derselbe Monitor kann Subchecks für TLS, Security-Header und DNS-Hygiene mitführen. Perstat folgt Weiterleitungen über höchstens 5 Sprünge und prüft jedes Ziel in der Kette gegen dieselbe SSRF-Blockliste.
Checks über A- und AAAA-Records behalten ihre Ergebnisse je Adressfamilie und IP. Ein DNS-Monitor kann seine Antwortmenge mit einem anderen Monitor vergleichen, als identische Menge, Teilmenge oder Überschneidung.
Hosts und Jobs melden direkt
Der native Host-Agent unterstützt Linux auf x86_64 und aarch64 sowie macOS als Universal Binary. Er meldet Verfügbarkeit und benannte Dienste, dazu CPU, Arbeitsspeicher und Datenträger.
Der Agent liest keine Kommandozeilen, Umgebungsvariablen oder Benutzernamen. Er hat keinen Kanal für entfernte Befehle. Windows wird derzeit nicht unterstützt.
Ein Heartbeat gibt einem Job zwei Endpunkte: einen für erfolgreiche Läufe und einen für Fehlschläge. Bleibt der Job länger stumm als die konfigurierte Periode plus Toleranz, gilt der Heartbeat als ausgefallen. Der Endpunkt für Fehlschläge meldet einen ausdrücklich fehlgeschlagenen Lauf, ohne dieses Schweigen abzuwarten.
Wartung unterdrückt Alarme und bleibt in der Historie
Ein geplantes Wartungsfenster unterdrückt neue Incidents, bleibt in der Verfügbarkeitsaufzeichnung und zählt nicht zur Uptime. Ein verworfener Fehlalarm erzeugt ein eigenes, umkehrbares Ausschlussfenster mit Begründung und Urheber. Die Seite zur Verfügbarkeitsaufzeichnung erklärt diesen Prüfpfad.
Einen echten Monitor ansehen
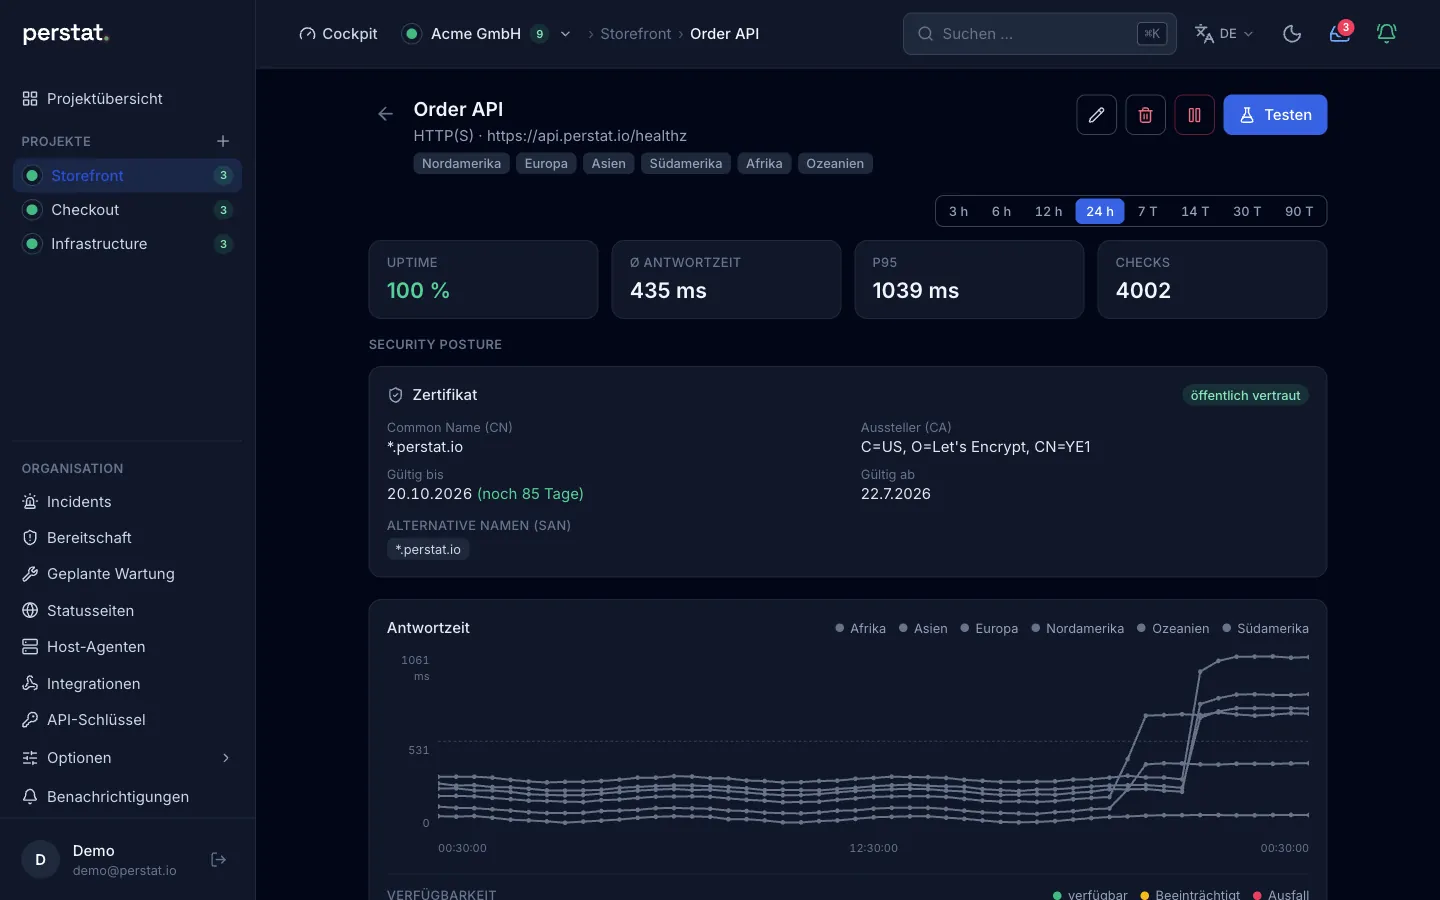
Der Tarif bestimmt Prüfregionen und kürzestes Intervall
| Tarif | Prüfregionen | Kürzestes Intervall (Sekunden) |
|---|---|---|
| Free | 2 | 300 |
| Pulse | 3 | 60 |
| Sentinel | 6 | 30 |
| Command | 6 | 15 |
| Enterprise | 6 | 10 |
Das Webformular bietet 30 Sekunden und länger. In Command und Enterprise stellen Sie 15 oder 10 Sekunden über MCP ein.
Die Prüfregionen sind:
- Nordamerika
- Südamerika
- Europa
- Afrika
- Asien
- Ozeanien
Die genauen Grenzen für Monitore, Agenten, Heartbeats und Aufbewahrung stehen auf der Preisseite.
Beginnen Sie kostenlos mit dem Monitoring, oder konfigurieren Sie den ersten Monitor mit der Monitor-Dokumentation.