Introduce una dirección
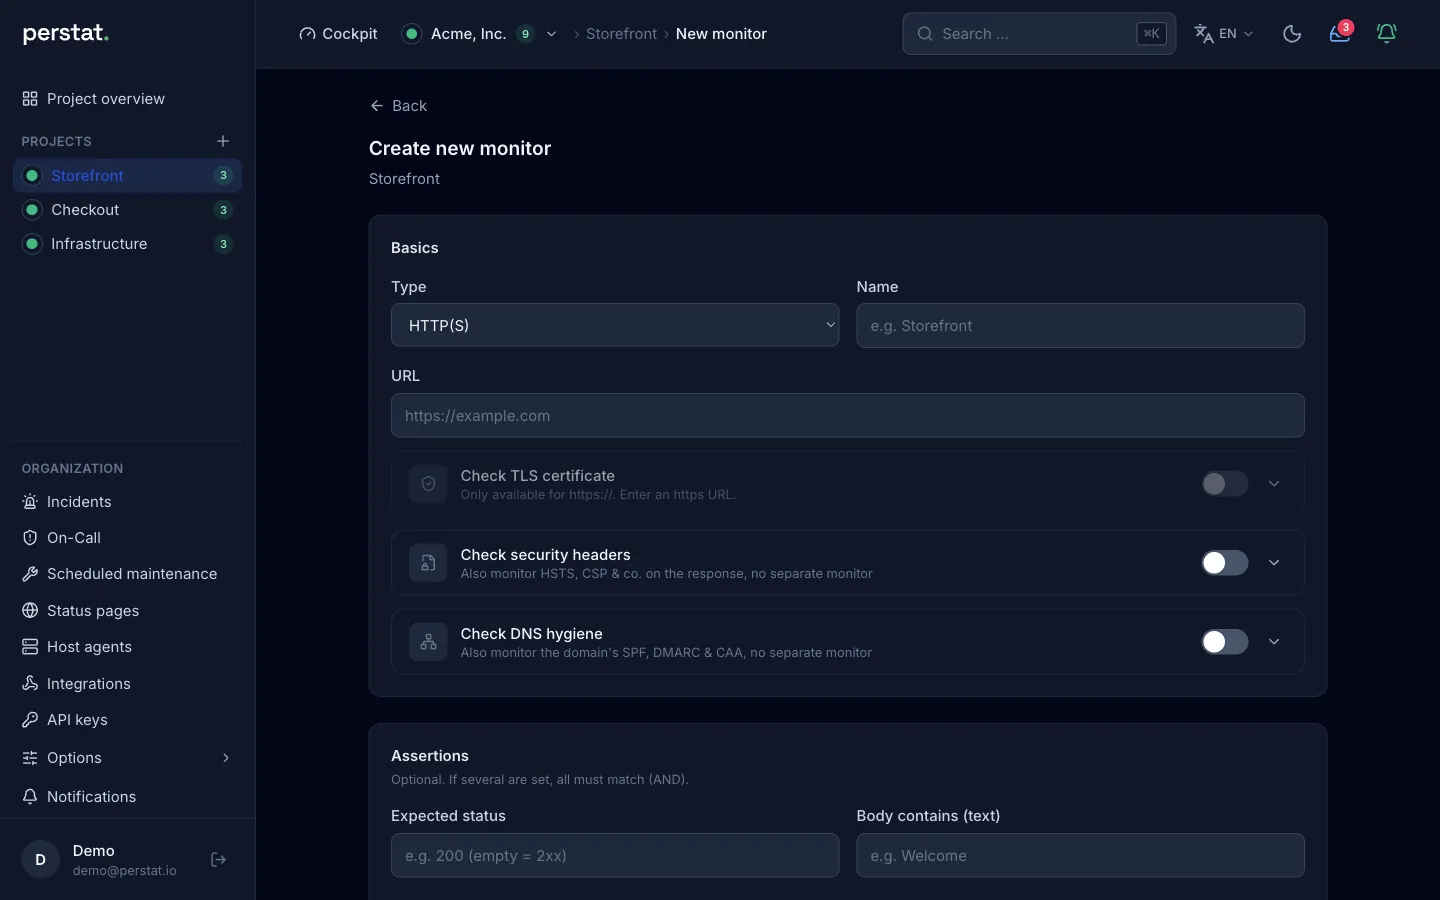
Crea un monitor HTTP para tu sitio o API. Elige regiones e intervalo según el plan.
Free · 0 € / mes
10 monitores para sitios y API, checks desde dos regiones y una página de estado. Detecta caídas y mantén informados a tus clientes.
Sin límite de tiempo. Sin tarjeta de crédito. Checks cada 5 minutos.
Estado del propio Perstatpágina de estadoCrea un monitor HTTP para tu sitio o API. Elige regiones e intervalo según el plan.
Activa push en tu iPhone o elige un conector existente. SMS personales desde Pulse; llamadas de guardia desde Sentinel.
Haz fallar de forma controlada un endpoint de prueba que administras. Espera la caída confirmada y comprueba la alerta. Después restablece el endpoint.
El botón Probar solo evalúa el check, sin guardar un incidente. No sustituye esta prueba de alerta. Usa un servicio de prueba, no uno de clientes.
Un check falla. Al alcanzar el cuórum, Perstat abre un incidente. Una persona lo asume; la recuperación confirmada lo cierra. Incidentes automáticos y confirmación en todos los planes. Guardias con SMS y llamadas desde Sentinel, por 89 € netos al mes.
Abrir la guíaEjemplo: diez clientes, cada uno con un proyecto y una página de estado en su dominio. Sentinel incluye cinco páginas; cinco más dan 89 € + 5 × 9 € = 134 € netos al mes. Marca blanca requiere Command, 249 € y hasta 20 páginas.
Los proyectos no son consolas privadas de clientes. Los checks HTTP prueban una petición, no una compra completa en el navegador ni todas las imágenes.
Abrir la guíaCrea un heartbeat, copia su URL secreta y envía el primer ping. Informa solo de éxitos reales; usa la URL de fallo cuando corresponda. Para probar la alerta, deja que una tarea de prueba venza después del primer ping.
if /path/to/job.sh; then
  curl --fail --silent --show-error "$PERSTAT_PING_URL"
else
  curl --fail --silent --show-error "$PERSTAT_PING_URL/fail"
  exit 1
fi
Free incluye dos heartbeats. La señal confirma el aviso de la tarea, no que una copia de seguridad se pueda restaurar.
Abrir la guíaCuatro informes públicos de incidentes muestran el valor de una mirada externa.
Comprueba la disponibilidad desde fuera de tu plataforma.
Google Cloud
Durante el fallo de la nube, el monitoring de algunos clientes también dejó de funcionar.
Un check de la URL que usan tus clientes te da tu propia señal de fallo.
Atlassian
El primer ticket de un cliente llegó 8 minutos después del inicio del fallo.
Los checks DNS indican cuándo un nombre de dominio deja de resolverse.
Marketo
Un problema de DNS hizo inaccesible la página de inicio de sesión.
Un heartbeat te avisa cuando falta una señal de éxito esperada.
GitLab
Las tareas de copia de seguridad fallaron y sus correos de error fueron rechazados.
Perstat cubre la cadena que va del check fallido a las evidencias. Por diseño, no es una suite de observabilidad.
En lugar de UptimeRobot, Pingdom o los checks de uptime de una suite más amplia: 13 tipos de check desde regiones identificadas.
En lugar de Atlassian Statuspage: páginas públicas o protegidas, alimentadas por los mismos monitores e incidentes.
En lugar de la parte de uptime de Opsgenie o PagerDuty: confirmación desde el teléfono, además de cuadrantes de guardia y escalado.
Los logs, las trazas, el APM y las alertas de otras herramientas se quedan donde están. Perstat no los recibe.
El endpoint MCP que da de alta monitores también sirve a agentes y scripts. Cada escritura se atribuye a la persona que creó la clave, y su rol actual se comprueba en cada llamada.
Leer la documentación de MCPcreate_projectCrear un proyectocreate_monitorCrear un monitorupdate_monitorEditar nombre, ajustes, intervalo o regionesset_monitor_enabledPausar o reanudar un monitorarchive_monitorArchivar un monitor y liberar su plaza en el planrestore_monitorRestaurar un monitor archivado, en pausaacknowledge_incidentConfirmar un incidenteresolve_incidentResolver un incidentedelete_monitorLas apps muestran alertas a pantalla completa, permiten confirmar deslizando y llevan el incidente abierto a la pantalla bloqueada como Actividad en directo. No hay app nativa para Android, pero los SMS desde Pulse y las llamadas de guardia desde Sentinel llegan a cualquier teléfono.
Ver en el App StoreFree cuesta 0 € al mes, sin límite de tiempo. Pasa a un plan de pago cuando necesites más monitores o funciones.
0 € al mes. 10 monitores, dos heartbeats y una página de estado. Incidentes automáticos y confirmación incluidos.
SMS personales, 50 monitores y tres puestos. 29 € netos/mes.
Rotaciones, SMS y llamadas, 150 monitores y 15 puestos. 89 € netos/mes.
Dominios de estado desde 89 €, marca blanca desde 249 € netos/mes. Revisa los límites de páginas.
Desliza lateralmente para comparar todos los planes
| Qué cambia con cada plan | Free0 €/ mesSin límite de tiempo | Pulse29 €/ mes | Sentinel89 €/ mes | Command249 €/ mes | Enterprisedesde 690 €/ mes |
|---|---|---|---|---|---|
| Monitores | 10 | 50 | 150 | 500 | a medida |
| Usuarios | 1 | 3 | 15 | 30 | a medida |
| Intervalo mínimo | 300 s | 60 s | 30 s | 15 s | 10 s |
| Regiones de sonda | 2 de 6 | 3 de 6 | las 6 | las 6 | las 6 |
| Historial público* | 7 días | 30 días | 90 días | 1 año | 2 años |
| Páginas de estado | 1 | 1 | 5 | 20 | a medida |
| Guardias, incidentes manuales, post-mortems | no | no | incluido | incluido | incluido |
Precios al mes en EUR, netos, sin IVA. Enterprise empieza en el importe indicado. *Estos valores limitan el historial público de incidentes resueltos. Otros objetos de datos siguen, por ahora, reglas propias de almacenamiento y borrado. Revisa los límites de retención documentados antes de comprar.
Operado por Datargo GmbH, con sede en Alemania.
Las ubicaciones de las sondas aparecen con su nombre, no ocultas tras un mapamundi.
Las capturas del producto, la página de estado pública, el informe de ejemplo y los límites de compra actuales se ven sin iniciar sesión.
Un diálogo de ejemplo muestra la configuración con un agente. Las imágenes de Perstat muestran el producto real con datos de ejemplo, sin grabar este diálogo.
Tu web o API está lista. Pide al agente conectado que incluya la supervisión, sin abrir otro formulario de configuración.
El ejemplo supone una conexión activa con Perstat y permisos de escritura para este proyecto.
Ver supervisión de disponibilidadEl agente puede crear un monitor de URL mediante MCP o modificar uno existente. Confirma la configuración en el diálogo.
Crear el monitor precede a la primera comprobación. El intervalo y las regiones dependen del plan.
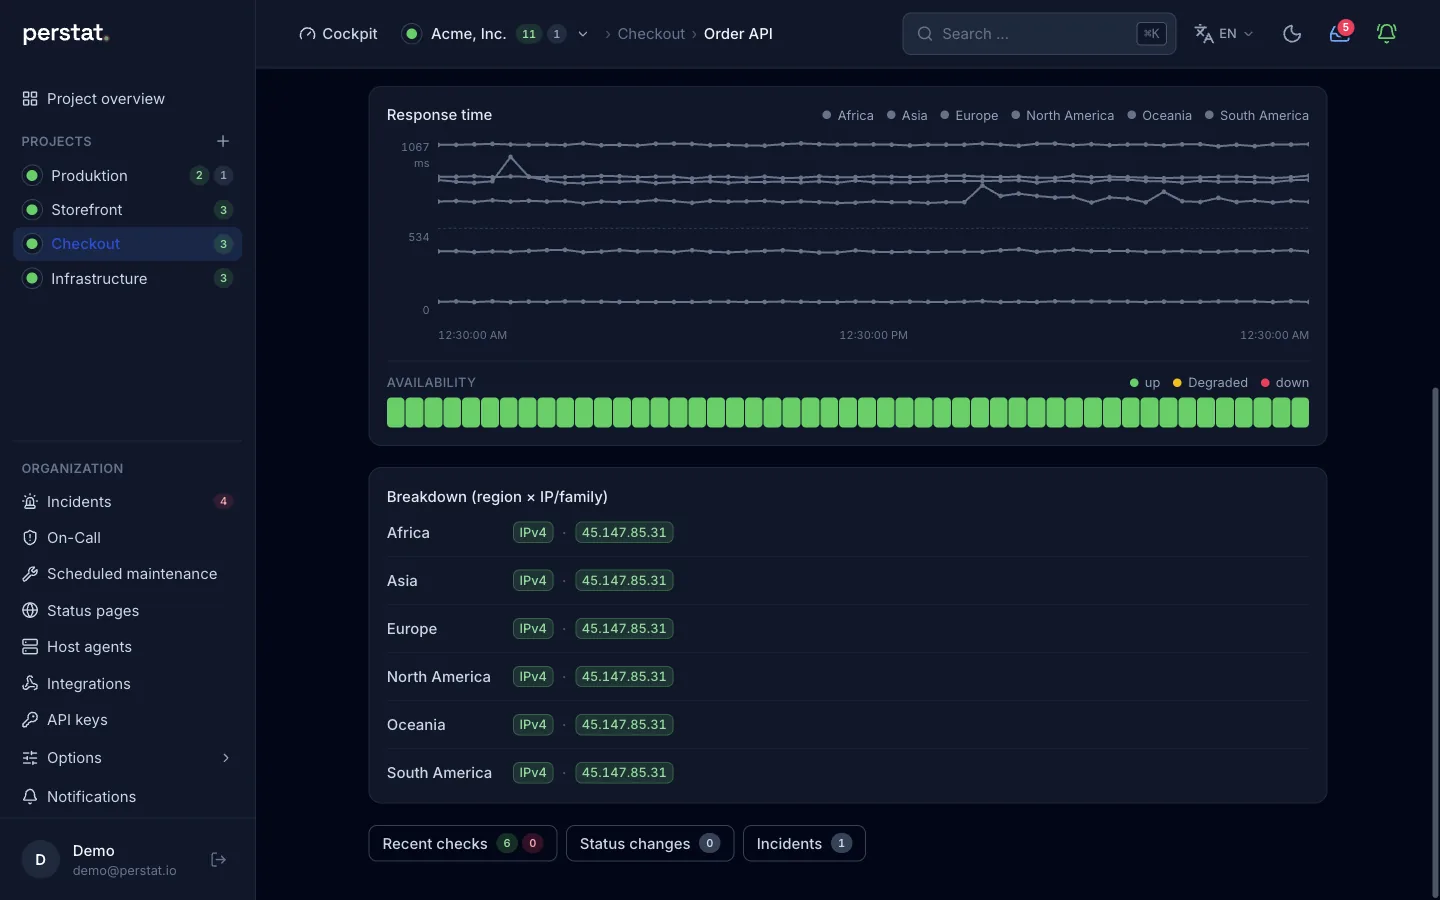
Ver supervisión de disponibilidadPerstat comprueba la URL desde fuera del servicio. Los resultados y tiempos de respuesta aparecen incluso después de cerrar el agente.
Una comprobación HTTP correcta verifica el endpoint configurado. No prueba un proceso de compra completo.
Ver supervisión de disponibilidad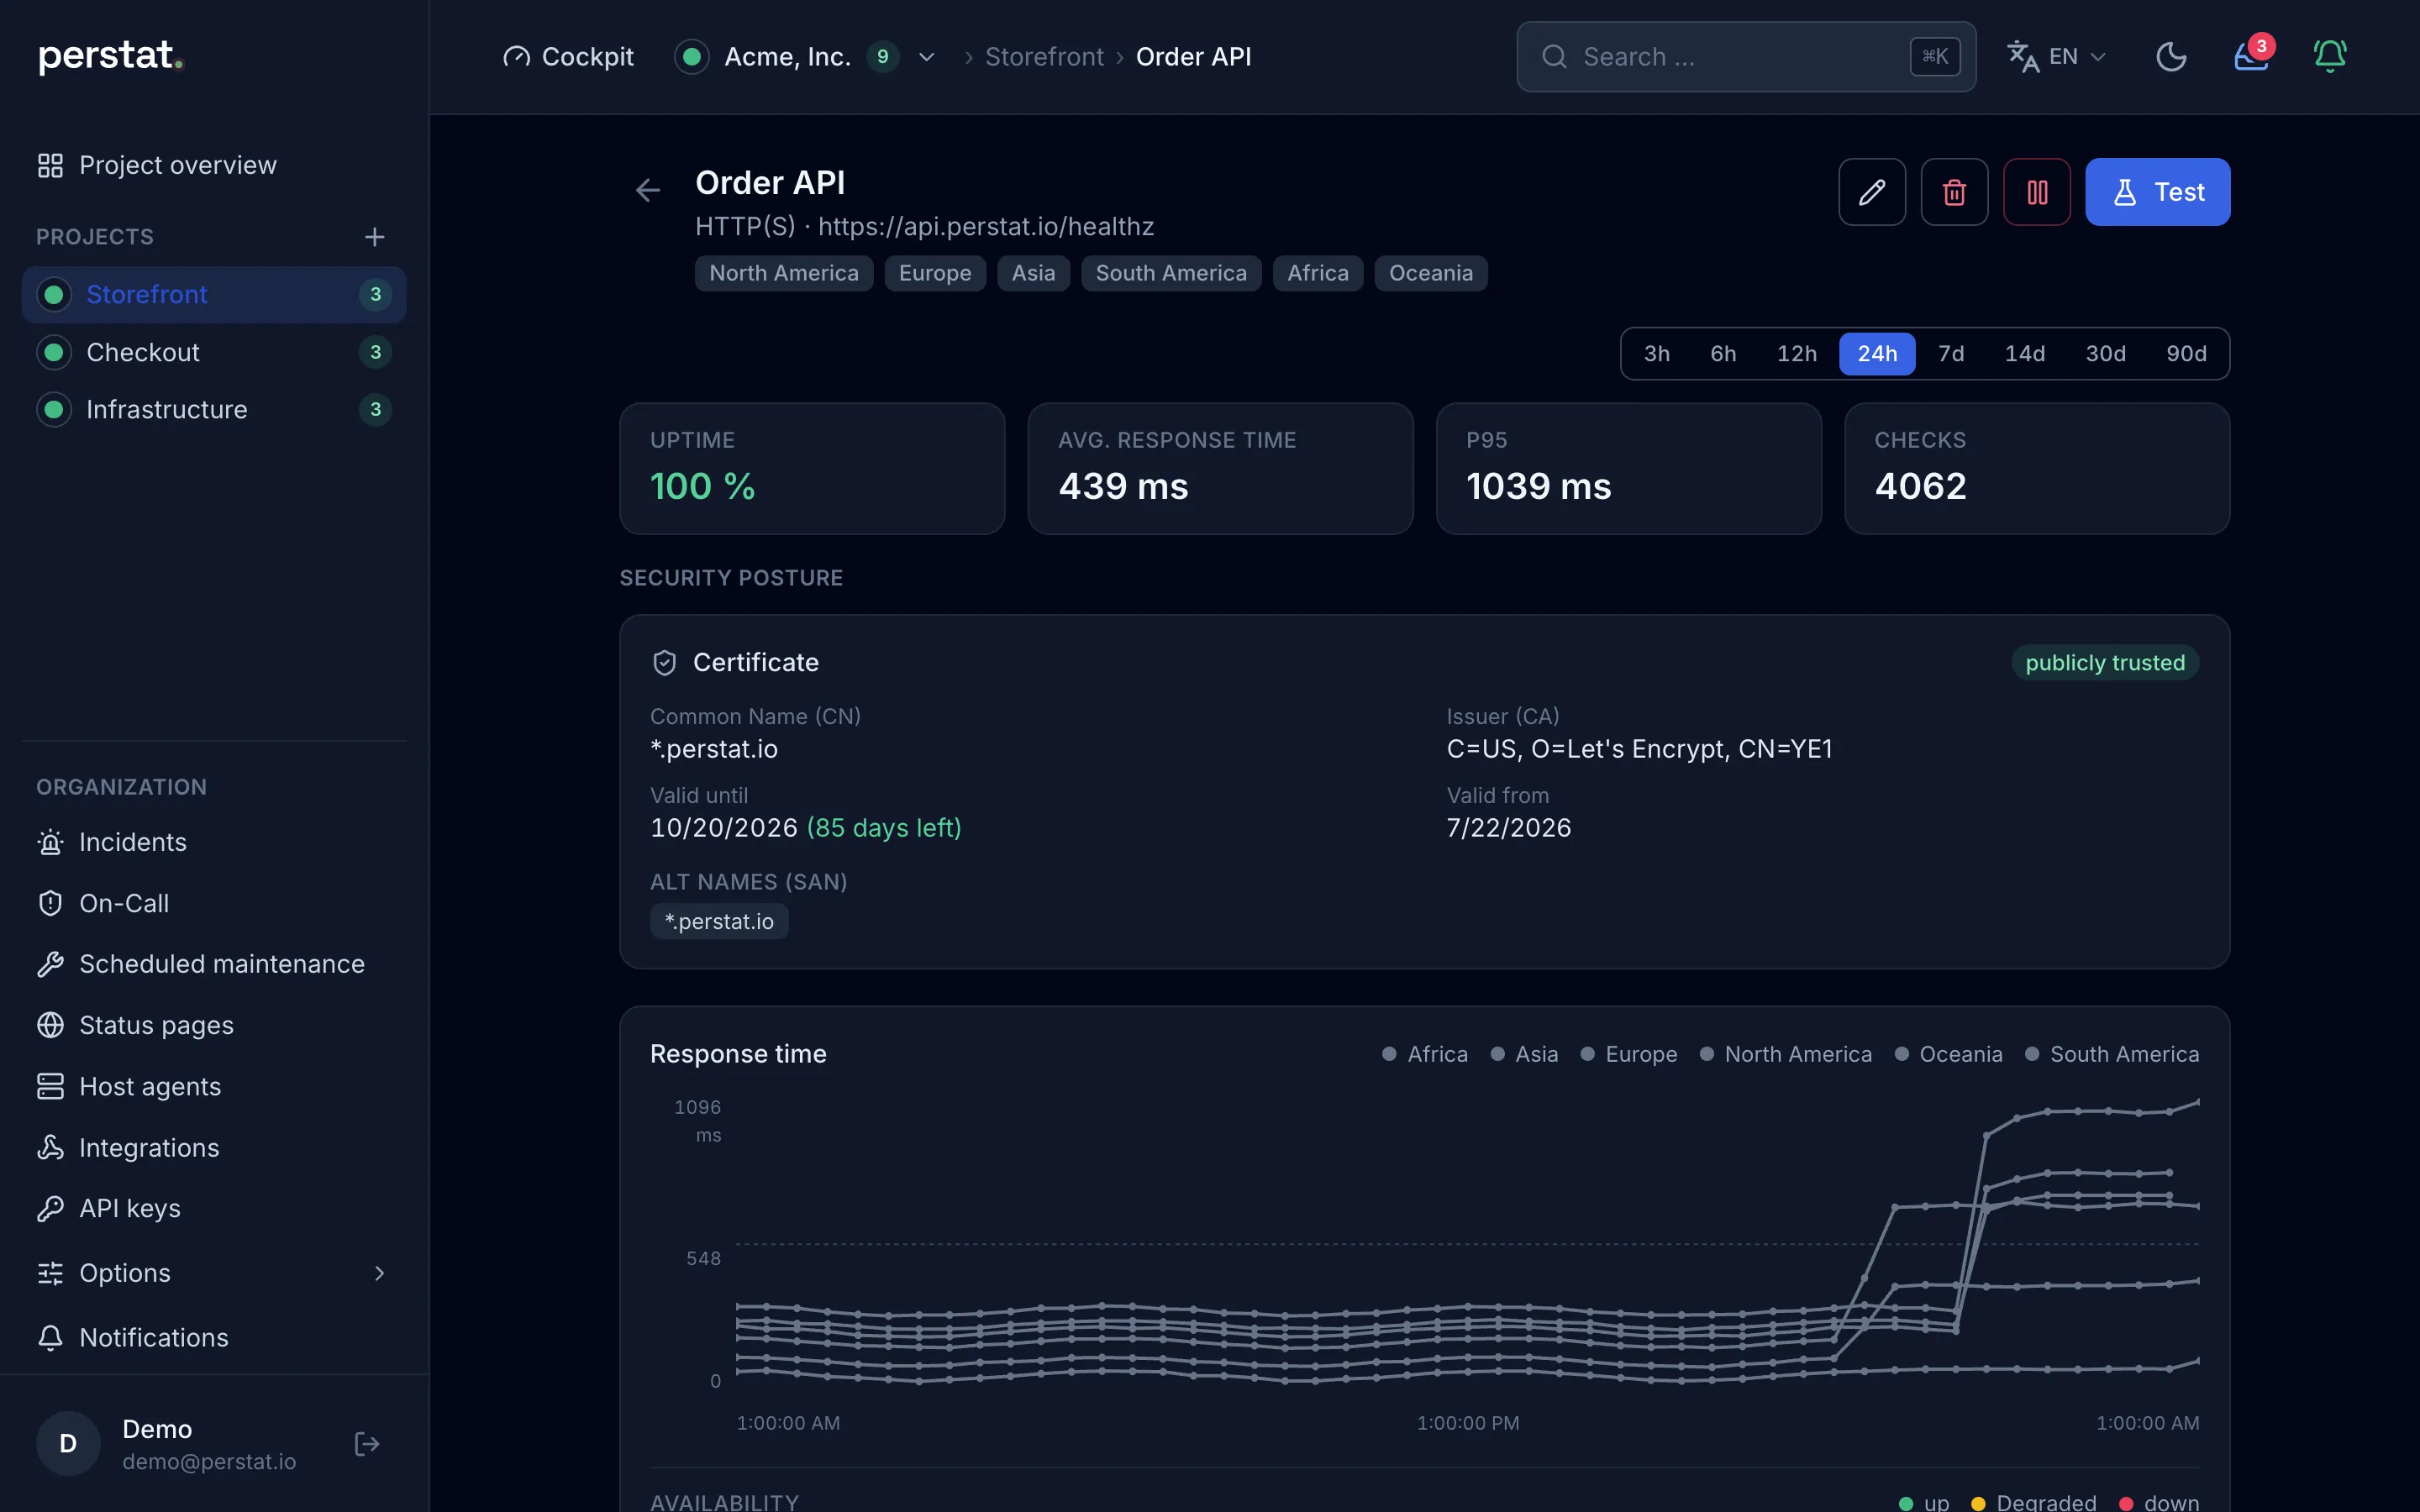
Cuando se cumplen las condiciones de fallo configuradas, Perstat abre un incidente y te avisa por los canales seleccionados.
Por defecto, dos regiones confirman los fallos de las comprobaciones regionales. Asumir el incidente no repara el servicio.
Ver supervisión de disponibilidad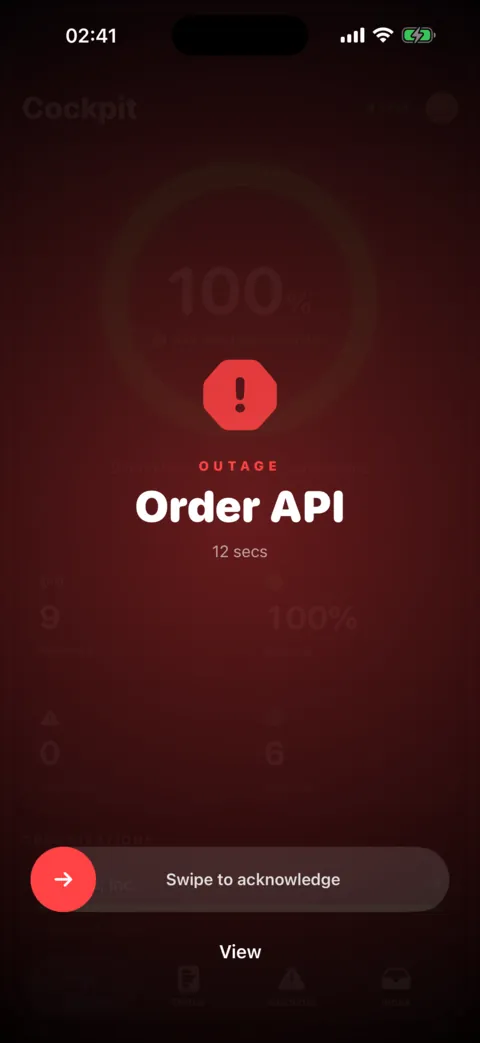
Una tarea puede detenerse mientras su servidor responde. Un heartbeat indica a Perstat cuándo esa tarea envía su señal.
El ejemplo sigue un informe cada hora. El mismo principio sirve para una tarea de copia de seguridad.
Ver supervisión con heartbeatCrea el heartbeat y añade su dirección privada a la tarea. Envía la señal de éxito cuando termine correctamente.
Mantén la dirección en secreto. La compatibilidad MCP depende del servidor y del cliente conectados.
Ver supervisión con heartbeatEjecuta la tarea y comprueba que Perstat recibió la señal. Las siguientes ejecuciones siguen el mismo horario.
El heartbeat de una copia confirma su señal. No verifica que la copia se pueda restaurar.
Ver supervisión con heartbeatSi la señal supera el intervalo y la tolerancia, Perstat puede abrir un incidente y avisar a los destinatarios configurados.
Los heartbeats siguen el horario de la tarea, sin quorum regional.
Ver supervisión con heartbeatAPI y MCP son opciones adicionales. La secuencia inferior es un ejemplo identificado.
Saltar la historiaorder-api 2.16.0 añade un webhook de pagos. De los últimos 8 despliegues, 3 llevaron a producción un endpoint, un job o un servicio sin monitor, porque crearlo era una tarea aparte.
09-10 11:47search-indexer 1.9.3worker poolmonitorizado09-09 09:15auth-service 3.1.1token rotationmonitorizado09-08 10:05mail-relay 1.4.2patchmonitorizado09-05 15:30order-api 2.15.4patchmonitorizado09-05 08:12status-sync 0.3.0cron jobmonitorizado3 de 8 despliegues añadieron algo sin monitor
Un paso después del despliegue crea el monitor mediante la API REST. La clave API de la organización necesita monitors:write y acceso al proyecto. Los errores HTTP hacen fallar el paso.
# tras el job de release: dar de alta el monitor
- name: Register monitor
  run: |
    curl --silent --show-error --fail-with-body \
      "https://api.perstat.io/projects/$PERSTAT_PROJECT_ID/monitors" \
      --header "Authorization: Bearer $PERSTAT_API_KEY" \
      --header "Content-Type: application/json" \
      --data '{
        "name": "Order API", "type": "http",
        "config": {"url": "https://orders.example.com/health"},
        "interval_seconds": 300,
        "regions": ["na", "eu", "as", "sa", "af", "oce"]
}'La API devuelve el monitor con su ID. Guárdelo y use PATCH para los cambios posteriores. Crear de nuevo el mismo nombre devuelve un conflicto, no un éxito implícito.
{
  "id": "mon_…",
  "name": "Order API",
  "type": "http",
  "enabled": true,
  "interval_seconds": 300,
  "regions": [
    "na",
    "eu",
    "as",
    "sa",
    "af",
    "oce"
  ]
}Actualizar el ID guardado con PATCH /monitors/{monitor_id}.
Nodos de sonda en 6 continentes ejecutan el check según su intervalo. Perstat guarda cada resultado con la región que lo ha medido.
naNorteaméricasaSudaméricaeuEuropaafÁfricaasAsiaoceOceaníaUn fallo en una región es un aviso discreto, no una alerta a la guardia. Cuando una segunda región también informa de un fallo, el quórum por defecto confirma la caída y abre un único incidente.
naewrNewarkOKFallosagruSão PauloOKeufraFráncfortOKafjnbJohannesburgoOKassgpSingapurOKFalloocesydSydneyOKna (Newark) informa de un fallo: aviso discreto, todavía no se alerta a nadie.
as (Singapur) también informa de un fallo: quórum alcanzado, incidente abierto a las 02:41:12 UTC.
Perstat envía la alerta al iPhone y al Apple Watch, y mediante conectores a Slack, Teams o PagerDuty. El escalado de guardia pasa después a SMS y a una llamada hasta que alguien confirme.
Escalado de guardia: desde Sentinel
Alertas SMS personales sin rotación: desde Pulse
acknowledge_incidentO desde el terminal: tu agente llama a acknowledge_incident por MCP, con la confirmación atribuida al titular de la clave.
El incidente abierto por el quórum aparece en la página de estado vinculada con su fase actual, y el componente pasa a Down. Nadie tiene que copiarlo a mano.
02:41:12 UTCCuando las regiones informan de la recuperación, el incidente se cierra con su inicio, su fin y su duración confirmados. El mantenimiento anunciado se excluye durante su ventana. Perstat calcula la disponibilidad a partir del mismo registro.
Order APIQ2 20262026-05-03 02:41:12Incidente, confirmado por quórum00:07:122026-05-17 22:00:00Mantenimiento, anunciado y excluido01:30:00Exportación: informe PDF por monitor de 7 a 90 días. CSV con manifiesto a petición.
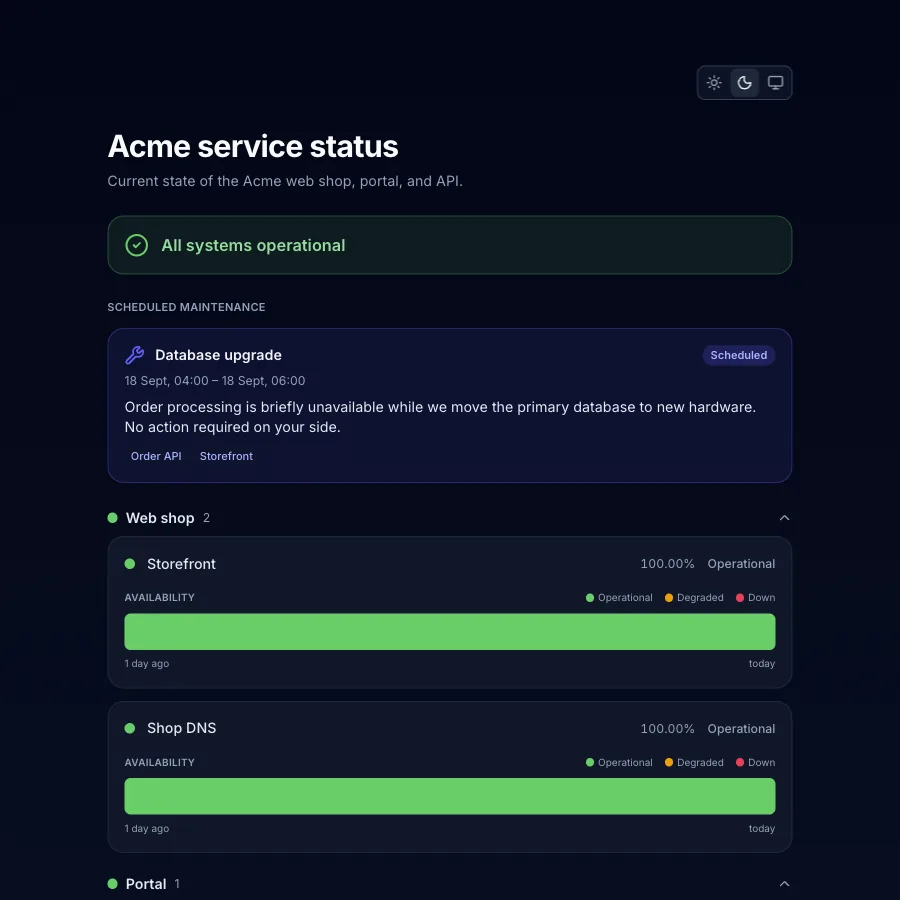
La página de estado en tu propio dominio muestra el estado, como esta actualización programada de la base de datos. La página y el badge de tu sitio leen del registro que hay detrás de la cifra de disponibilidad.
Dominio propio: desde Sentinel

<img src="https://status.example.com/badge.svg" alt="Service status">
El mismo badge en tu sitio, servido desde tu dominio. Muestra lo mismo que la página.Empieza con un sitio o una API. Free incluye 10 monitores, dos regiones de check y una página de estado, sin tarjeta ni límite de tiempo.
