En esta página
Qué verifica
Un monitor de agente de host se vincula a un agente instalado en uno de tus hosts y vigila una métrica. availability vigila si el agente sigue dando señales. cpu, mem y disk comparan el uso en porcentaje con un umbral, y service comprueba que un proceso concreto está en ejecución. El agente informa al control plane, y el servidor evalúa el último informe cada 30 s aproximadamente. Un incumplimiento abre un incidente, con push según notify_push, o genera solo un aviso en la app, según diga breach_severity. Un agente lleva varios monitores, uno por métrica o proceso.
Úsalo cuando
- Un host ejecuta algo sin puerto que sondear, o el puerto sigue respondiendo mientras el host se queda sin memoria o sin disco.
- Un proceso debe seguir en ejecución: una base de datos, un worker de cola o un proxy inverso. Un reinicio más corto que el margen de gracia no cuenta como incumplimiento.
- Un host debe dar la alarma cuando deja de informar del todo, con un margen de gracia para que un reinicio dentro de ella no abra ningún incidente.
El check no mide nada por la red. La alcanzabilidad de un puerto o una URL desde internet requiere el check ping, TCP o HTTP(S). Un job de cron o una ejecución por lotes sin proceso que vigilar requiere el check heartbeat.
Configuración
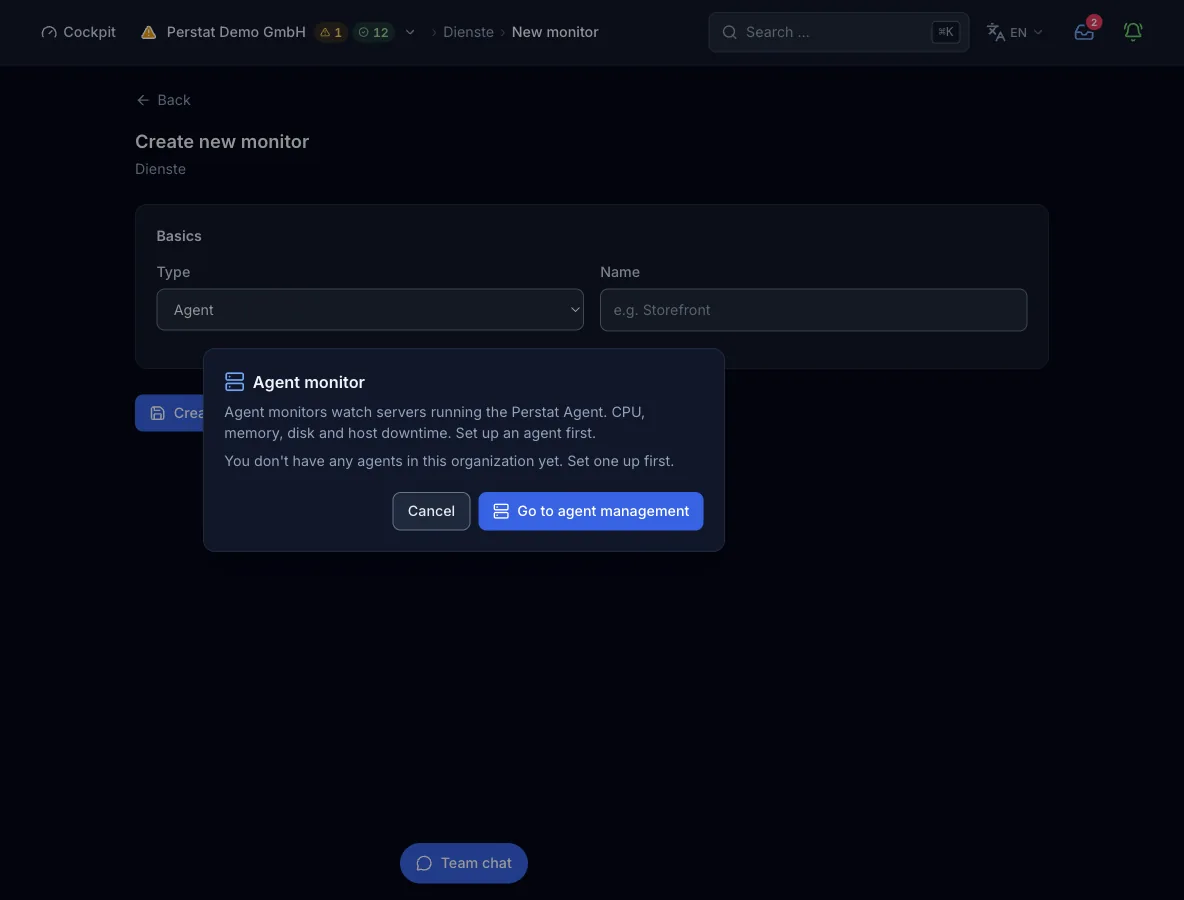
Agente. Sin objetivo de red. El monitor se vincula a un agente de host de tu organización por su agent_id, y el formulario lista los agentes registrados. El informe viene del host, así que el check no admite regiones, familias IP ni intervalo propio.
| Campo | Obligatorio | Valores y valor por defecto | Significado |
|---|---|---|---|
agent_idAgente | sí | ID público de un agente registrado en tu organización | Qué host vigila el monitor. El formulario lista los agentes registrados, y la API y MCP aceptan el ID. |
metricMétrica | sí | availability, cpu, mem, disk, service | Qué evalúa el servidor: las señales del agente, un valor de uso en porcentaje de CPU, memoria o disco, o un proceso en ejecución. Un monitor vigila una métrica. |
thresholdUmbral | opcional | Porcentaje, 0 a 100, por defecto 90. Lo usan cpu, mem y disk | Un valor por encima del umbral es un incumplimiento. availability y service lo ignoran. |
grace_seconds | opcional | 60 a 3600 s. Por defecto 180 para availability y 120 para service | Cuánto tiempo puede callar el agente, o estar parado el proceso, antes de que la pasada cuente un incumplimiento. Un hueco más corto no cuenta. Se fija por API o MCP, y el formulario conserva el valor guardado al editar. |
service_nameNombre del servicio | opcional | 1 a 64 caracteres entre letras, dígitos, ., _ y -. Obligatorio con service | El nombre del proceso en el host, por ejemplo nginx. La pasada busca una entrada reciente con ese nombre en el informe del agente. |
breach_severityGravedad | opcional | critical (por defecto) o degraded | critical registra un check fallido y abre un incidente, con push según notify_push. degraded registra un check degradado y genera solo el aviso en la app. |
notify_pushNotificación push | opcional | true (por defecto) o false | Envía una notificación push ante un incumplimiento critical. No tiene efecto con degraded. |
Cómo se ejecuta un check
- El agente del host informa al control plane. Cada 30 s aproximadamente, el servidor carga el último informe del agente para este monitor. No participa ninguna región de sonda, y el check nunca toca el host por la red.
availability: el servidor compara la antigüedad del último informe congrace_seconds. Un informe más antiguo que el margen de gracia es un incumplimiento.cpu,mem,disk: se evalúan solo mientras el último informe tiene como máximo 180 s, y un valor por encima dethresholdes un incumplimiento. Sin un valor reciente, la pasada no registra ningún resultado en lugar de una falsa alarma. Del host que calla se ocupa la métricaavailability.service: se evalúa solo con un informe reciente y una entrada reciente del proceso indicado. Un proceso que lleva más degrace_secondssin ejecutarse es un incumplimiento.- Un incumplimiento se convierte en failed con gravedad critical, o en degraded, según diga
breach_severity. Critical abre un incidente con push segúnnotify_push, y degraded genera solo un aviso en la app. Alarma y recuperación están fijadas en 1 evaluación cada una, así que decide la siguiente pasada.
Qué contiene un resultado
- Estado y gravedad
- passed, degraded o failed, con gravedad ok, degraded o critical. La región es
agent, la marca de un check evaluado en el servidor. - Línea de detalle
- Una línea con el hecho evaluado. Muestra la antigüedad del último informe frente al margen de gracia, el valor frente al umbral (
CPU 95% > 90%), o el proceso con su número de procesos y su cuota de CPU. - Latencia y código de respuesta
- No se mide nada por la red, así que un resultado no lleva ni tiempo de respuesta ni código de estado.
Estados y gravedad
- okEl último informe está dentro del margen de gracia, el valor está en el umbral o por debajo, o el proceso está en ejecución.
- degradadoUn incumplimiento con
breach_severityendegraded. Se registra y se muestra como aviso en la app, sin incidente y sin push. - caídoUn incumplimiento con
breach_severityencritical, el valor por defecto. El agente calló más allá del margen de gracia, un valor superó el umbral o el proceso estuvo parado más tiempo que el margen de gracia. Abre un incidente, con push segúnnotify_push. - errorAparece solo en una ejecución de prueba. Cuando la métrica no se puede evaluar, por ejemplo sin un informe reciente, la ejecución responde error con un diagnóstico. No se guarda nada y no se abre ningún incidente.
- pendienteAún no hay resultado, justo después de crearlo o mientras el agente no haya enviado ningún valor reciente para la métrica. La pasada no registra nada en lugar de dar una falsa alarma.
La señal viene de tu host o de tu job, sin regiones ni quórum, así que un solo informe que falte ya cuenta. Alarma y recuperación están fijadas en 1 evaluación cada una. La pasada que ve el incumplimiento abre el incidente, y una evaluación superada cuenta como recuperación.
Planes y límites
- Agentes de host
- 2 en Free, 10 en Pulse, 50 en Sentinel y 200 en Command. En Enterprise, los cupos son a medida. Un paquete adicional añade 10 agentes por 19 €.
- Monitores por agente
- 25 en Free, Pulse, Sentinel y Command. En Enterprise, los cupos son a medida. Un monitor de agente de host cuenta aquí, no en el cupo de monitores de sonda.
- Intervalo y regiones
- No aplican. El servidor evalúa cada 30 s aproximadamente, y los intervalos mínimos y el número de regiones de los planes no rigen para este tipo.
Desde la pipeline o un agente
La misma config sirve en el paso de despliegue, en un cliente MCP como Claude Code y en el formulario de arriba. create_monitor necesita una clave de API válida para toda la organización. Si omites regions, el plan aplica su valor por defecto.
{
  "name": "web-01 CPU",
  "type": "agent",
  "config": {
    "agent_id": "agt_...",
    "metric": "cpu",
    "threshold": 90,
    "breach_severity": "degraded",
    "notify_push": true
  }
}
Límites
- El agente comunica cuatro métricas (disponibilidad, CPU, memoria y disco) y el estado de un proceso concreto. No hay otras métricas ni valores propios.
- CPU, memoria y disco no se evalúan mientras el agente calla. Combina un monitor de umbral con un monitor
availabilitysobre el mismo agente para detectar el host que calla. grace_secondsse fija por API o MCP. El formulario conserva el valor guardado al editar.- El tipo no tiene intervalo, regiones ni política de alertas propios, y el formulario oculta los tres. El servidor evalúa todos los monitores de agente en una pasada cada 30 s aproximadamente e ignora
regionsen una petición.interval_secondsse guarda al editar y se muestra en el monitor, pero la evaluación no lee ni ese valor ni los 60 s fijados al crearlo. agent_iddebe nombrar un agente ya registrado en tu organización. El ID viene del registro del agente, y el monitor no lo crea.