En esta página
Qué verifica
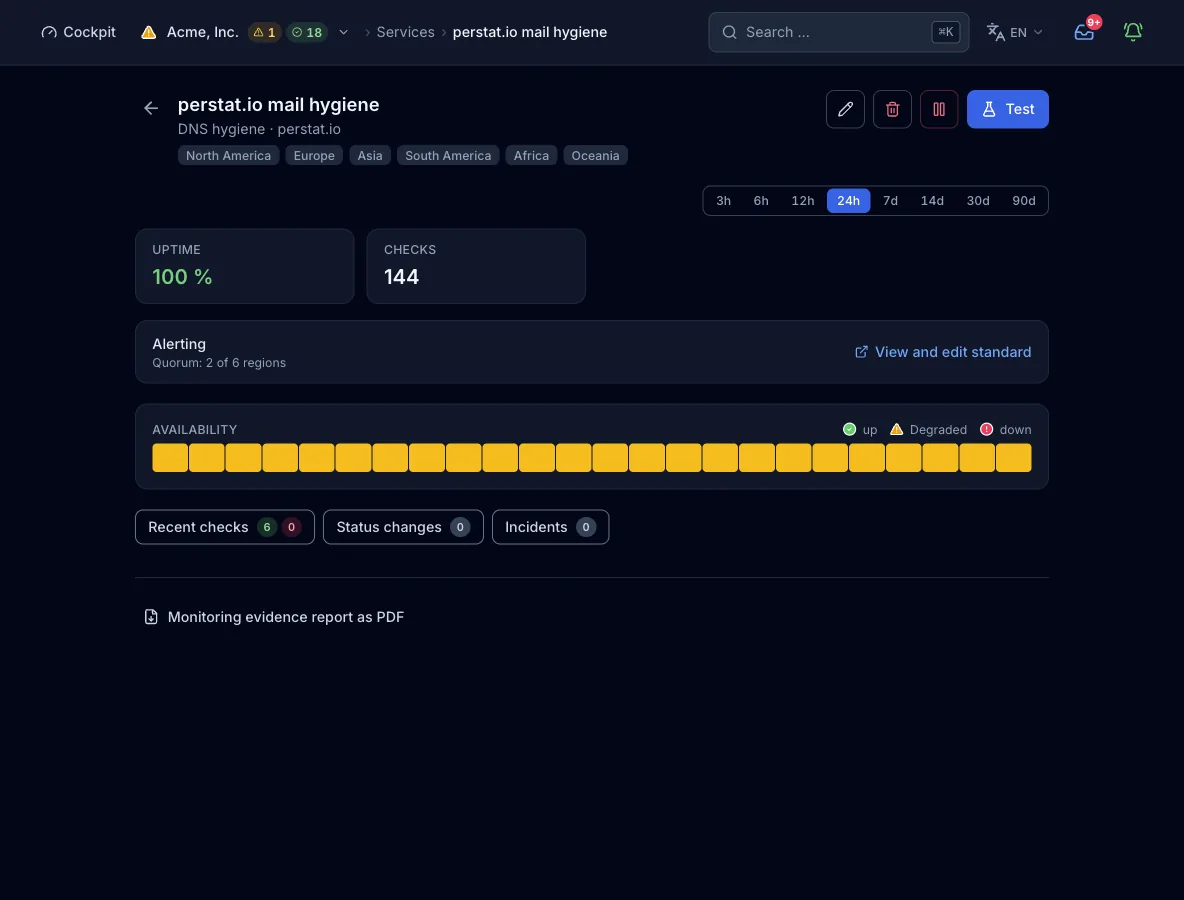
Un monitor de higiene DNS lee 3 registros de un dominio desde cada una de sus regiones en cada intervalo. SPF y DMARC deciden si el correo del dominio se entrega, y CAA decide quién puede emitir certificados para él. SPF presente, DMARC con p=quarantine o p=reject y un registro CAA dan ok, y cualquier cosa por debajo da degraded. La calificación nunca baja de degraded, así que una postura de correo o de certificados debilitada llega al panel sin avisar a nadie.
Úsalo cuando
- Un dominio envía correo, como facturas, restablecimientos de contraseña o notificaciones, y sus registros SPF y DMARC deben sobrevivir a cada cambio de DNS.
- Una política DMARC en
noneo un registro CAA ausente deben aparecer como hallazgo con marca de tiempo, sin abrir un incidente. - El dominio no tiene ningún endpoint HTTP tuyo en el que un monitor HTTP(S) pudiera llevar el subcheck de higiene DNS.
No comprueba si el dominio resuelve ni si el servidor de correo acepta conexiones. Un registro que debe llevar un valor concreto necesita el check de registro DNS, y la ruta del correo necesita los checks SMTP e IMAP. NS, SOA, DNSSEC y la caducidad del dominio corresponden al check de dominio.
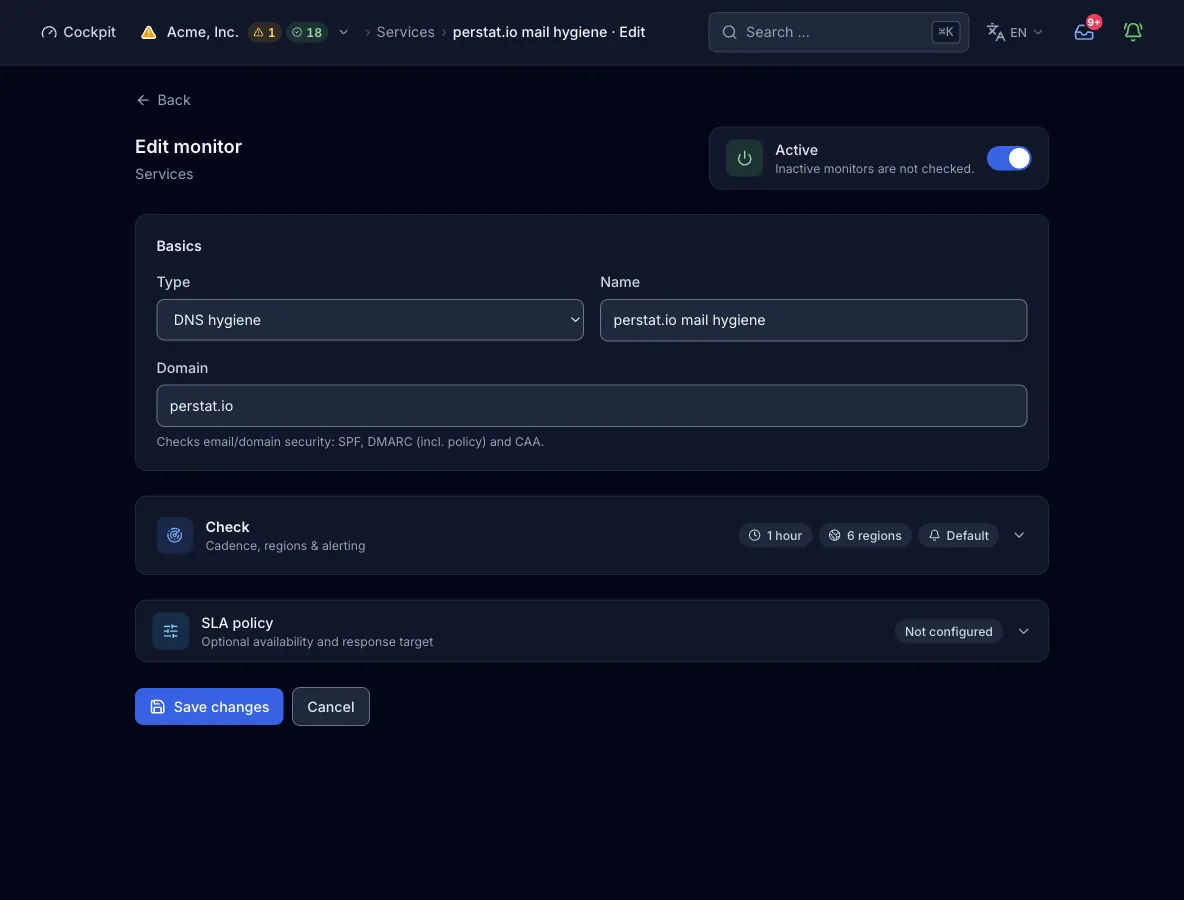
Configuración
Dominio. El dominio cuyos registros se leen, por ejemplo example.com. Un punto final se elimina. Las 3 consultas van al apex y a _dmarc. por debajo de él, a través del resolver propio del nodo, desde cada región seleccionada.
| Campo | Obligatorio | Valores y valor por defecto | Significado |
|---|---|---|---|
domainDominio | sí | Nombre de dominio, por ejemplo example.com | El dominio cuyos registros SPF, DMARC y CAA se leen. |
interval_secondsIntervalo del check | opcional | Por defecto 300 s. Rango: del mínimo del plan a 24 h | Cada cuánto ejecuta el check cada región. Un valor fuera del rango se eleva al mínimo del plan o se limita a 24 h, no se rechaza. |
regionsRegiones | opcional | Subconjunto de na, eu, as, sa, af, oce. Por defecto: las regiones del plan | Qué continentes ejecutan el check. Si lo omites, el plan aplica su conjunto por defecto. |
Cómo se ejecuta un check
- Cada región a la que le toca el intervalo pide al resolver propio del nodo los registros TXT del apex del dominio y busca uno que contenga
v=spf1. - Lee los registros TXT bajo
_dmarc.<domain>, busca uno que contengav=dmarc1y extrae de él la políticap=. - Pide los registros CAA del apex. Solo cuenta su presencia, no su contenido.
- Un registro SPF o DMARC ausente da degraded, y el detalle nombra lo que falta. Si no, una política DMARC distinta de
quarantineoreject, o la falta de un registro CAA, da degraded, y el detalle nombra lo que es débil. Todo en su sitio da ok. - La región envía su resultado al control plane. Un resultado degradado queda fuera de la evaluación de incidentes. Allí solo cuenta como caída un error, cuando el quórum lo confirma.
Qué contiene un resultado
- Línea de detalle
- Una línea nombra los registros ausentes (SPF, DMARC) o los débiles, como
DMARC p=noneo la falta de CAA. Con todo en su sitio diceSPF · DMARC p=reject · CAA, con la política que lleva el registro. - Tiempo de respuesta
- El tiempo de las 3 consultas juntas, por región. Este tipo no registra código de respuesta ni capa de causa.
- Región
- Cada resultado lleva la región que lo midió. No hay subresultados por familia ni por dirección.
Estados y gravedad
- okSPF está presente, DMARC lleva
p=quarantineop=rejecty existe un registro CAA. - degradadoFalta SPF o DMARC, DMARC lleva una política distinta de
quarantineoreject, o no existe ningún registro CAA. Una consulta que falla o no devuelve nada cuenta como ausente, no como error. - errorEl check no se puede ejecutar: la configuración no se puede leer, el dominio está vacío o el resolver del nodo no se inicializa. Cuenta como caída con gravedad critical.
Confirmado por quórum: por defecto, 2 regiones deben informar del fallo antes de que se abra un incidente. La calificación de postura es ok o degraded, nunca caído. Solo un error, cuando el check no se puede ejecutar, cuenta como caída. El valor por defecto de la organización pide 2 regiones y 2 checks consecutivos, y un monitor puede llevar su propia regla (número o porcentaje, checks consecutivos y duración mínima).
Planes y límites
- Intervalo mínimo
- Free permite 300 s, Pulse 60 s y Sentinel 30 s. Command permite 15 s y Enterprise 10 s, ambos solo por MCP. El formulario web ofrece 30 s, 1 min, 5 min, 15 min y 1 h.
- Regiones
- Free ejecuta 2 de 6 regiones y Pulse 3 de 6. Las 6 están disponibles desde Sentinel.
- Monitores
- Free incluye 10 monitores de sonda, Pulse 50, Sentinel 150 y Command 500. Los cupos de Enterprise son a medida. La cuenta abarca los 11 tipos de check de sonda, y los agentes de host y los heartbeats tienen cupos propios.
Desde la pipeline o un agente
La misma config sirve en el paso de despliegue, en un cliente MCP como Claude Code y en el formulario de arriba. create_monitor necesita una clave de API válida para toda la organización. Si omites regions, el plan aplica su valor por defecto.
{
  "name": "example.com mail hygiene",
  "type": "dns_hygiene",
  "interval_seconds": 3600,
  "config": {
    "domain": "example.com"
  }
}
Límites
- No hay comprobación de sintaxis SPF. Basta con que un registro TXT del apex contenga
v=spf1. - No hay comprobación DKIM ni MX, y el contenido de un registro CAA no se lee.
- Una consulta que falla cuenta como registro ausente, no como error de medición.
- No hay familias IP ni subresultados por dirección. Las consultas van por el resolver propio del nodo, y el nodo detiene una ejecución a los 120 s.
- Un registro ausente o débil nunca se califica por debajo de degraded. Un registro que debe llevar un valor concreto necesita el check de registro DNS.
- A partir de la build del 13 de septiembre de 2026, el validador lee
domaincuando se crea o actualiza un monitor por API. Entre el 11 de agosto de 2026 y esa build leíanamey rechazaba una petición sin él (name must not be empty). El motor seguía leyendodomain, y los monitores existentes seguían funcionando. Hasta que se despliegue esa build, envíanamecon el mismo valor junto adomain.