En esta página
Qué verifica
Un monitor heartbeat verifica que un job se ejecutó cuando debía. Al crear el monitor se genera una URL secreta, y el job la pide al final de cada ejecución. Cada 30 s aproximadamente, el control plane compara la antigüedad del último ping con el periodo esperado más el margen de gracia. Un ping más antiguo, o un último ping que llegó a la URL de fallo, es un incumplimiento. Hasta que llega el primer ping, el monitor está pendiente, no caído.
Úsalo cuando
- Un job programado no tiene dirección que sondear: una ejecución de cron, una copia de seguridad nocturna, un importador o un worker que debe terminar a tiempo.
- El fallo que necesitas ver es que algo no ha ocurrido. Un job que nunca arrancó no deja nada roto que una sonda pueda alcanzar.
- El job puede evaluar su propia ejecución. Llama a la URL de ping tras un éxito y a la URL de fallo cuando fallan sus propias comprobaciones. El monitor pasa entonces a caído en la siguiente evaluación, sin esperar a que venza el calendario.
El check solo registra cuándo llega la llamada. Un servicio que escucha en un puerto requiere el check HTTP(S) o TCP. La CPU, la memoria, el disco y los procesos del propio host requieren el check de agente de host.
Configuración
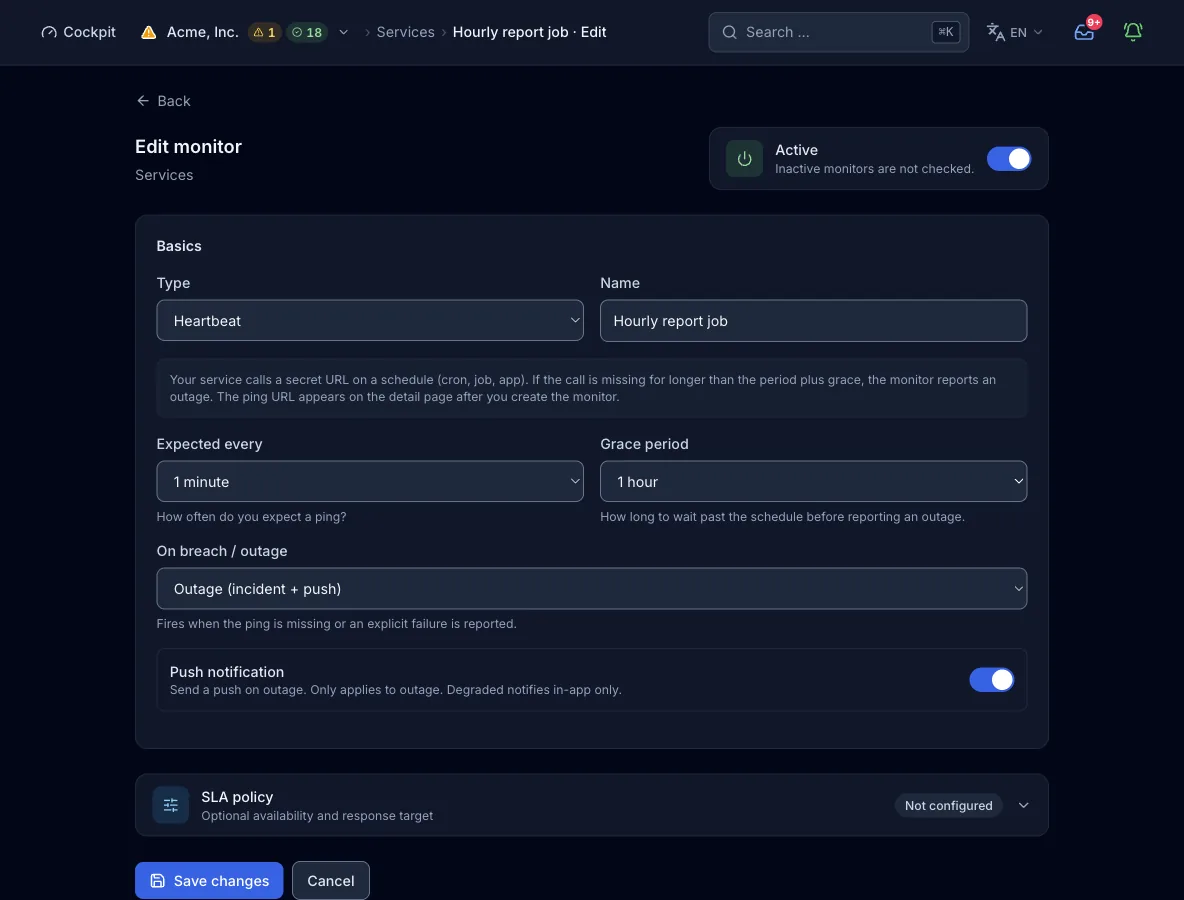
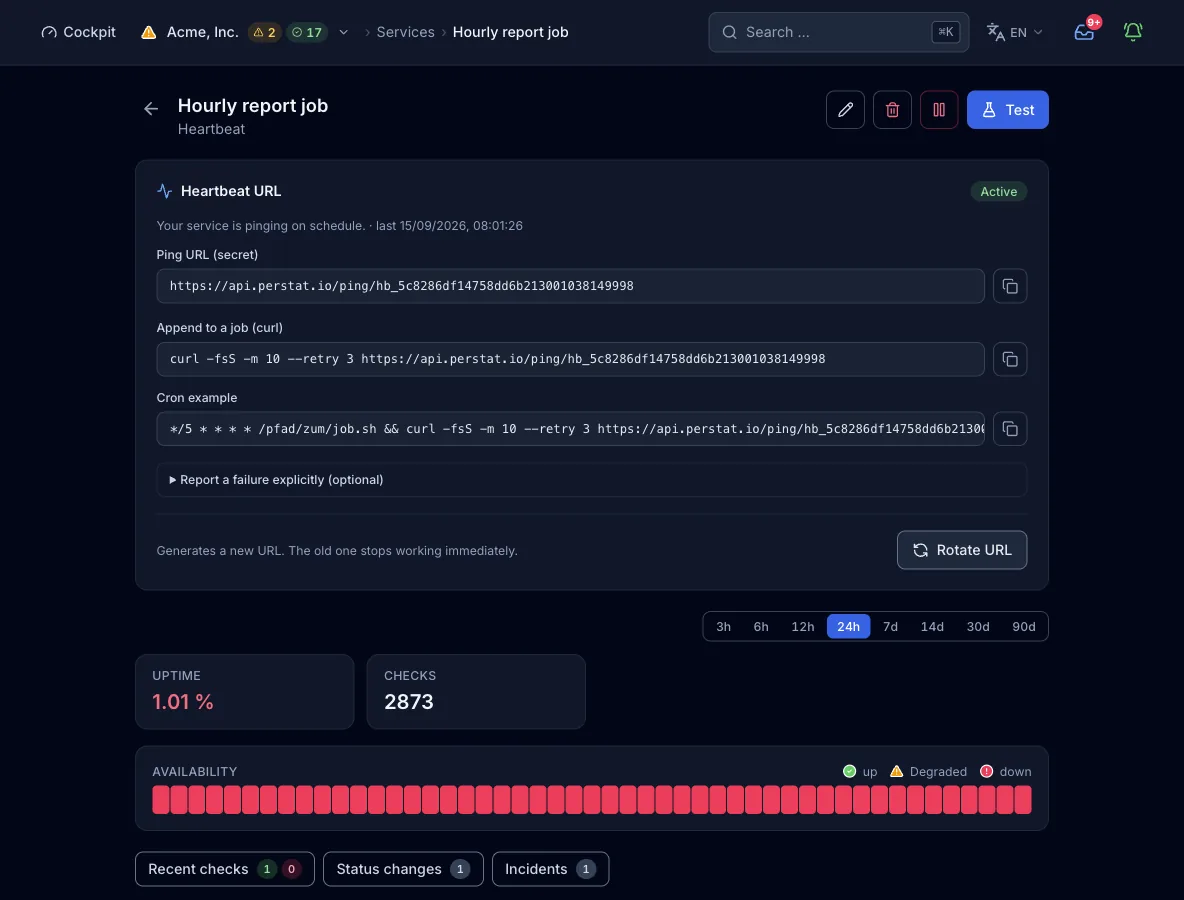
Objetivo. Ninguno. Un heartbeat no tiene objetivo, ni regiones de sonda, ni familias IP, ni intervalo de check propio. El formulario oculta esos campos, y el control plane evalúa el monitor cada 30 s aproximadamente bajo la pseudorregión heartbeat. Al crear el monitor se genera la URL secreta https://api.perstat.io/ping/{token}. La vista del monitor la muestra junto con la URL de fallo (con /fail añadido).
| Campo | Obligatorio | Valores y valor por defecto | Significado |
|---|---|---|---|
period_secondsEsperado cada | opcional | Segundos, 30 a 2.592.000 (30 días), por defecto 3600 | Cada cuánto se espera el ping del job. El formulario ofrece valores predefinidos, y la API ajusta cualquier número de segundos al rango. |
grace_secondsPeriodo de gracia | opcional | Segundos, 0 a 86.400 (24 h). Por defecto: una quinta parte del periodo, acotada entre 60 y 3600 | Cuánto tiempo después del periodo puede llegar aún el ping antes de que el monitor cuente un incumplimiento. Un valor de 0 fija un plazo estricto. Fija el margen de gracia como una fracción real del periodo, porque una copia de seguridad nocturna con 60 s de gracia alerta en cada noche lenta. |
breach_severityAnte un incumplimiento / caída | opcional | critical (por defecto) o degraded | critical marca el monitor como caído y abre un incidente, con push según notify_push. degraded lo marca como degradado con solo un aviso en la app, y cualquier otro valor se guarda como critical. |
notify_pushNotificación push | opcional | true (por defecto) o false | Envía una notificación push ante una caída con critical. Un incumplimiento degradado avisa en la app en cualquier caso. |
Cómo se ejecuta un check
- Al crear el monitor se genera el token, y la vista del monitor muestra la URL de ping y la URL de fallo. Integra la URL de ping en el job, por ejemplo como último comando de la línea de cron.
- El job pide la URL de ping con GET o POST cuando termina una ejecución. Cuando la ejecución determina que ha fallado, el job pide en su lugar la URL de fallo.
- Cada 30 s aproximadamente, el control plane evalúa el monitor. Hasta el primer ping se queda en pendiente y no se escribe ningún resultado.
- Un último ping que llegó a la URL de fallo es un incumplimiento. También lo es un último ping más antiguo que el periodo más el margen de gracia.
- Un incumplimiento toma la gravedad configurada.
criticalmarca el monitor como caído y abre un incidente, con push si está activado, ydegradedlo marca como degradado con solo un aviso en la app. Alarma y recuperación están fijadas en 1 check cada una, así que el siguiente ping sano resuelve el incidente en la siguiente evaluación. - El botón Test ejecuta la misma evaluación bajo demanda y te muestra el resultado solo a ti. No se guarda nada y no se abre ningún incidente.
Qué contiene un resultado
- Estado y gravedad
- passed, failed o degraded, con gravedad ok, degraded o critical. Un heartbeat que nunca ha hecho ping muestra pending.
- Línea de detalle
- Una línea que dice qué ha pasado. Indica un heartbeat al día con la antigüedad del último ping, la falta de heartbeat durante N segundos frente al periodo y el margen de gracia esperados, o un fallo que comunicó el job.
- Último ping
- El panel de heartbeat de la vista del monitor muestra la hora del último ping. Está en la línea de estado sobre la URL de ping, junto a la etiqueta Active o Waiting. La línea de detalle de la siguiente evaluación, no el panel, indica si ese ping fue sano o un fallo.
- Región
- Cada resultado lleva la pseudorregión
heartbeat. No hay latencia, ni código de respuesta, ni subresultado.
Estados y gravedad
- okEl último ping llegó dentro del periodo más el margen de gracia y fue un ping sano.
- degradadoUn incumplimiento con
breach_severityendegraded. Genera un aviso en la app, sin incidente y sin push. - caídoUn incumplimiento con la gravedad por defecto
critical: el último ping es más antiguo que el periodo más el margen de gracia, o el job llamó a la URL de fallo. Abre un incidente, con push segúnnotify_push. - pendienteAún no ha llegado ningún ping. El monitor muestra pendiente hasta que el job llama a la URL por primera vez.
La señal viene de tu host o de tu job, sin regiones ni quórum, así que un solo informe que falte ya cuenta. El control plane evalúa cada 30 s aproximadamente, con alarma y recuperación fijadas en 1 check cada una. Un incumplimiento se convierte en incidente en la siguiente evaluación después de agotarse el periodo más el margen de gracia.
Planes y límites
- Intervalo de evaluación
- Unos 30 s en todos los planes, fijado por el servidor. El intervalo mínimo del plan solo se aplica a los tipos de check de sonda.
- Regiones
- Ninguna. El job informa y no se sondea nada, así que el número de regiones del plan no se aplica.
- Heartbeats
- 2 en Free, 10 en Pulse, 50 en Sentinel y 200 en Command. En Enterprise, los cupos son a medida. Los heartbeats tienen cupo propio y no consumen ninguna plaza de monitor de sonda. Un paquete de 25 más cuesta 9 €.
Desde la pipeline o un agente
La misma config sirve en el paso de despliegue, en un cliente MCP como Claude Code y en el formulario de arriba. create_monitor necesita una clave de API válida para toda la organización. Si omites regions, el plan aplica su valor por defecto.
{
  "name": "Nightly backup",
  "type": "heartbeat",
  "config": {
    "period_seconds": 86400,
    "grace_seconds": 1800,
    "breach_severity": "critical",
    "notify_push": true
  }
}
Límites
- No se mide nada más que el momento de la llamada, sin tiempo de ejecución, sin código de salida y sin carga útil.
- Hasta el primer ping, el monitor está pendiente. Un heartbeat al que no llama ningún job parece cobertura y no lo es.
- La URL de ping no lleva autenticación, así que quien tenga el token puede hacer ping. Trátala como una credencial. Si se filtra, rótala en la vista del monitor, y la URL antigua deja de funcionar al instante.
- El endpoint de ping acepta 240 peticiones por 60 s por IP de origen. Un token desconocido recibe 404.
- Una petición de creación por API o MCP no devuelve la URL de ping. Léela en la vista del monitor e intégrala en el job.
- La evaluación corre cada 30 s aproximadamente, así que un incumplimiento se detecta hasta unos 30 s después de agotarse el periodo más el margen de gracia.