En esta página
Qué verifica
En cada intervalo, cada región de un monitor ping envía peticiones ICMP echo a cada dirección resuelta del host. Por defecto son 3 paquetes de 32 bytes, uno tras otro, y cada uno espera hasta 10 s su respuesta. El monitor registra cuántas respuestas volvieron, la pérdida en porcentaje y la ida y vuelta media. Con todas las respuestas el check se supera, con una pérdida parcial queda degradado y con silencio, caído. Así, un host desaparecido se distingue de un enlace que pierde paquetes.
Úsalo cuando
- Un host no tiene ningún servicio que merezca sondearse, pero debe ser alcanzable: una puerta de enlace, un router, un endpoint VPN o un servidor sin más.
- La pérdida en el camino hasta un host debe verse como señal propia, no diluida en un timeout de aplicación.
- La alcanzabilidad debe medirse desde varias regiones, de modo que un problema de enrutamiento en una región se vea frente a las regiones que siguen recibiendo respuestas.
Un resultado de ping no dice nada de los servicios del host. Un host que responde al ping puede tener una aplicación caída, y un host que filtra ICMP falla este check aunque sirva sin problemas. Usa el check de puerto TCP para un puerto, el check HTTP(S) para una aplicación, el check traceroute para el camino intermedio y el agente de host para un host propio.
Configuración
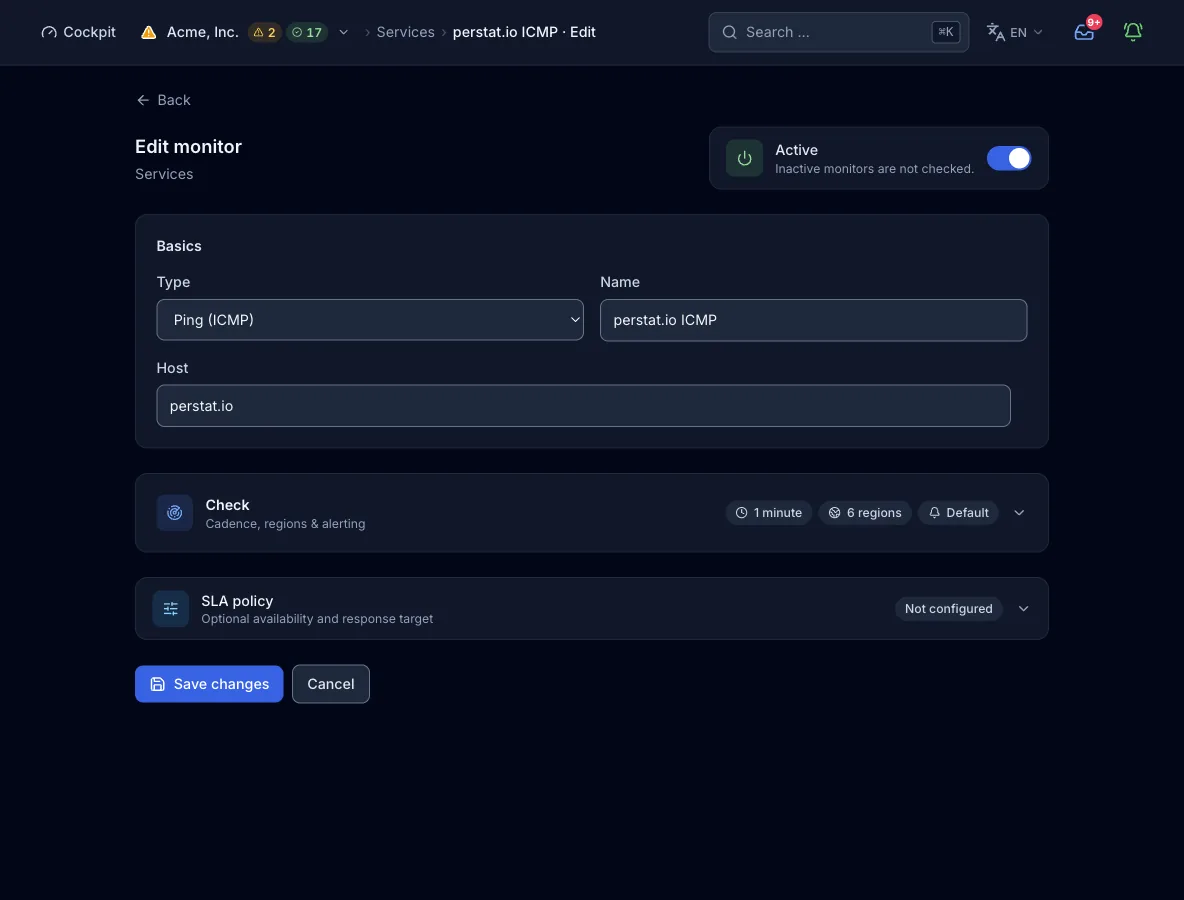
Objetivo. Un nombre de host o una dirección IP, sin esquema, ruta ni puerto. Las etiquetas admiten hasta 63 caracteres, y el nombre completo, hasta 253. La sonda resuelve el nombre con su propio resolver y bloquea las direcciones de loopback, privadas y link-local. También se bloquean las direcciones de metadatos de nube, NAT de operador, multidifusión y difusión, así que el monitor no puede apuntar a una red interna.
| Campo | Obligatorio | Valores y valor por defecto | Significado |
|---|---|---|---|
hostHost | sí | Nombre de host o dirección IP | El host que recibe las peticiones echo. Cada dirección a la que resuelve en la familia IP elegida recibe su propio ping. |
count | opcional | 1-255, por defecto 3. Un valor de 0 cuenta como 1, y por encima de 255 el check termina en error | Paquetes echo por dirección y check, enviados uno tras otro. Se fija por API o MCP, y un monitor creado en el formulario usa 3. |
interval_secondsIntervalo del check | opcional | Por defecto 300. Se eleva al mínimo del plan, con un máximo de 24 h | Cada cuánto ejecuta el check cada región. El formulario ofrece valores predefinidos de 30 s a 1 h, y los intervalos de 15 s o 10 s requieren MCP. |
regionsRegiones | opcional | Subconjunto de na, eu, as, sa, af, oce. Por defecto: las regiones del plan | Qué continentes ejecutan el check. Más regiones de las que permite el plan se rechazan, no se recortan. |
Familias IP
Con las dos familias, cada dirección resuelta de cada familia recibe su propio ping. El resultado conserva un subresultado por familia y por dirección, así que un fallo solo de IPv6 se ve como tal. El formulario ofrece IPv6 solo cuando el host tiene un registro AAAA o es un literal IPv6, y entonces solo quedan seleccionables las regiones que sondean IPv6.
| Campo | Obligatorio | Valores y valor por defecto | Significado |
|---|---|---|---|
address_familiesFamilias IP | opcional | Lista con ipv4, ipv6 o ambas. Ausente o vacía significa ["ipv4"] | Qué familias IP cubre el check. |
family_fail_severity | opcional | degraded (por defecto) o failed | Qué significa que falle una familia mientras la otra responde. Dentro de una familia, una dirección que calla entre varias es siempre degraded. |
Cómo se ejecuta un check
- Cada región a la que le toca el intervalo resuelve el host con el resolver propio del nodo. Un nombre que resuelve a un rango bloqueado termina el check como caído.
- Cada dirección resuelta de la familia elegida recibe
countpeticiones echo de 32 bytes, una tras otra. Cada petición espera hasta 10 s su respuesta, y una respuesta ausente cuenta como perdida. - Por dirección, la sonda calcula la pérdida en porcentaje y la ida y vuelta media de las respuestas. Todas las respuestas significan passed, algunas perdidas significan degraded y ninguna significa failed.
- Varias direcciones de una familia se combinan en un veredicto: todas en silencio es caído, algunas en silencio es degradado y, si no, cuenta el peor resultado por dirección. Entre familias,
family_fail_severitydecide qué significa que falle una familia. - El resultado de la región va al control plane. Se abre un incidente cuando el quórum de la política de alertas lo confirma, por defecto 2 regiones y 2 checks consecutivos.
Qué contiene un resultado
- Respuestas y pérdida
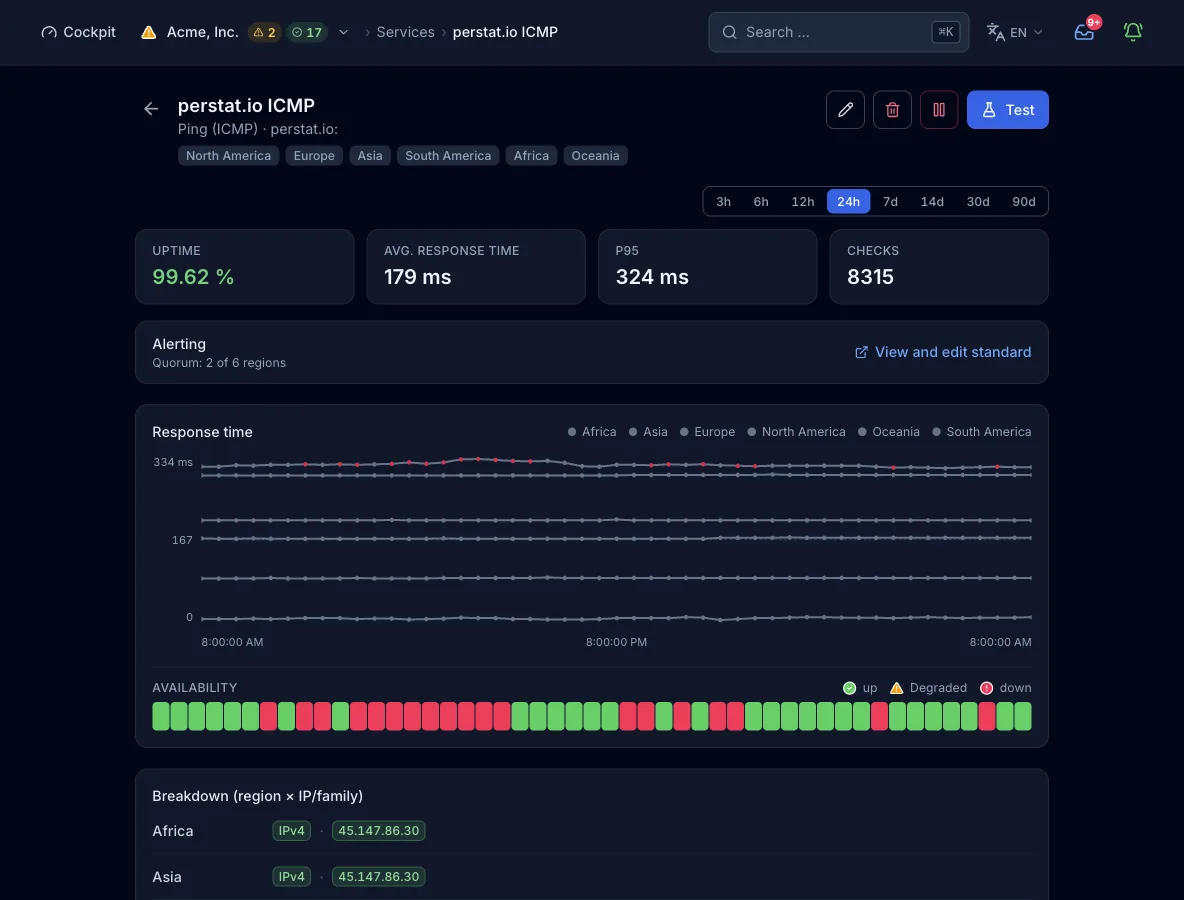
- Una línea por dirección con las respuestas recibidas de los paquetes enviados, la pérdida en porcentaje y la ida y vuelta media. Por ejemplo: 3 respuestas de 3 enviados, sin pérdida, 12 ms de media.
- Tiempo de respuesta
- La ida y vuelta media de las respuestas por dirección. Entre varias direcciones, el mínimo se convierte en el tiempo de respuesta del check.
- Capa de causa
- Un nombre que no existe (NXDOMAIN o NODATA) se atribuye al DNS del objetivo. Otros fallos de resolución quedan sin atribuir. Una vez resuelto el nombre, las respuestas perdidas se atribuyen al objetivo.
- Región, familia, dirección
- Cada resultado lleva la región que lo midió. Contiene un subresultado por familia IP y por dirección, cada uno con su propio estado, ida y vuelta y línea de detalle.
Estados y gravedad
- okTodos los paquetes a todas las direcciones recibieron respuesta.
- degradadoSe perdieron algunos paquetes, o una de varias direcciones se quedó en silencio. Con la gravedad por defecto, una familia IP que falla mientras la otra responde también cuenta como degradado.
- caídoNinguna dirección respondió, ya sea porque el host está apagado, es inalcanzable o filtra ICMP. El check también está caído cuando el nombre no resuelve, cuando el objetivo está en un rango bloqueado o cuando falla una familia con
family_fail_severityenfailed. - errorEl nodo no puede enviar ICMP, por ejemplo porque se le rechaza el socket raw. Cuenta como caída con gravedad critical.
Confirmado por quórum: por defecto, 2 regiones deben informar del fallo antes de que se abra un incidente. El valor por defecto de la organización pide 2 regiones y 2 checks consecutivos. Un monitor puede llevar su propia regla (número o porcentaje, checks consecutivos, duración mínima).
Planes y límites
- Intervalo mínimo
- 300 s en Free, 60 s en Pulse y 30 s en Sentinel. Command permite 15 s y Enterprise 10 s, ambos solo por MCP. El formulario ofrece valores predefinidos de 30 s a 1 h.
- Regiones
- 2 de 6 en Free, 3 de 6 en Pulse y las 6 desde Sentinel.
- Monitores
- 10 en Free, 50 en Pulse, 150 en Sentinel y 500 en Command. En Enterprise, los cupos son a medida. El cupo se cuenta entre los once tipos de check de sonda, y los agentes de host y los heartbeats tienen cupos propios.
Desde la pipeline o un agente
La misma config sirve en el paso de despliegue, en un cliente MCP como Claude Code y en el formulario de arriba. create_monitor necesita una clave de API válida para toda la organización. Si omites regions, el plan aplica su valor por defecto.
{
  "name": "Office gateway",
  "type": "ping",
  "interval_seconds": 60,
  "config": {
    "host": "gateway.example.com",
    "count": 5
  }
}
Límites
- Un host que filtra ICMP falla el check aunque sus servicios respondan. Acompáñalo de un check TCP o HTTP(S) sobre el servicio.
- El check registra solo la pérdida y la ida y vuelta media, sin jitter, sin percentiles y sin tiempos por paquete.
- El tamaño de paquete está fijado en 32 bytes, y
countse fija por API o MCP, no en el formulario. Con un host que calla, cada paquete espera 10 s y el nodo detiene la ejecución a los 120 s, así que manténcounten 12 o menos. - Los resultados son por dirección, no por salto. La ruta corresponde al check traceroute.
- Se bloquean los objetivos en direcciones privadas, de loopback, link-local y de metadatos de nube.
- No todas las regiones sondean IPv6, así que seleccionar
ipv6restringe las regiones utilizables.