En esta página
Última revisión: 2026-09-15.
Decide según el flujo de trabajo
Perstat encaja si Opsgenie avisa a tu equipo sobre todo por la disponibilidad y quieres la medición, las guardias, la comunicación de estado y el registro resultante en un solo producto.
Otra alternativa encaja si Opsgenie es sobre todo una bandeja que agrega alertas de muchas herramientas externas. Perstat renuncia a propósito a ese modelo de fuentes de alertas, y las alertas de otras herramientas se quedan donde están.
Las rutas de migración propias de Atlassian son Jira Service Management y Compass. Evalúalas primero si lo decisivo es la integración con Atlassian o la agregación de alertas de terceros.
Qué sustituye Perstat: cuadrantes de guardias, escalado de push a SMS y a llamada, confirmación, cronologías de incidentes.
Qué ganas con el mismo cambio: monitorización con 2 regiones en Free, 3 en Pulse y las 6 desde Sentinel. El quórum es configurable para 11 tipos de check regionales, con Agent y Heartbeat excluidos. También ganas páginas de estado en tu propio dominio desde Sentinel y un registro de disponibilidad que puedes entregar a tus clientes.
Qué migrar y cuándo: la guía de migración paso a paso está en el blog. La fecha límite la pone Atlassian, no nosotros. El aviso de fin de venta y soporte de Opsgenie la fija el 5 de abril de 2027, cuando se borran los datos de clientes no migrados.
Traslada los conceptos de Opsgenie a Perstat
Opsgenie dejó de venderse a clientes nuevos el 4 de junio de 2025. Los clientes actuales pueden añadir usuarios hasta el 5 de abril de 2027 y renovar solo si el contrato vence antes de esa fecha, según la página de licencias. Tras una migración, Opsgenie se apaga 120 días después. Aquí no hay tabla de precios, y la comparación es conceptual.
La tabla muestra dónde encaja cada concepto de Opsgenie en Perstat, incluidas las dos carencias.
| Concepto de Opsgenie | En Perstat |
|---|---|
| Alertas | incidentes, confirmados por quórum desde la monitorización o abiertos a mano |
| Políticas de escalado | etapas de escalado por cuadrante: push, luego SMS, luego llamada |
| Cuadrantes y rotaciones de guardia | rotaciones con aviso de huecos de cobertura, desde Sentinel |
| Confirmación | quien confirma asume el incidente, todos los dispositivos se silencian, los recordatorios van a esa persona |
| Notificaciones por teléfono y SMS | SMS personales desde Pulse. SMS y llamadas de guardia desde Sentinel, solo números verificados, como máximo 2 llamadas por incidente |
| Monitorización de heartbeat | el job llama a una URL secreta. Si la llamada no llega tras el periodo más el margen de gracia, se abre un incidente |
| Integraciones con herramientas de monitorización | no es el modelo, porque Perstat es la monitorización. Perstat envía hacia fuera por webhooks firmados y Slack |
| Cronología del incidente y post-mortem | en el propio incidente, con medidas, publicable en tu página de estado |
| Informes | registro de disponibilidad curado, informe editorial de ejemplo, informe PDF por monitor de 7, 14, 30 o 90 días, exportación manual en CSV con manifiesto a petición |
| Agregación de alertas de muchas herramientas | no se replica, a propósito. Perstat sustituye la capa de avisos de disponibilidad y no agrega alertas de terceros |
En Perstat, el cuadrante y sus etapas de escalado sustituyen las rotaciones y las políticas de escalado de Opsgenie. No hay importación automática. Reproduce a mano la rotación y las etapas de escalado antes de la prueba en paralelo.
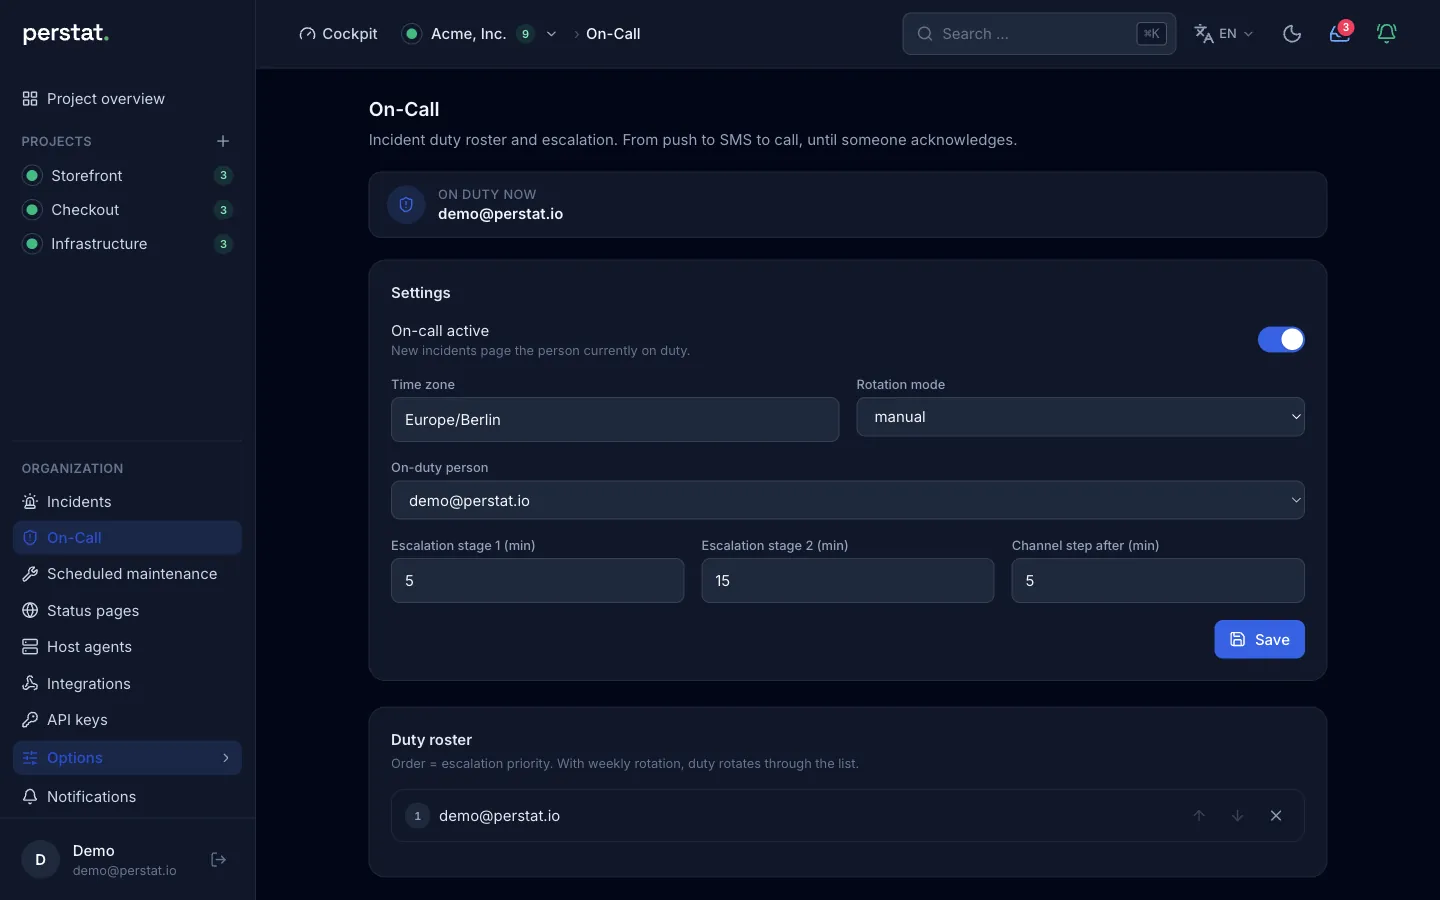
Nadie en la rotación necesita un iPhone. Los SMS desde Pulse y las llamadas del escalado de guardia desde Sentinel llegan a cualquier teléfono.
Migra en paralelo
- Haz inventario de cuadrantes, reglas de escalado, usuarios y fuentes de alertas. Separa los avisos de disponibilidad de la agregación de alertas de terceros antes de seleccionar un destino.
- Reproduce una rotación y su escalado en Perstat y mantén Opsgenie activo durante una rotación completa. Provoca un incidente controlado en un endpoint de prueba. Verifica push, SMS y llamada, y después la confirmación y la recuperación.
- Traslada los monitores de disponibilidad y el flujo de trabajo de estado solo cuando las rutas coincidan. Mantén otra vía de agregación donde haga falta, y sigue las indicaciones de Atlassian para conservar los datos necesarios antes del fin del ciclo de vida.
Empieza a monitorizar gratis o haz el tour del producto. El tour no pide registro, y el precio lo ves sin hablar con ventas.