Monitorización y diagnóstico
Las sondas regionales, los agentes de host y los heartbeats muestran si el problema está en el servicio, en DNS, en la red o en el host.
Ver monitorización de uptimeCinco partes de Perstat comparten un registro de disponibilidad, desde la monitorización hasta las interfaces y apps que lo rodean. Puedes leer cómo funciona cada una sin crear una cuenta.
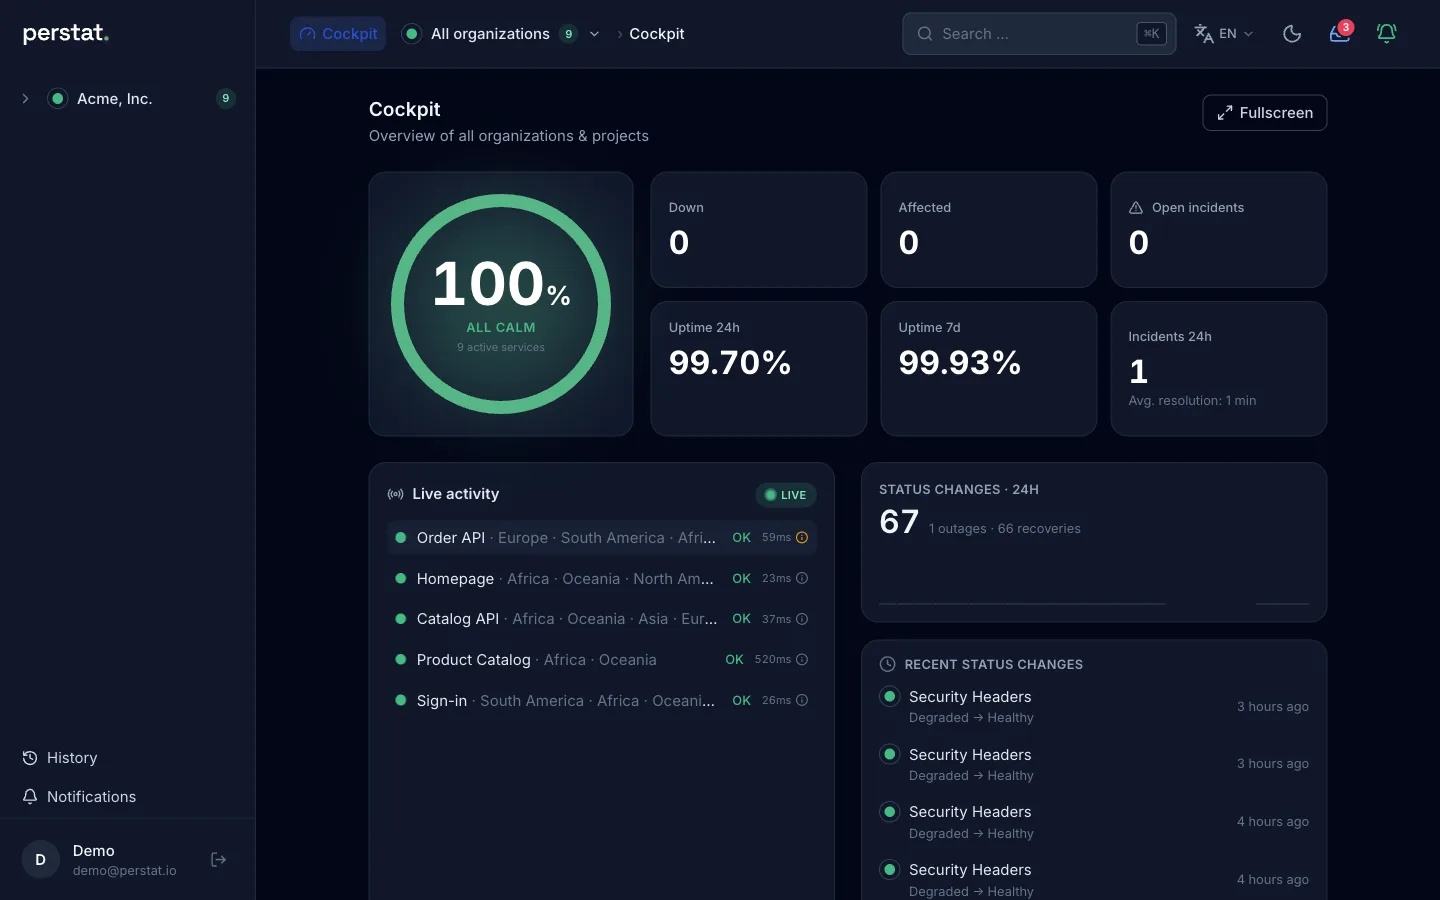
El cockpit, la cronología, la comunicación de estado y la revisión posterior se refieren al mismo evento. Perstat no copia el resultado de un check en un relato de incidente aparte.
Cada vista trabaja con el mismo evento, en lugar de pasarse una caída entre herramientas desconectadas.
Trece tipos de check observan servicios, hosts y jobs.
Once tipos de check regionales pueden exigir acuerdo entre regiones antes de que se abra un incidente.
La confirmación hace visible quién es responsable. El escalado de guardia empieza con Sentinel.
Las páginas de estado publican el incidente de forma explícita para las audiencias que selecciones.
El registro de disponibilidad mantiene juntos los eventos medidos, la curación y las acciones.
Las sondas regionales, los agentes de host y los heartbeats muestran si el problema está en el servicio, en DNS, en la red o en el host.
Ver monitorización de uptimePasa de un incidente confirmado a una responsabilidad visible, a SMS personales o al escalado de guardia.
Ver incidentes y guardiasPáginas públicas o protegidas con contraseña, alimentadas por los mismos incidentes.
Ver páginas de estadoRevisa el historial medido, las caídas curadas y la actividad de configuración atribuida.
Ver evidenciasConecta el registro con tu flujo de trabajo mediante conectores, webhooks firmados, REST, MCP o apps nativas de Apple.
Ver MCP e integracionesCada ejemplo público indica lo que puede mostrar y lo que no.
Los cinco precios y los límites de los planes son públicos, y los planes estándar son de autoservicio. La seguridad y la documentación se pueden leer sin cuenta.