En esta página
Un camino para servicios, redes, hosts y jobs
Todos los planes incluyen 13 tipos de check: HTTP, cabeceras HTTP, TCP, DNS, higiene DNS, dominio, certificado TLS, SMTP, IMAP, ping, traceroute, agent y heartbeat. Cubren servicios accesibles desde fuera, señales del host y jobs que informan de su propio resultado. Cada resultado sigue un único monitor y un único recorrido de incidente, en vez de repartirse entre herramientas distintas.
Perstat se limita a propósito al uptime y al registro que se deriva de él. No es APM y no gestiona logs.
De un resultado a un incidente confirmado
Once tipos de check se ejecutan mediante sondas regionales. Con la política estándar, una sola región no abre un incidente. El monitor necesita un quórum de 2 regiones, y esa regla es configurable.
Agent y heartbeat son las dos excepciones. Informan directamente y no usan regiones de sonda ni quórum regional.
La documentación del quórum explica ambos caminos. La página de la red de sondas documenta la topología actual y la agregación regional.
Ver la señal antes del aviso
Perstat muestra un estado en formación antes de que la política configurada confirme una caída regional. La lista de vigilancia guarda las divergencias por región, familia IP, IP individual y nodo. Así el operador recibe una señal temprana sin tratar la primera desviación como un incidente.
Los resultados confirmados conservan además el contexto de diagnóstico. Cuando corresponde, Perstat separa el tiempo de DNS y atribuye el fallo a una de estas capas:
- aplicación objetivo
- DNS del objetivo
- red
- resolver de Perstat
- nodo de sonda
HTTP, red y DNS se pueden inspeccionar
Un monitor HTTP puede comprobar un estado esperado, una palabra clave o una expresión regular. El mismo monitor puede incluir subchecks de TLS, cabeceras de seguridad e higiene DNS. Perstat sigue hasta 5 saltos de redirección y comprueba cada destino de la cadena contra la misma lista de bloqueo SSRF.
Los checks sobre registros A y AAAA conservan los resultados por familia de direcciones y por IP. Un monitor DNS puede comparar su conjunto de respuestas con el de otro monitor, por coincidencia idéntica, subconjunto o solapamiento.
Hosts y jobs informan directamente
El agente nativo admite Linux en x86_64 y aarch64, y macOS como binario universal. Informa de la disponibilidad y de los servicios con nombre, además de CPU, memoria y disco.
El agente no lee líneas de comandos, variables de entorno ni nombres de usuario. No tiene canal de comandos remotos. Por ahora no admite Windows.
Un heartbeat da a un job dos endpoints: la URL de ping y la URL de fallo. Si el silencio supera el periodo configurado más el margen de gracia, el heartbeat pasa a caído. La URL de fallo registra una ejecución fallida explícita sin esperar a esa ventana de silencio.
El mantenimiento suprime alertas y queda registrado
Una ventana de mantenimiento programada suprime nuevos incidentes, permanece en el registro de disponibilidad y se excluye del uptime. Un falso positivo descartado crea una ventana de exclusión aparte y reversible, con motivo y autor. El registro de disponibilidad explica ese recorrido de revisión.
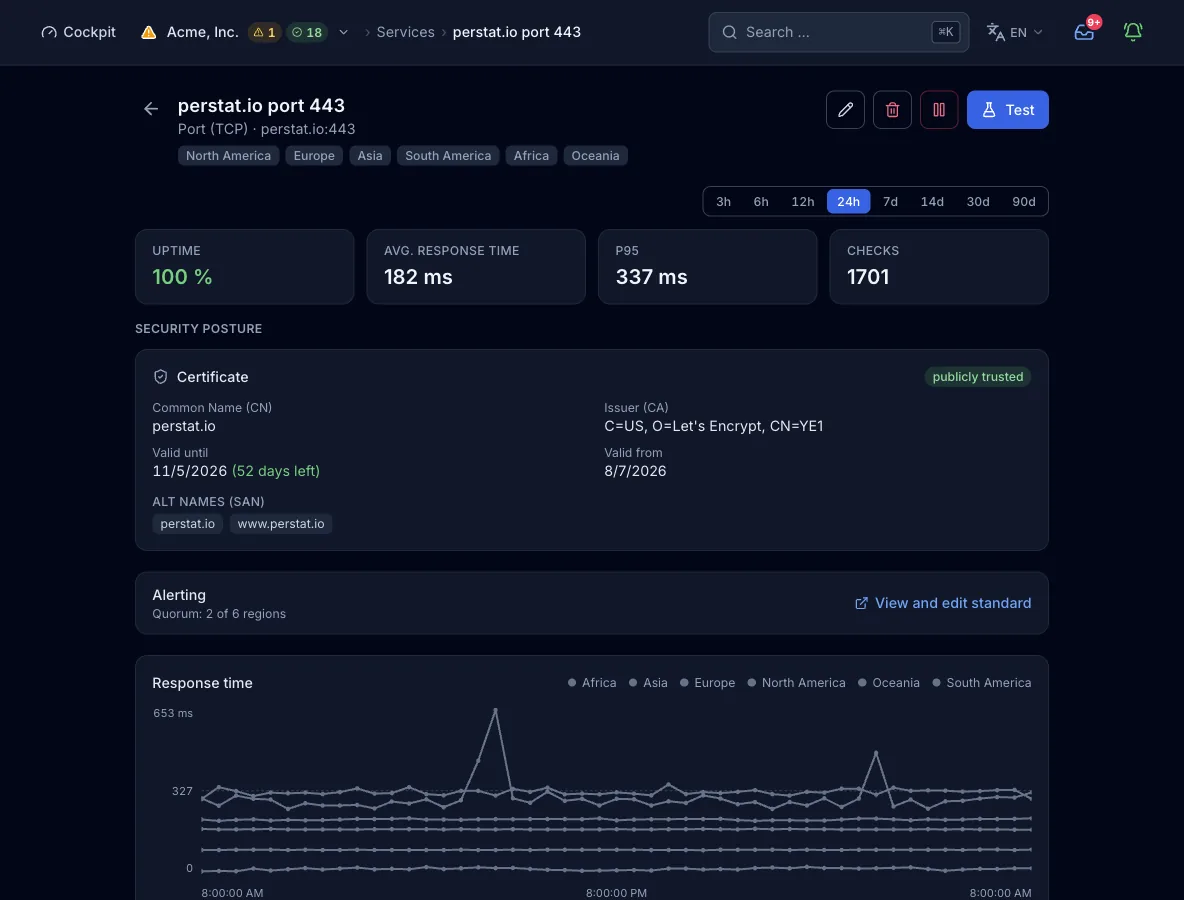
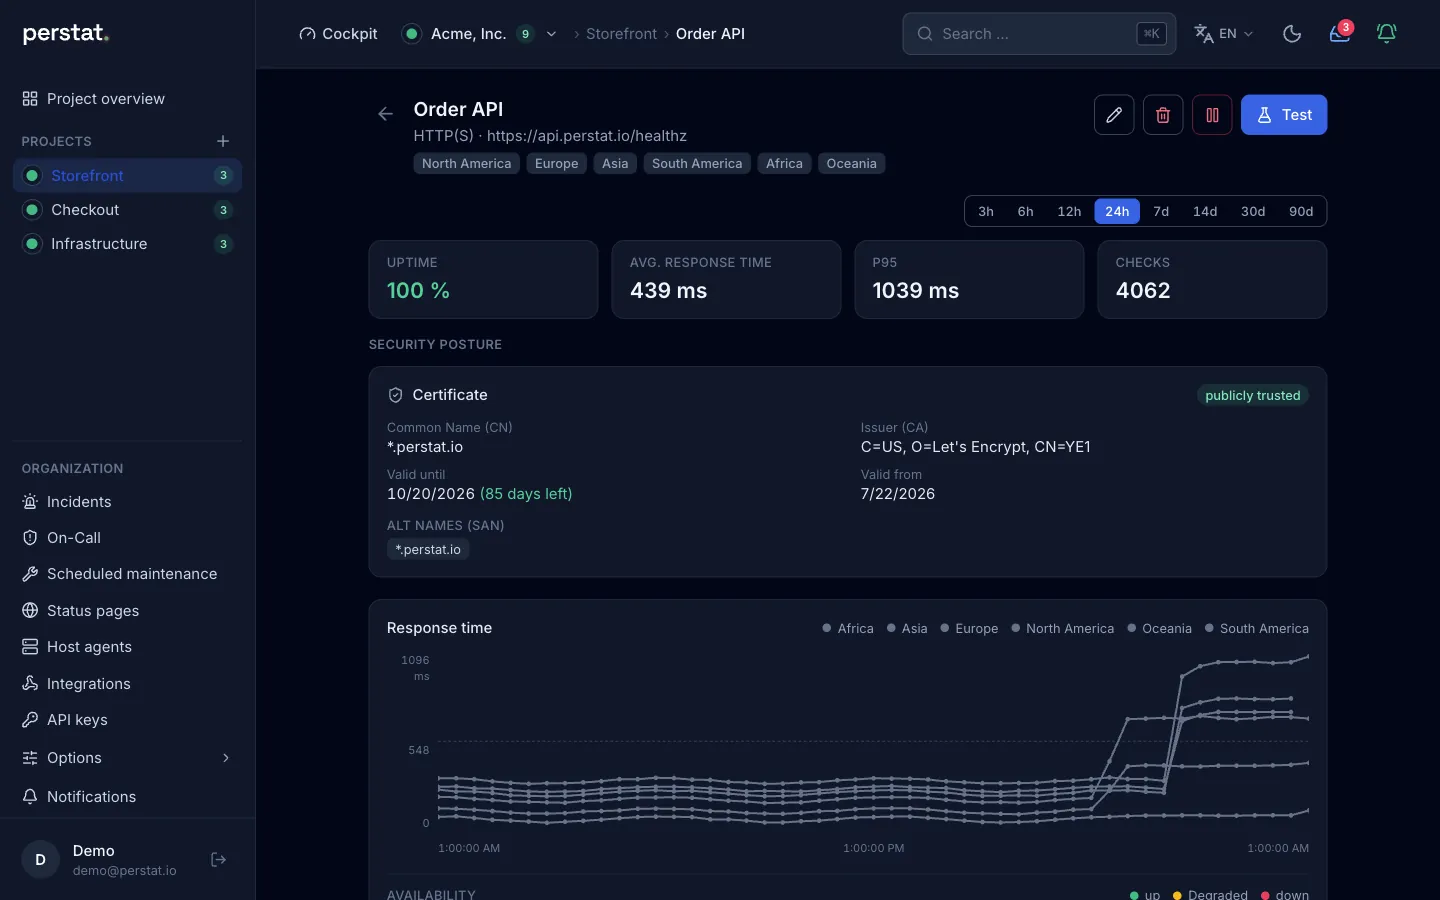
Inspeccionar un monitor real
El plan fija las regiones y el intervalo mínimo
| Plan | Regiones de sonda | Intervalo mínimo (segundos) |
|---|---|---|
| Free | 2 | 300 |
| Pulse | 3 | 60 |
| Sentinel | 6 | 30 |
| Command | 6 | 15 |
| Enterprise | 6 | 10 |
El formulario web ofrece 30 segundos o más. En Command y Enterprise, configuras 15 o 10 segundos mediante MCP.
Las regiones de sonda son:
- Norteamérica
- Sudamérica
- Europa
- África
- Asia
- Oceanía
Los límites exactos de monitores, agentes, heartbeats y retención están en la página de precios.
Empieza a monitorizar gratis, o configura el primer monitor con la documentación de monitores.