Pas de déploiement sans monitor.

Votre pipeline ou son agent de code (Claude Code, Codex, ChatGPT) déclare le monitor via MCP. Par défaut, deux régions confirment la panne avant que quiconque soit alerté, et chaque incident entre dans votre registre de disponibilité avec sa durée.

Essayez Sentinel gratuitement pendant 90 jours, sans carte bancaire. Tous les tarifs sont publics. Datargo GmbH, en Allemagne, exploite Perstat sur un plan de contrôle situé dans l’UE.

Statut de Perstatpage de statut
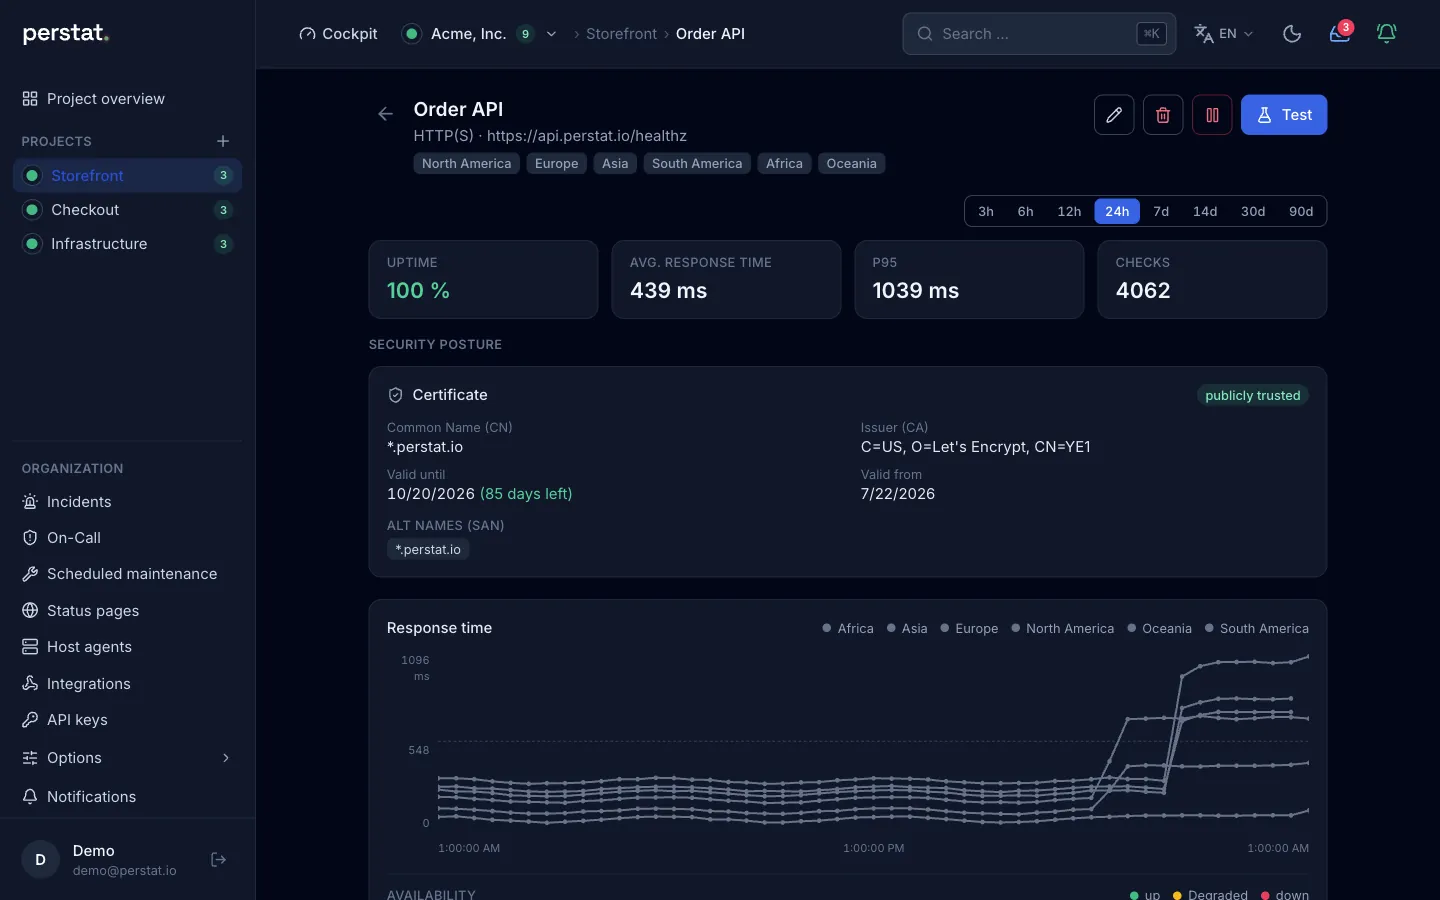
Vue du monitor Order API dans Perstat, avec ses régions de vérification, l’uptime, les temps de réponse et les détails du certificat
deploy · order-api 2.16.0Exemple
  1. build
  2. deploy
  3. register monitor

Order API créé, vérifié depuis 6 régions

La vue d’un monitor sur app.perstat.io. Interface réelle du produit, données d’exemple. La carte de déploiement est un exemple.

Les releases devancent les monitors manuels

Services, endpoints et jobs passent en production chaque semaine. Suivez un déploiement dans Perstat, du pipeline jusqu’au registre de disponibilité.

Passer le récit
Passer le récit
  1. Chaque release ajoute quelque chose à surveiller

    order-api 2.16.0 ajoute un webhook de paiement. Sur les 8 derniers déploiements, 3 ont livré un endpoint, un job ou un service sans monitor, car créer un monitor était une tâche à part.

    Journal des déploiementsExemple
    1. 09-10 14:02order-api 2.16.0+ /webhooks/paymentssans monitor
    2. 09-10 11:47search-indexer 1.9.3worker poolsurveillé
    3. 09-09 17:20checkout-web 4.2.0+ /api/cart/v2sans monitor
    4. 09-09 09:15auth-service 3.1.1token rotationsurveillé
    5. 09-08 16:40image-resizer 0.7.0new servicesans monitor
    6. 09-08 10:05mail-relay 1.4.2patchsurveillé
    7. 09-05 15:30order-api 2.15.4patchsurveillé
    8. 09-05 08:12status-sync 0.3.0cron jobsurveillé

    3 déploiements sur 8 ont ajouté quelque chose sans monitor

  2. Intégrez le monitor au déploiement

    Une étape après le job de release suffit. Elle appelle l’endpoint MCP avec une clé API de l’organisation. En cas d’erreur, elle fait échouer le job, sauf si le monitor existe déjà.

    deploy.ymlExemple
    # après le job de release : déclarer le monitor- name: Register monitor  run: |    result=$(curl -sS --fail-with-body https://api.perstat.io/mcp \      -H "Authorization: Bearer $PERSTAT_API_KEY" \      -H "Content-Type: application/json" \      -d '{"jsonrpc":"2.0","id":1,"method":"tools/call","params":{        "name":"create_monitor","arguments":{"project_id":"prj_…",        "name":"Order API","type":"http",        "config":{"url":"https://orders.example.com/health"}}}}')    echo "$result" | jq -e '.result.isError == false      or (.result.content[0].text        | contains("already runs exactly this check"))'
  3. Déployez souvent, gardez un seul monitor

    Le résultat renvoie le nouveau monitor. L’exécution suivante est refusée comme doublon exact, et l’étape réussit quand même. Si le chemin du health check change, update_monitor modifie le monitor existant au lieu d’en ajouter un second.

    mcp › create_monitor, appelé par votre pipeline ou votre agent de codeExemple
    {  "created": true,  "monitor": {    "id": "mon_…",    "archived": false,    "name": "Order API",    "type": "http",    "project_id": "prj_…",    "enabled": true,    "interval_seconds": 300,    "regions": ["na", "eu", "as", "sa", "af", "oce"],    "status": "unknown",    "severity": null  }}
    Déploiement suivant

    `Order API` (mon_…) already runs exactly this check in this project: same type, identical config, every 300 s from 6 region(s).

  4. Six régions lancent les checks

    Des nœuds de sonde sur 6 continents exécutent le check selon son intervalle. Perstat enregistre chaque résultat avec la région qui l’a mesuré.
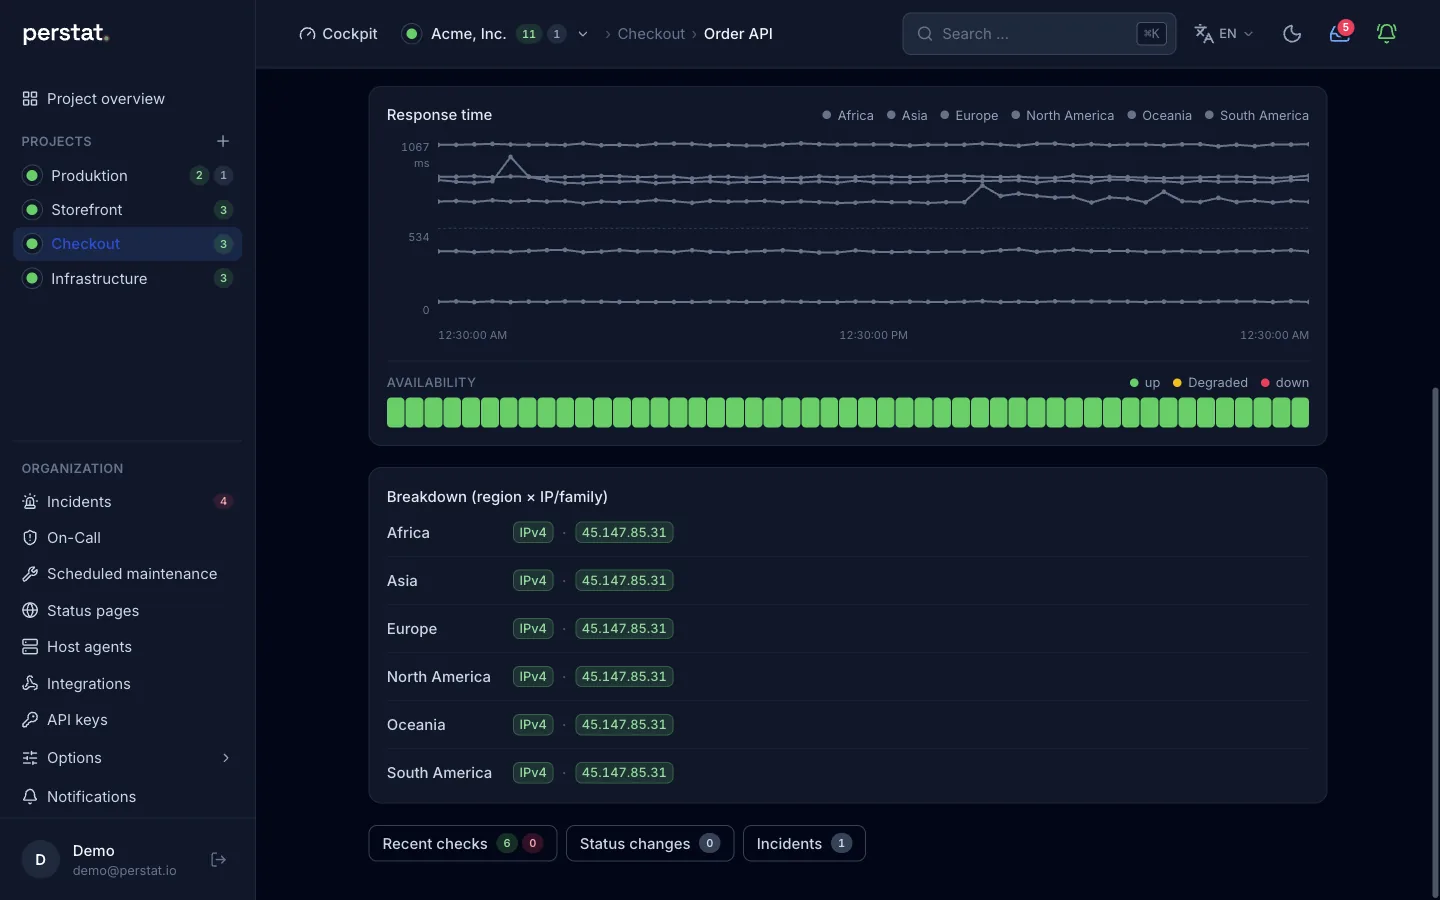
    Vue d’un monitor Perstat avec les temps de réponse par région et la répartition des résultats par région
    • naAmérique du Nord
    • saAmérique du Sud
    • euEurope
    • afAfrique
    • asAsie
    • oceOcéanie
  5. Deux régions confirment la panne

    Un échec dans une région reste un signalement discret, pas une alerte. Quand une deuxième région signale aussi un échec, le quorum par défaut confirme la panne et ouvre exactement un incident.

    Quorum pour Order APIExemple
    • naewrNewarkÉchec
    • sagruSão PauloOK
    • eufraFrancfortOK
    • afjnbJohannesbourgOK
    • assgpSingapourÉchec
    • ocesydSydneyOK

    na (Newark) signale un échec : signalement discret, personne n’est encore alerté.

    as (Singapour) signale aussi un échec : quorum atteint, incident ouvert à 02:41:12 UTC.

  6. L’alerte gravit les paliers jusqu’à l’acquittement

    Perstat vous alerte sur iPhone et Apple Watch, ainsi que sur Slack, Teams ou PagerDuty via les connecteurs. L’escalade d’astreinte passe ensuite au SMS, puis à un appel téléphonique, jusqu’à l’acquittement.

    Escalade d’astreinte : Sentinel et offres supérieures
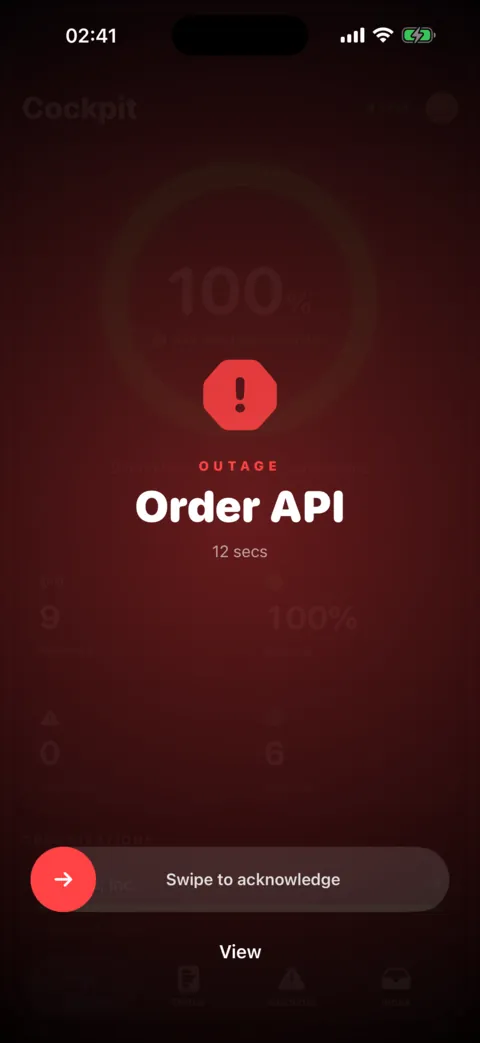
    Alerte de panne Perstat en plein écran pour Order API sur iPhone, avec une commande à faire glisser pour acquitter
    Escalade d’astreinte jusqu’à l’acquittement
    1. PushNotification native sur iPhone et Apple Watch.
    2. SMSUn palier temporisé de l’escalade d’astreinte.
    3. Appel téléphoniqueLe dernier palier de l’escalade d’astreinte, sur tout téléphone.
    4. AcquittéLa prise en charge est visible, et les autres appareils se taisent.
    Aussi via les connecteurs
    • Slack
    • Microsoft Teams
    • Discord
    • Google Chat
    • PagerDuty
    • Opsgenie
    • Webhook

    Alertes SMS personnelles sans rotation : Pulse et offres supérieures

    acknowledge_incidentOu depuis le terminal : votre agent appelle acknowledge_incident via MCP, et l’appel est attribué au titulaire de la clé.

  7. La page de statut informe vos clients

    L’incident ouvert par le quorum apparaît sur la page de statut liée avec sa phase actuelle, et le composant passe à Down. Personne n’a besoin de le recopier à la main.

    status.example.comExemple

    Major outage

    • Order APIDown
    • StorefrontOperational
    • SearchOperational
    AcknowledgedOrder API02:41:12 UTC
  8. L’incident entre dans le registre de disponibilité

    Quand les régions signalent le rétablissement, l’incident se clôt avec son début, sa fin et sa durée confirmés. La maintenance annoncée est exclue pendant sa fenêtre. Perstat calcule la disponibilité à partir du même registre.

    Registre de disponibilitéExemple
    Order APIQ2 2026
    1. 2026-05-03 02:41:12Incident, confirmé par quorum00:07:12
    2. 2026-05-17 22:00:00Maintenance, annoncée et exclue01:30:00
    Disponibilité brute
    99,925 %
    Hors maintenance annoncée
    99,994 %

    Export : rapport PDF par monitor sur 7 à 90 jours. CSV avec manifeste sur demande.

  9. Vos clients voient l’état avant de demander

    Votre page de statut, sur votre propre domaine, affiche l’état, comme ici une mise à niveau planifiée de la base de données. La page et le badge de votre site lisent le registre dont provient le chiffre de disponibilité.

    Domaine personnalisé : Sentinel et offres supérieures
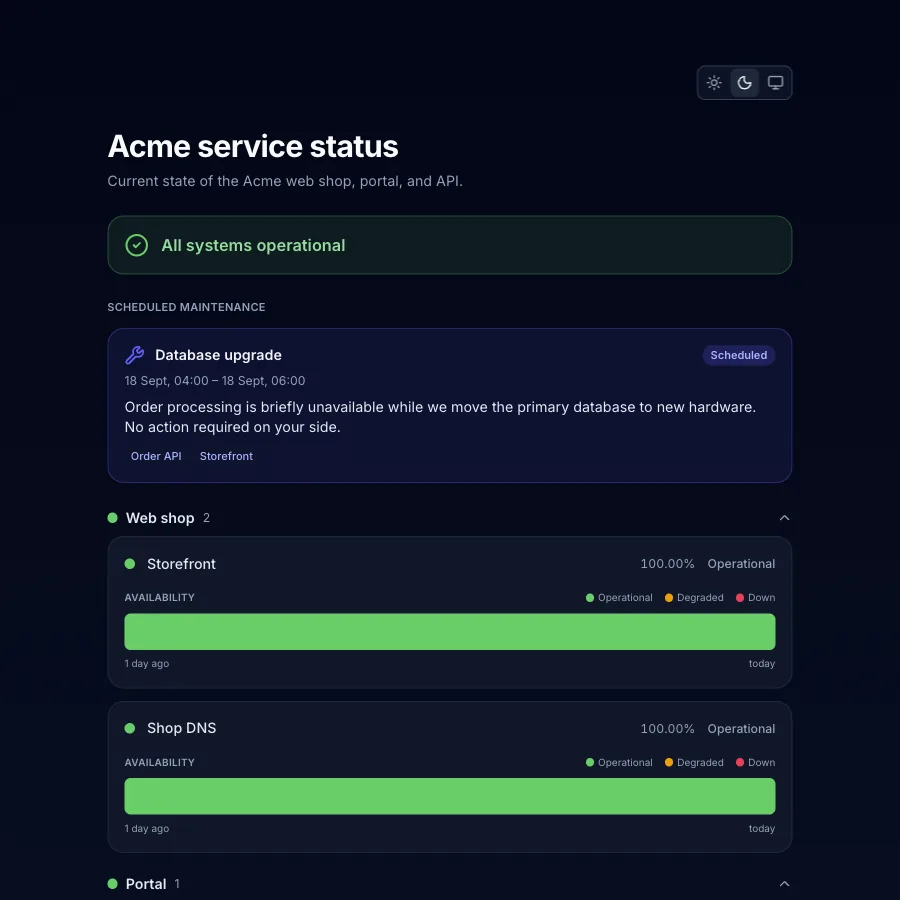
    status.example.comDonnées d’exemple
    Une page de statut destinée aux clients, avec des composants groupés, des barres de disponibilité sur 90 jours et un avis de maintenance planifiée
    Badge de statut : opérationnel <img src="https://status.example.com/badge.svg" alt="Service status"> Le même badge sur votre site, servi sous votre domaine. Il montre ce que montre la page.
Tous les types de checks et leurs options Ouvrir l’exemple de rapport SLA Voir la page de statut publique de Perstat

Quatre pannes documentées, chacune avec sa source

Le monitoring raccourcit le temps qu’il vous faut pour savoir, garde une vue depuis l’extérieur quand vos propres outils tombent, porte le message à vos clients et laisse une trace. Il n’empêche pas une panne.

  1. Google Cloud : couche d’API en panne mondiale

    La perturbation principale a duré environ 3 heures et s’est produite à l’échelle mondiale, et le rétablissement de us-central1 a pris environ 2 h 40 min. Les produits concernés allaient des services dépendant d’IAM à BigQuery, Cloud Storage et Vertex AI. Workspace et des clients comme Cloudflare ont aussi été touchés.

    Le 29 mai, une fonctionnalité de contrôles de politique de quota supplémentaires est arrivée dans Service Control sans feature flag et sans gestion d’erreur sur le nouveau chemin. Le 12 juin, un changement de politique a produit des champs vides, et les binaires ont planté dans le monde entier sur une erreur de pointeur nul. Google a écrit que son premier rapport d’incident était paru environ une heure après le début des plantages, parce que l’infrastructure de Cloud Service Health était elle-même tombée. Google a aussi écrit que, pour certains clients, l’infrastructure de monitoring qu’ils faisaient tourner sur Google Cloud tombait également, ce qui les laissait sans signal de l’incident.

    Ce que montre un check depuis l’extérieurCette dernière phrase plaide pour le monitoring externe, dans les mots de l’exploitant lui-même : un monitoring sur la même plateforme tombe avec elle. Perstat vérifie depuis l’extérieur, depuis 6 régions au plus, avec quorum, et son infrastructure de sondes ne tourne pas sur la plateforme qu’elle surveille. Une page de statut sur une infrastructure séparée aurait informé vos clients pendant cette heure.

    Source : Rapport d’incident Google Cloud, 2025-06-12 · The Register, 2025-06-16

  2. Atlassian : un script supprime 883 sites clients

    La panne a touché 775 clients et a duré jusqu’à 14 jours, le temps de restaurer le dernier site. Jira, Confluence et Access leur étaient indisponibles, tout comme Opsgenie et Statuspage. Aucun client n’a perdu plus de 5 minutes de données.

    Un script destiné à supprimer les instances d’une app retirée a reçu des identifiants de sites au lieu d’identifiants d’apps. Il a supprimé des sites clients entiers pendant 23 minutes, à partir de 07:38 UTC. Le premier ticket client est arrivé à 07:46 UTC, au bout de 8 minutes, et le processus d’incident majeur a démarré à 08:17 UTC. La première mise à jour de la page de statut est venue à 09:03 UTC, au bout de 85 minutes, et la première déclaration externe large sur les réseaux sociaux le 7 avril, au bout de 41 heures. La restauration a pris jusqu’à 14 jours et n’était que partiellement automatisée.

    Ce que montre un check depuis l’extérieurUn check HTTP de votre propre URL de tenant depuis plusieurs régions signale la panne après 2 checks consécutifs en échec, sans attendre un ticket de support. Certains clients ont perdu Statuspage et Opsgenie avec leurs sites. La page de statut et l’alerte ne doivent donc pas se trouver chez le fournisseur dont elles sont censées montrer la panne. Aucun monitoring n’aurait raccourci les 14 jours.

    Source : Revue post-incident Atlassian, 2022-04-29

  3. Marketo : renouvellement manqué, les clients se plaignent publiquement

    La connexion, les formulaires intégrés ainsi que les images et liens des e-mails ont été perturbés pour chaque client, tout comme l’intégration Salesforce et le suivi d’activité. La panne était en grande partie résolue à 12:00 PDT, avec des effets de propagation de 24 à 48 heures.

    Le PDG a écrit que l’entreprise renouvelle chaque année des milliers de domaines avec précision, mais que le processus de renouvellement automatique de son domaine principal avait échoué. La déclaration citait une erreur humaine et de processus comme cause. Les clients se sont plaints publiquement sur Twitter.

    Ce que montre un check depuis l’extérieurUn check de domaine signale la date d’expiration des jours à l’avance, depuis un système qui ne dépend pas du renouvellement automatique défaillant. Un check DNS depuis plusieurs régions aurait signalé la perte de résolution après 2 checks consécutifs en échec. Une page de statut sur un autre domaine aurait porté le message pendant que marketo.com ne se résolvait plus, mais aucun check ne peut renouveler le domaine.

    Source : Base de connaissances Marketo (Adobe), P1 du 25 juillet 2017 · The Drum, 2017-07-26

  4. GitLab.com : base supprimée, 5 chemins de sauvegarde défaillants

    Environ 18 heures d’indisponibilité, en grande partie consacrées à la restauration. Six heures de données ont été perdues : environ 5 000 projets, 5 000 commentaires et 700 nouveaux comptes. Les dépôts et les wikis n’ont pas été touchés.

    En réparant la réplication, un ingénieur a supprimé le répertoire de données sur le primaire au lieu du secondaire. Les sauvegardes pg_dump n’existaient pas, parce que le script lançait pg_dump 9.2 contre PostgreSQL 9.6 et échouait. GitLab a écrit que les notifications des jobs cron en échec partaient par e-mail, mais que DMARC n’était pas activé pour ces e-mails, si bien que le destinataire les rejetait. Les instantanés de disque n’étaient pas activés pour les serveurs de base de données, et il ne restait qu’un instantané LVM manuel, vieux de 6 heures.

    Ce que montre un heartbeatUn heartbeat fonctionne comme un dead man’s switch : le job de sauvegarde se signale après un succès, et Perstat alerte si le signal manque, qu’un e-mail d’erreur arrive ou non. Le cas montre aussi que l’alerte ne doit pas dépendre d’un seul canal susceptible de tomber lui-même. L’escalade doit donc passer par plusieurs voies et exiger un acquittement. Un heartbeat ne vérifie pas si la sauvegarde peut être restaurée. Cela reste le rôle d’un test de restauration.

    Source : Post-mortem GitLab, 2017-02-10 · The Register, 2017-02-01, sur les 5 techniques de sauvegarde

Lire tous les cas documentés et leurs sources

Perstat remplace checks, pages de statut et astreinte uptime

Perstat couvre la chaîne qui va du check en échec jusqu’à la preuve. Ce n’est pas une suite d’observabilité, et c’est voulu.

  • Checks d’uptime

    À la place d’UptimeRobot, de Pingdom ou des checks d’uptime d’une suite plus large : 13 types de checks depuis des régions nommées.

  • Page de statut

    À la place d’Atlassian Statuspage : des pages publiques ou protégées, alimentées par les mêmes monitors et incidents.

  • Astreinte uptime

    À la place du volet uptime d’Opsgenie ou de PagerDuty : l’acquittement depuis le téléphone, plus les plannings et l’escalade.

Les logs, traces, APM et alertes d’autres outils restent là où ils sont. Perstat ne les ingère pas.

Laissez agir pipelines et agents sans risquer l’historique

L’endpoint MCP qui déclare les monitors sert aussi les agents et les scripts. Chaque écriture est attribuée à la personne qui a créé la clé, dont le rôle actuel est vérifié à chaque appel.

Lire la documentation MCP
Outils d’écriture via MCPtools/call
  • create_projectCréer un projet
  • create_monitorCréer un monitor
  • update_monitorModifier le nom, les réglages, l’intervalle ou les régions
  • set_monitor_enabledMettre en pause ou reprendre un monitor
  • archive_monitorArchiver un monitor et libérer sa place dans l’offre
  • restore_monitorRestaurer un monitor archivé, en pause
  • acknowledge_incidentAcquitter un incident
  • resolve_incidentRésoudre un incident
  • delete_monitorN’existe pas, car supprimer un monitor supprimerait aussi son historique d’incidents.
MCP
Lire monitors et incidents, créer et modifier des monitors, acquitter et résoudre des incidents. La création de monitors exige une clé API valable pour toute l’organisation.
REST et webhook
Des lectures REST pour les tableaux de bord et le reporting, plus un webhook signé pour vos propres automatisations.
Notifications
Slack, Microsoft Teams, Discord, Google Chat, PagerDuty et Opsgenie.

Apps natives pour iPhone, iPad et Apple Watch

Les apps affichent les alertes en plein écran, permettent d’acquitter d’un glissement et placent l’incident ouvert en activité en direct sur l’écran verrouillé. Il n’existe pas d’app Android native, mais les SMS dès Pulse et les appels d’astreinte dès Sentinel atteignent tout téléphone.

Voir dans l’App Store
25 secondes · sans son
L’alarme atteint la personne d’astreinte. Vraie application iPhone. Vidéo en anglais avec des données fictives. Alarme → Silence → Prise en charge. Le service reste indisponible jusqu’à la résolution de la panne.

Commencez gratuitement, évoluez sans appel commercial

Chaque offre et chaque limite figurent sur la page, Enterprise compris. Free, Pulse, Sentinel et Command se souscrivent en libre-service, et Enterprise commence par une demande.

Balayez horizontalement pour comparer toutes les offres

Comparatif compact des cinq offres Perstat
Ce qui change avec chaque offreFree0 €/ moisPulse29 €/ moisSentinel89 €/ moisL’astreinte commence iciCommand249 €/ moisEnterpriseà partir de 690 €/ mois
Monitors1050150500sur mesure
Utilisateurs131530sur mesure
Intervalle minimal300 s60 s30 s15 s10 s
Régions de sondes2 sur 63 sur 6les 6les 6les 6
Historique public*7 jours30 jours90 jours1 an2 ans
Pages de statut11520sur mesure
Astreinte, incidents manuels, post-mortemsnonnoninclusinclusinclus

Prix mensuels en EUR, nets, hors TVA. Le tarif Enterprise part du montant affiché. *Ces valeurs limitent l’historique public des incidents résolus. Les autres objets de données suivent actuellement des règles distinctes de stockage et de suppression. Consultez les limites de rétention documentées avant l’achat.

  • Plan de contrôle dans l’UE

    Exploité par Datargo GmbH, en Allemagne.

  • Régions nommées

    Les emplacements des sondes sont listés par nom, et non cachés derrière une carte du monde.

  • Un état vérifiable

    Les captures du produit, la page de statut publique, l’exemple de rapport et les limites d’achat actuelles sont visibles sans connexion.

Intégrez le monitor à votre prochain déploiement

Commencez avec Free : 10 monitors dans 2 régions. Créez une clé API d’organisation et ajoutez une étape à votre pipeline.