Sur cette page
Ce qu’il vérifie
Un monitor d’agent hôte se rattache à un agent installé sur l’un de vos hôtes et surveille une métrique. availability surveille si l’agent se signale encore. cpu, mem et disk comparent un usage en pourcentage à un seuil, et service vérifie qu’un processus nommé tourne. L’agent rapporte au plan de contrôle, et le serveur juge le dernier rapport toutes les 30 s environ. Un dépassement ouvre un incident, avec un push selon notify_push, ou ne déclenche qu’une notification dans l’app, selon breach_severity. Un agent porte plusieurs monitors, un par métrique ou par processus.
À utiliser quand
- Un hôte fait tourner quelque chose sans port à sonder, ou le port répond encore alors que l’hôte n’a plus de mémoire ni de disque.
- Un processus doit rester en marche : une base de données, un worker de file ou un reverse proxy. Un redémarrage plus court que la période de grâce ne compte pas comme dépassement.
- Un hôte doit donner l’alarme quand il cesse tout à fait de rapporter, avec une période de grâce pour qu’un redémarrage dans ce délai n’ouvre aucun incident.
Le check ne mesure rien par le réseau. La joignabilité d’un port ou d’une URL depuis Internet demande le check ping, TCP ou HTTP(S). Un job cron ou un traitement par lots sans processus à surveiller demande le check heartbeat.
Configuration
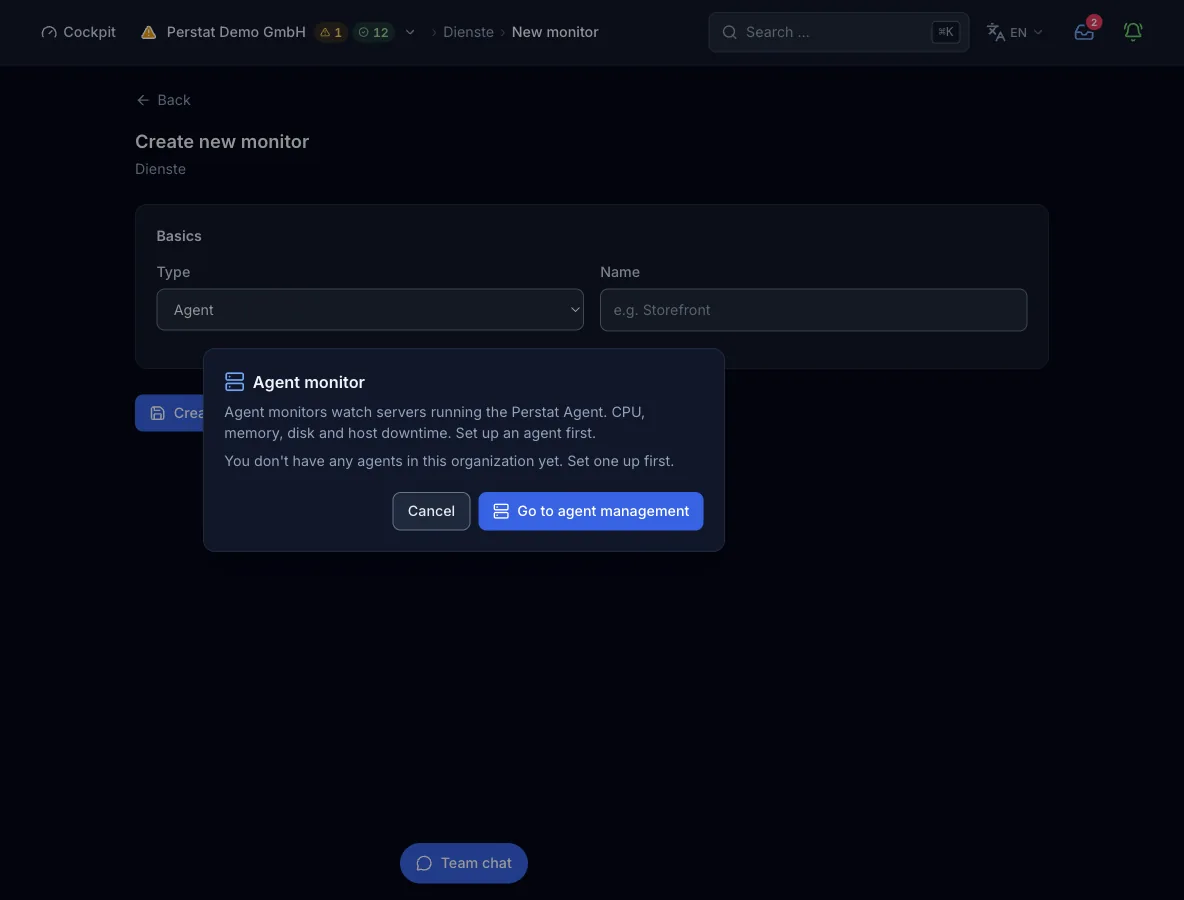
Agent. Pas de cible réseau. Le monitor se rattache à un agent hôte de votre organisation par son agent_id, et le formulaire liste les agents enregistrés. Le rapport vient de l’hôte, le check ne prend donc ni régions, ni familles IP, ni intervalle propre.
| Champ | Requis | Valeurs et défaut | Signification |
|---|---|---|---|
agent_idAgent | oui | Identifiant public d’un agent enregistré dans votre organisation | L’hôte que le monitor surveille. Le formulaire liste les agents enregistrés, et l’API et MCP prennent l’identifiant. |
metricMétrique | oui | availability, cpu, mem, disk, service | Ce que le serveur juge : les signalements de l’agent, un usage en pourcentage pour CPU, mémoire ou disque, ou un processus en marche. Un monitor surveille une métrique. |
thresholdSeuil | facultatif | Pourcentage, 0 à 100, défaut 90. Utilisé par cpu, mem et disk | Une valeur au-dessus du seuil est un dépassement. Ignoré par availability et service. |
grace_seconds | facultatif | 60 à 3600 s. Défaut 180 pour availability, 120 pour service | Combien de temps l’agent peut rester muet, ou le processus arrêté, avant que la passe compte un dépassement. Un écart plus court ne compte pas. Ce champ se règle par l’API ou MCP, et le formulaire garde la valeur enregistrée quand vous modifiez le monitor. |
service_nameNom du service | facultatif | 1 à 64 caractères parmi lettres, chiffres, ., _ et -. Requis avec service | Le nom du processus sur l’hôte, par exemple nginx. La passe cherche une entrée récente de ce nom dans le rapport de l’agent. |
breach_severityGravité | facultatif | critical (défaut) ou degraded | critical enregistre un check en échec et ouvre un incident, avec un push selon notify_push. degraded enregistre un check dégradé et ne déclenche que la notification dans l’app. |
notify_pushNotification push | facultatif | true (défaut) ou false | Envoie une notification push sur un dépassement critique. Le champ est sans effet en degraded. |
Déroulement d’un check
- L’agent sur l’hôte rapporte au plan de contrôle. Toutes les 30 s environ, le serveur charge le dernier rapport de l’agent pour ce monitor. Aucune région de sonde n’intervient, et le check ne touche jamais l’hôte par le réseau.
availability: le serveur compare l’âge du dernier rapport àgrace_seconds. Un rapport plus vieux que la période de grâce est un dépassement.cpu,mem,disk: jugés seulement tant que le dernier rapport a 180 s au plus, et une valeur au-dessus dethresholdest un dépassement. Sans valeur récente, la passe n’enregistre aucun résultat plutôt qu’une fausse alerte. L’hôte muet relève de la métriqueavailability.service: jugé seulement avec un rapport récent et une entrée récente pour le processus nommé. Un processus arrêté depuis plus degrace_secondsest un dépassement.- Un dépassement donne un échec de gravité critique ou un état dégradé, selon
breach_severity. Un échec critique ouvre un incident avec un push selonnotify_push, un état dégradé ne déclenche qu’une notification dans l’app. Alarme et rétablissement sont fixés à 1 évaluation chacun, la passe suivante décide donc.
Ce que contient un résultat
- État et gravité
- réussi, dégradé ou en échec, avec la gravité ok, dégradé ou critique. La région est
agent, le marqueur d’un check côté serveur. - Ligne de détail
- Une ligne avec le fait jugé. Elle montre l’âge du dernier rapport face à la grâce, la valeur face au seuil (
CPU 95% > 90%), ou le processus avec son nombre de processus et sa part de CPU. - Latence et code de réponse
- Rien n’est mesuré par le réseau, un résultat ne porte donc ni temps de réponse ni code de statut.
États et gravité
- okLe dernier rapport est dans la grâce, la valeur est au seuil ou en dessous, ou le processus tourne.
- dégradéUn dépassement avec
breach_severityréglé surdegraded. Il est enregistré et affiché comme notification dans l’app, sans incident ni push. - en panneUn dépassement avec
breach_severityréglé surcritical, la valeur par défaut. L’agent est resté muet au-delà de la grâce, une valeur a dépassé le seuil, ou le processus est resté arrêté plus longtemps que la grâce. L’état ouvre un incident, avec un push selonnotify_push. - erreurN’apparaît que dans une exécution de test. Quand la métrique ne peut pas être jugée, par exemple sans rapport récent, l’exécution répond erreur avec un diagnostic. Rien n’est enregistré et aucun incident ne s’ouvre.
- en attentePas encore de résultat, juste après la création ou tant que l’agent n’a envoyé aucune valeur récente pour la métrique. La passe n’enregistre rien plutôt qu’une fausse alerte.
Le signal vient de votre hôte ou de votre job, sans régions ni quorum : un seul rapport manqué compte donc. Alarme et rétablissement sont fixés à 1 évaluation chacun. La passe qui voit le dépassement ouvre l’incident, et une évaluation réussie compte comme rétablissement.
Offres et limites
- Agents hôtes
- 2 en Free, 10 en Pulse, 50 en Sentinel et 200 en Command. Les quotas Enterprise sont sur mesure. Un pack supplémentaire ajoute 10 agents pour 19 €.
- Monitors par agent
- 25 en Free, Pulse, Sentinel et Command. Les quotas Enterprise sont sur mesure. Un monitor d’agent hôte compte ici, pas dans le quota des monitors de sonde.
- Intervalle et régions
- Sans objet. Le serveur évalue toutes les 30 s environ, et les intervalles minimaux et les nombres de régions des offres ne s’appliquent pas à ce type.
Depuis le pipeline ou un agent
La même config fonctionne dans l’étape de déploiement, dans un client MCP comme Claude Code et dans le formulaire ci-dessus. create_monitor exige une clé API valable pour toute l’organisation. Si vous omettez regions, l’offre applique sa valeur par défaut.
{
  "name": "web-01 CPU",
  "type": "agent",
  "config": {
    "agent_id": "agt_...",
    "metric": "cpu",
    "threshold": 90,
    "breach_severity": "degraded",
    "notify_push": true
  }
}
Chaque interface, avec sa limite
Limites
- L’agent rapporte quatre métriques (disponibilité, CPU, mémoire et disque) et l’état d’un processus nommé. Il n’existe ni autres métriques ni valeurs personnalisées.
- CPU, mémoire et disque ne sont pas jugés tant que l’agent est muet. Associez un monitor à seuil à un monitor
availabilitysur le même agent pour détecter l’hôte muet. grace_secondsse règle par l’API ou MCP. Le formulaire garde la valeur enregistrée quand vous modifiez le monitor.- Le type n’a ni intervalle, ni régions, ni politique d’alerte propres, et le formulaire masque les trois. Le serveur évalue tous les monitors d’agent en une passe toutes les 30 s environ et ignore
regionsdans une requête.interval_secondsest enregistré à la modification et affiché dans le monitor, mais l’évaluation ne lit ni cette valeur ni les 60 s fixées à la création. agent_iddoit désigner un agent déjà enregistré dans votre organisation. L’identifiant vient de l’enregistrement de l’agent, et le monitor ne le crée pas.