Sur cette page
Ce qu’il vérifie
Un monitor d’hygiène DNS lit 3 enregistrements d’un domaine depuis chacune de ses régions, à chaque intervalle. SPF et DMARC décident si le mail du domaine est délivré, et CAA décide qui peut émettre des certificats pour lui. SPF présent, DMARC avec p=quarantine ou p=reject et un enregistrement CAA donnent ok, et tout ce qui est en deçà donne dégradé. La note ne descend jamais sous dégradé : une posture mail ou certificat affaiblie arrive au tableau de bord sans réveiller personne.
À utiliser quand
- Un domaine envoie du mail, comme des factures, des réinitialisations de mot de passe ou des notifications, et ses enregistrements SPF et DMARC doivent survivre à chaque changement DNS.
- Une politique DMARC à
noneou un enregistrement CAA absent doit apparaître comme un constat horodaté, sans ouvrir d’incident. - Le domaine n’a pas d’endpoint HTTP à vous où un monitor HTTP(S) pourrait porter le sous-check d’hygiène DNS.
Il ne juge pas si le domaine se résout ni si le serveur mail accepte les connexions. Un enregistrement qui doit porter une valeur précise demande le check d’enregistrement DNS, et le chemin du mail demande les checks SMTP et IMAP. NS, SOA, DNSSEC et l’expiration du domaine relèvent du check de domaine.
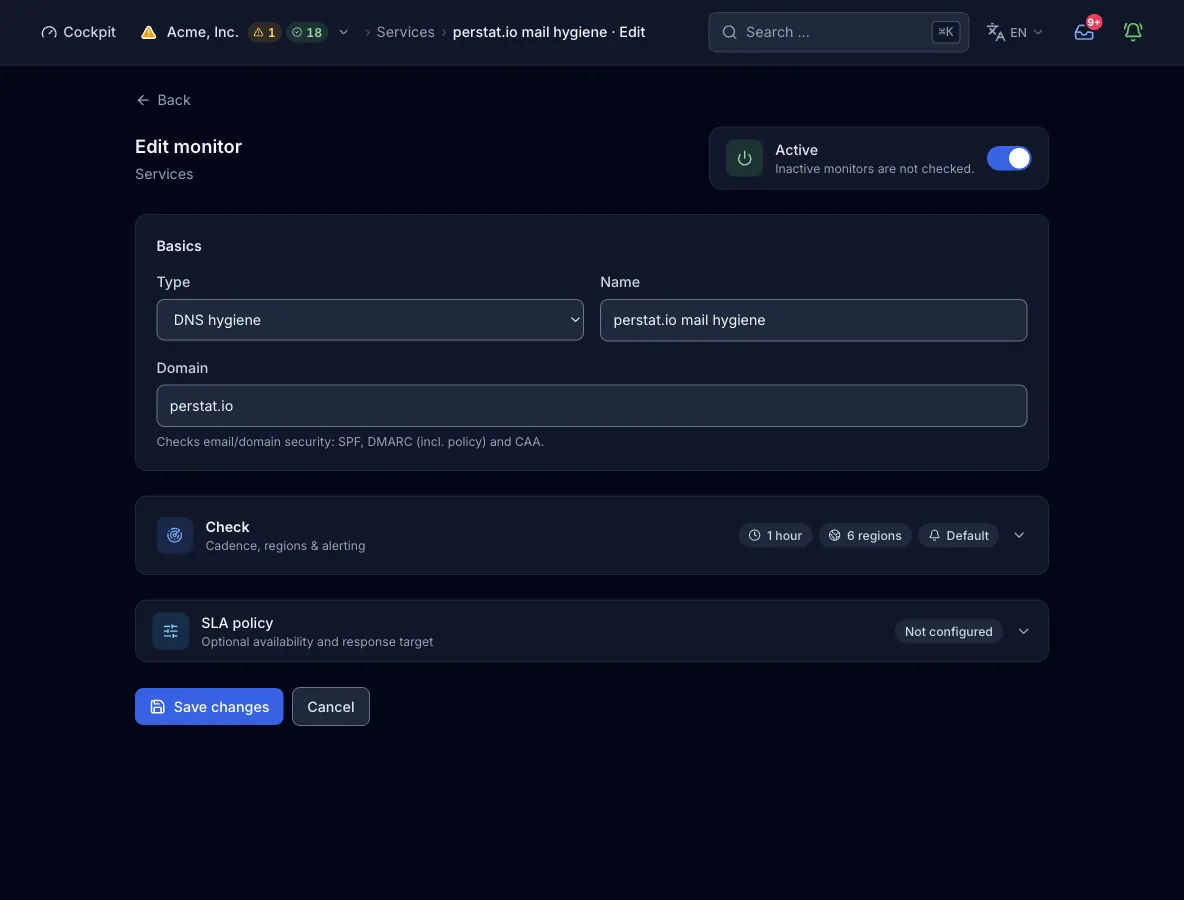
Configuration
Domaine. Le domaine dont les enregistrements sont lus, par exemple example.com. Un point final est retiré. Les 3 requêtes vont à l’apex et à _dmarc. en dessous, par le résolveur du nœud, depuis chaque région choisie.
| Champ | Requis | Valeurs et défaut | Signification |
|---|---|---|---|
domainDomaine | oui | Nom de domaine, par exemple example.com | Le domaine dont les enregistrements SPF, DMARC et CAA sont lus. |
interval_secondsIntervalle de check | facultatif | Défaut 300 s. Plage : minimum de l’offre à 24 h | La fréquence à laquelle chaque région exécute le check. Une valeur hors de la plage est relevée au minimum de l’offre ou plafonnée à 24 h, et non rejetée. |
regionsRégions | facultatif | Sous-ensemble de na, eu, as, sa, af, oce. Défaut : les régions de l’offre | Les continents qui exécutent le check. Si vous l’omettez, l’offre applique son jeu par défaut. |
Déroulement d’un check
- Chaque région dont l’intervalle est échu demande au résolveur du nœud les enregistrements TXT à l’apex du domaine et en cherche un qui contient
v=spf1. - Elle lit les enregistrements TXT sous
_dmarc.<domain>, en cherche un qui contientv=dmarc1et en extrait la politiquep=. - Elle demande les enregistrements CAA à l’apex. Seule leur présence compte, pas leur contenu.
- Un enregistrement SPF ou DMARC absent donne dégradé, et le détail nomme ce qui manque. Sinon, une politique DMARC autre que
quarantineoureject, ou l’absence d’enregistrement CAA, donne dégradé, et le détail nomme ce qui est faible. Si tout est en place, le résultat est ok. - Le résultat de la région part au plan de contrôle. Un résultat dégradé reste hors de l’évaluation des incidents. Seule une erreur y compte comme une panne, une fois le quorum atteint.
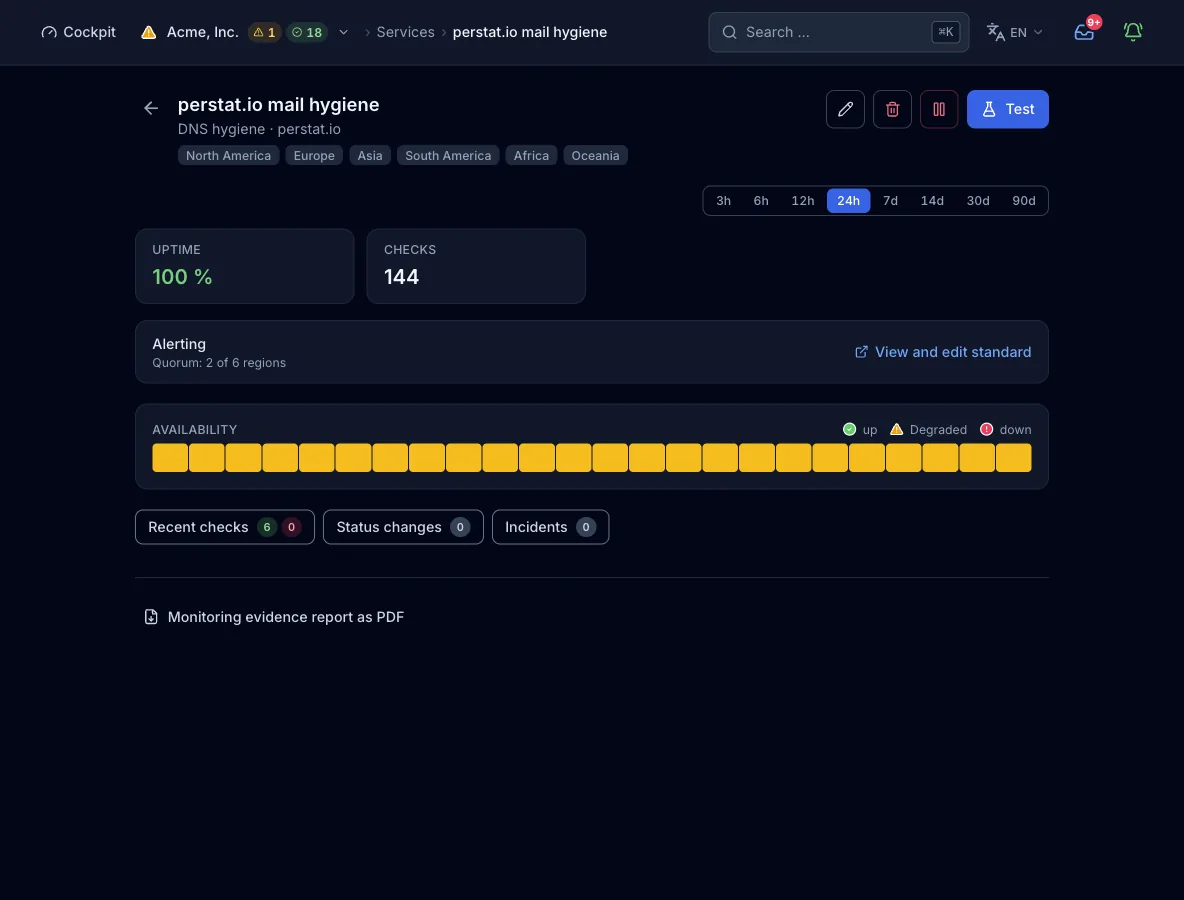
Ce que contient un résultat
- Ligne de détail
- Une ligne nomme les enregistrements absents (SPF, DMARC) ou les faibles, comme
DMARC p=noneou pas de CAA. Quand tout est en place, elle afficheSPF · DMARC p=reject · CAA, avec la politique que porte l’enregistrement. - Temps de réponse
- Le temps des 3 requêtes réunies, par région. Ce type ne signale ni code de réponse ni couche de cause.
- Région
- Chaque résultat porte la région qui l’a mesuré. Il n’y a pas de sous-résultat par famille ni par adresse.
États et gravité
- okSPF est présent, DMARC porte
p=quarantineoup=reject, et un enregistrement CAA existe. - dégradéSPF ou DMARC est absent, DMARC porte une politique autre que
quarantineoureject, ou aucun enregistrement CAA n’existe. Une requête qui échoue ou ne renvoie rien compte comme une absence, pas comme une erreur. - erreurLe check ne peut pas s’exécuter : la configuration est illisible, le domaine est vide, ou le résolveur du nœud ne s’initialise pas. Cet état compte comme une panne de gravité critique.
Confirmé par quorum : par défaut, 2 régions doivent signaler l’échec avant l’ouverture d’un incident. La note de posture est ok ou dégradé, jamais en panne. Seule une erreur, quand le check ne peut pas s’exécuter, compte comme une panne. La règle par défaut de l’organisation exige 2 régions et 2 checks consécutifs, et un monitor peut porter sa propre règle (nombre ou pourcentage, checks consécutifs et durée minimale).
Offres et limites
- Intervalle minimal
- Free permet 300 s, Pulse 60 s et Sentinel 30 s. Command permet 15 s et Enterprise 10 s, les deux uniquement par MCP. Le formulaire web propose 30 s, 1 min, 5 min, 15 min et 1 h.
- Régions
- Free utilise 2 régions sur 6 et Pulse 3 sur 6. Les 6 sont disponibles à partir de Sentinel.
- Monitors
- Free inclut 10 monitors de sonde, Pulse 50, Sentinel 150 et Command 500. Les quotas Enterprise sont sur mesure. Le décompte couvre les 11 types de checks de sonde, et les agents hôtes et les heartbeats ont leurs propres quotas.
Depuis le pipeline ou un agent
La même config fonctionne dans l’étape de déploiement, dans un client MCP comme Claude Code et dans le formulaire ci-dessus. create_monitor exige une clé API valable pour toute l’organisation. Si vous omettez regions, l’offre applique sa valeur par défaut.
{
  "name": "example.com mail hygiene",
  "type": "dns_hygiene",
  "interval_seconds": 3600,
  "config": {
    "domain": "example.com"
  }
}
Chaque interface, avec sa limite
Limites
- Aucun contrôle de syntaxe SPF. Un enregistrement TXT à l’apex n’a qu’à contenir
v=spf1. - Aucun contrôle DKIM ni MX, et le contenu d’un enregistrement CAA n’est pas lu.
- Une requête qui échoue compte comme un enregistrement absent, pas comme une erreur de mesure.
- Aucune famille IP ni sous-résultat par adresse. Les requêtes passent par le résolveur du nœud, et le nœud arrête une exécution après 120 s.
- Un enregistrement absent ou faible ne descend jamais sous dégradé. Un enregistrement qui doit porter une valeur précise demande le check d’enregistrement DNS.
- À partir du build du 13 septembre 2026, le validateur lit
domainquand un monitor est créé ou mis à jour par l’API. Entre le 11 août 2026 et ce build, il lisaitnameet rejetait une requête sans ce champ (name must not be empty). Le moteur lisait pourtant toujoursdomain, et les monitors existants continuaient de tourner. Tant que ce build n’est pas déployé, envoyeznameavec la même valeur à côté dedomain.