Sur cette page
Ce qu’il vérifie
Un monitor heartbeat vérifie qu’un job a tourné quand il le devait. La création du monitor génère une URL secrète, et le job l’appelle à la fin de chaque exécution. Toutes les 30 s environ, le plan de contrôle compare l’âge du dernier ping à la période attendue plus la grâce. Un ping plus ancien, ou un dernier ping arrivé sur l’URL d’échec, est un dépassement. Jusqu’au premier ping, le monitor est en attente, pas en panne.
À utiliser quand
- Un job planifié n’a pas d’adresse à sonder : une exécution cron, une sauvegarde nocturne, un import ou un worker qui doit finir à l’heure.
- L’échec que vous devez voir, c’est que quelque chose n’a pas eu lieu. Un job qui n’a jamais démarré ne laisse rien de cassé qu’une sonde pourrait atteindre.
- Le job peut juger sa propre exécution. Il appelle l’URL de ping après un succès et l’URL d’échec quand ses propres contrôles échouent. Le monitor passe alors en panne à l’évaluation suivante, sans attendre l’échéance du planning.
Le check n’enregistre que le moment où l’appel arrive. Un service qui écoute sur un port demande le check HTTP(S) ou TCP. CPU, mémoire, disque et processus de l’hôte lui-même demandent le check d’agent hôte.
Configuration
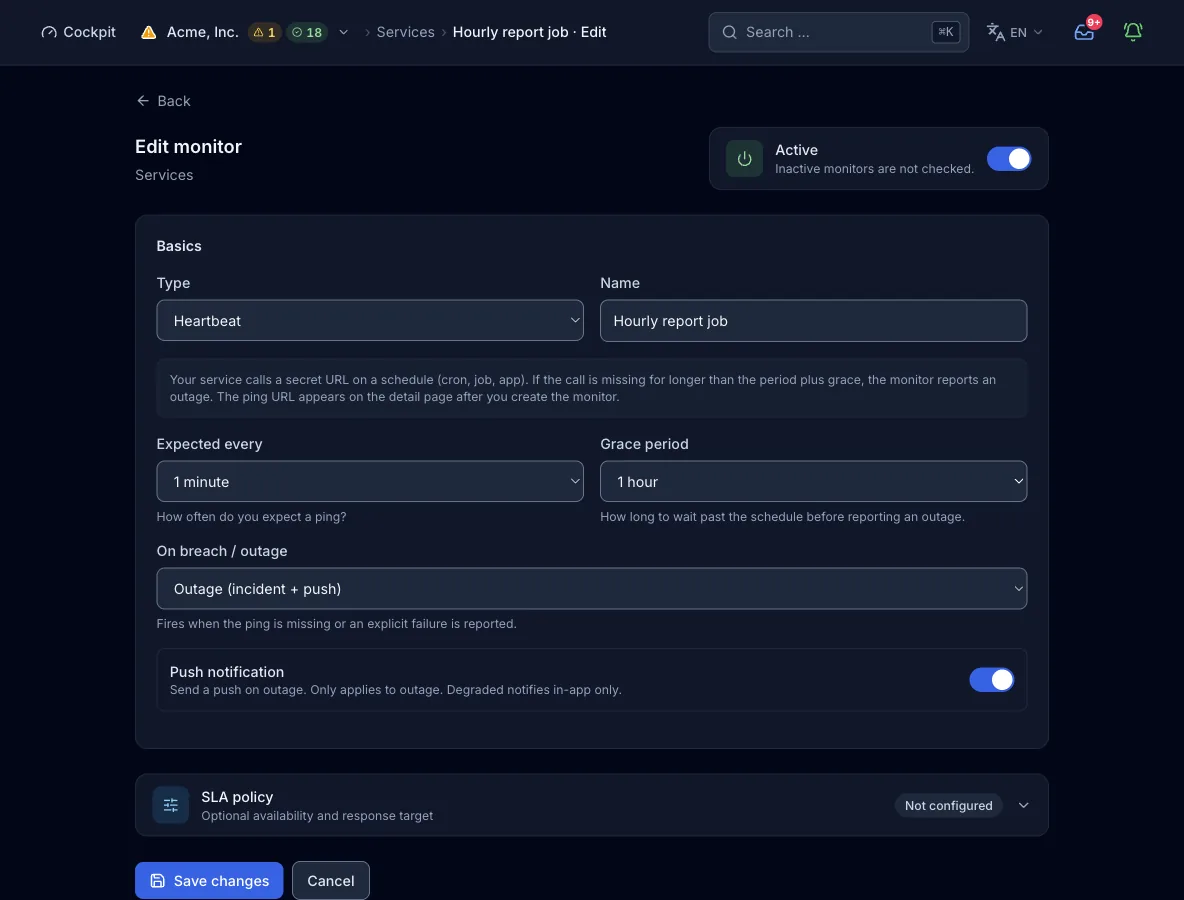
Cible. Aucune. Un heartbeat n’a ni cible, ni régions de sondes, ni familles IP, ni intervalle de check propre. Le formulaire masque ces champs, et le plan de contrôle évalue le monitor toutes les 30 s environ sous la pseudo-région heartbeat. La création du monitor génère l’URL secrète https://api.perstat.io/ping/{token}. La vue du monitor l’affiche avec l’URL d’échec (/fail en suffixe).
| Champ | Requis | Valeurs et défaut | Signification |
|---|---|---|---|
period_secondsAttendu toutes les | facultatif | Secondes, 30 à 2 592 000 (30 jours), défaut 3600 | La fréquence à laquelle le job est censé pinguer. Le formulaire propose des valeurs prédéfinies, et l’API ramène n’importe quel nombre de secondes dans la plage. |
grace_secondsPériode de grâce | facultatif | Secondes, 0 à 86 400 (24 h). Défaut : un cinquième de la période, maintenu entre 60 et 3600 | Combien de temps un ping peut encore arriver après la période avant que le monitor compte un dépassement. La valeur 0 fixe une échéance stricte. Réglez la grâce sur une vraie fraction de la période, car une sauvegarde nocturne avec 60 s de grâce alerte à chaque nuit un peu lente. |
breach_severityEn cas de dépassement / panne | facultatif | critical (défaut) ou degraded | critical met le monitor en panne et ouvre un incident, avec un push selon notify_push. degraded le met en dégradé avec une notification dans l’app seulement, et toute autre valeur est enregistrée comme critical. |
notify_pushNotification push | facultatif | true (défaut) ou false | Envoie une notification push sur une panne en critical. Un dépassement dégradé notifie dans l’app quoi qu’il arrive. |
Déroulement d’un check
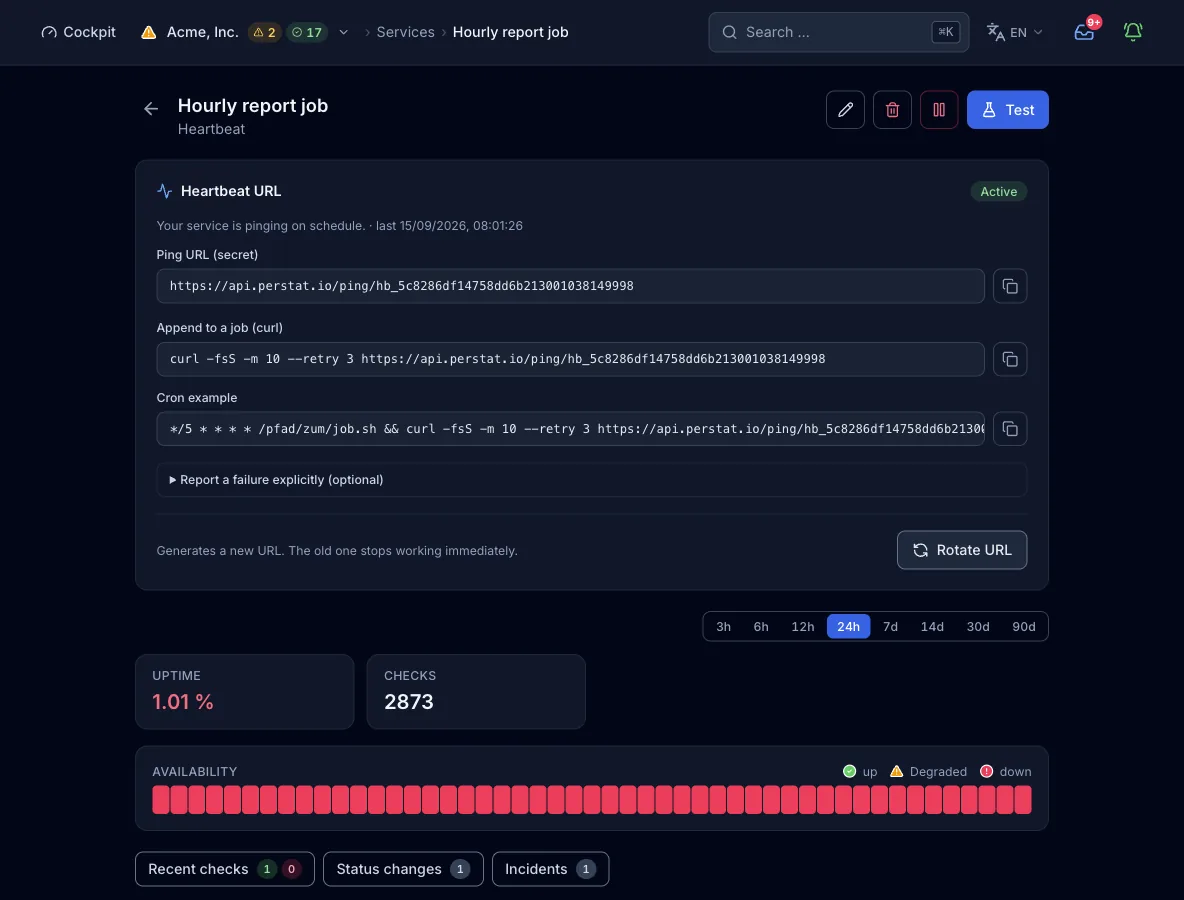
- La création du monitor génère le token, et la vue du monitor affiche l’URL de ping et l’URL d’échec. Branchez l’URL de ping dans le job, par exemple en dernière commande de la ligne cron.
- Le job appelle l’URL de ping en GET ou POST quand une exécution se termine. Quand l’exécution décide qu’elle a échoué, le job appelle l’URL d’échec à la place.
- Toutes les 30 s environ, le plan de contrôle évalue le monitor. Jusqu’au premier ping, il reste en attente et aucun résultat n’est écrit.
- Un dernier ping arrivé sur l’URL d’échec est un dépassement. Un dernier ping plus ancien que la période plus la grâce l’est aussi.
- Un dépassement prend la gravité configurée.
criticalmet le monitor en panne et ouvre un incident, avec un push si activé, etdegradedle met en dégradé avec une notification dans l’app seulement. Alarme et rétablissement sont fixés à 1 check chacun, le prochain ping sain résout donc l’incident à l’évaluation suivante. - Le bouton Test lance la même évaluation à la demande et ne montre le résultat qu’à vous. Rien n’est enregistré et aucun incident ne s’ouvre.
Ce que contient un résultat
- État et gravité
- réussi, en échec ou dégradé, avec la gravité ok, dégradé ou critique. Un heartbeat qui n’a jamais pingué affiche en attente.
- Ligne de détail
- Une ligne qui dit ce qui s’est passé. Elle signale un heartbeat à jour avec l’âge du dernier ping, aucun heartbeat depuis N secondes face à la période et à la grâce attendues, ou un échec signalé par le job.
- Dernier ping
- Le panneau heartbeat de la vue du monitor affiche l’heure du dernier ping. Elle figure sur la ligne d’état au-dessus de l’URL de ping, à côté du badge Active ou Waiting. C’est la ligne de détail de l’évaluation suivante, pas le panneau, qui indique si ce ping était sain ou un échec.
- Région
- Chaque résultat porte la pseudo-région
heartbeat. Il n’y a ni latence, ni code de réponse, ni sous-résultat.
États et gravité
- okLe dernier ping est arrivé dans la période plus la grâce et c’était un ping sain.
- dégradéUn dépassement avec
breach_severityréglé surdegraded. Il déclenche une notification dans l’app, sans incident ni push. - en panneUn dépassement à la gravité par défaut
critical: le dernier ping est plus ancien que la période plus la grâce, ou le job a appelé l’URL d’échec. L’état ouvre un incident, avec un push selonnotify_push. - en attenteAucun ping n’est encore arrivé. Le monitor affiche en attente jusqu’à ce que le job appelle l’URL pour la première fois.
Le signal vient de votre hôte ou de votre job, sans régions ni quorum : un seul rapport manqué compte donc. Le plan de contrôle évalue toutes les 30 s environ, avec alarme et rétablissement fixés à 1 check chacun. Un dépassement devient un incident à la première évaluation qui suit la fin de la période plus la grâce.
Offres et limites
- Intervalle d’évaluation
- Environ 30 s dans chaque offre, fixé par le serveur. L’intervalle minimal de l’offre ne s’applique qu’aux types de sonde.
- Régions
- Aucune. Le job se signale et rien n’est sondé, le nombre de régions de l’offre ne s’applique donc pas.
- Heartbeats
- 2 en Free, 10 en Pulse, 50 en Sentinel et 200 en Command. Les quotas Enterprise sont sur mesure. Les heartbeats ont leur propre quota et n’occupent aucune place de monitor de sonde. Un pack de 25 supplémentaires coûte 9 €.
Depuis le pipeline ou un agent
La même config fonctionne dans l’étape de déploiement, dans un client MCP comme Claude Code et dans le formulaire ci-dessus. create_monitor exige une clé API valable pour toute l’organisation. Si vous omettez regions, l’offre applique sa valeur par défaut.
{
  "name": "Nightly backup",
  "type": "heartbeat",
  "config": {
    "period_seconds": 86400,
    "grace_seconds": 1800,
    "breach_severity": "critical",
    "notify_push": true
  }
}
Chaque interface, avec sa limite
Limites
- Rien n’est mesuré d’autre que le moment de l’appel, sans durée d’exécution, sans code de sortie et sans charge utile.
- Jusqu’au premier ping, le monitor est en attente. Un heartbeat qu’aucun job n’appelle ressemble à une couverture et n’en est pas une.
- L’URL de ping n’est pas authentifiée, quiconque détient le token peut donc pinguer. Traitez-la comme un identifiant. Si elle fuit, renouvelez-la dans la vue du monitor, et l’ancienne URL cesse aussitôt de fonctionner.
- L’endpoint de ping accepte 240 requêtes par 60 s et par IP source. Un token inconnu reçoit 404.
- Une requête de création par l’API ou MCP ne renvoie pas l’URL de ping. Lisez-la dans la vue du monitor et branchez-la dans le job.
- L’évaluation tourne toutes les 30 s environ, un dépassement est donc remarqué jusqu’à 30 s environ après la fin de la période plus la grâce.