Sur cette page
Ce qu’il vérifie
À chaque intervalle, chaque région d’un monitor ping envoie des requêtes echo ICMP à chaque adresse résolue de l’hôte. Par défaut, ce sont 3 paquets de 32 octets, l’un après l’autre, chacun attendant sa réponse jusqu’à 10 s. Le monitor enregistre combien de réponses sont revenues, les pertes en pourcentage et l’aller-retour moyen. Chaque réponse reçue donne un succès, une perte partielle un état dégradé et le silence une panne. Un hôte disparu se lit donc autrement qu’un lien qui perd des paquets.
À utiliser quand
- Un hôte n’a aucun service à sonder mais doit rester joignable : une passerelle, un routeur, un endpoint VPN ou un serveur nu.
- Les pertes sur le chemin vers un hôte doivent apparaître comme un signal à part, pas se fondre dans un délai dépassé applicatif.
- La joignabilité doit être mesurée depuis plusieurs régions, pour qu’un problème de routage dans une région ressorte face aux régions qui reçoivent encore des réponses.
Un résultat de ping ne dit rien des services de l’hôte. Un hôte qui répond au ping peut héberger une application plantée, et un hôte qui filtre ICMP échoue à ce check tout en servant normalement. Utilisez le check TCP pour un port, le check HTTP(S) pour une application, le check traceroute pour le chemin intermédiaire et l’agent hôte pour un hôte qui vous appartient.
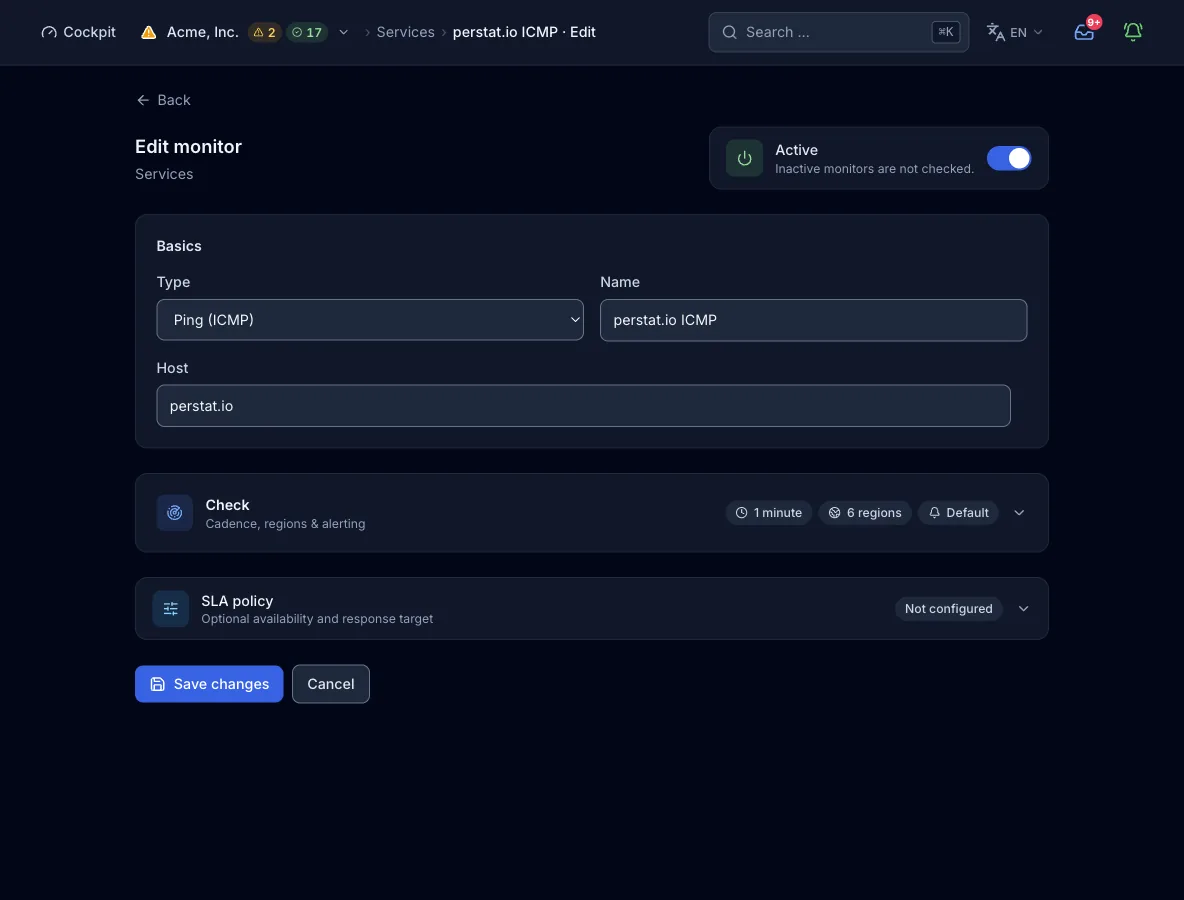
Configuration
Cible. Un nom d’hôte ou une adresse IP, sans schéma, chemin ni port. Les étiquettes comptent 63 caractères au plus, le nom entier 253. La sonde résout le nom par son propre résolveur et bloque les adresses de boucle locale, privées et link-local. Les adresses de métadonnées cloud, de NAT opérateur, multicast et broadcast sont bloquées aussi, le monitor ne peut donc pas être pointé vers un réseau interne.
| Champ | Requis | Valeurs et défaut | Signification |
|---|---|---|---|
hostHôte | oui | Nom d’hôte ou adresse IP | L’hôte qui reçoit les requêtes echo. Chaque adresse vers laquelle il se résout dans la famille IP choisie est pinguée séparément. |
count | facultatif | 1-255, défaut 3. La valeur 0 compte comme 1, et au-delà de 255 le check se termine en erreur | Paquets echo par adresse et par check, envoyés l’un après l’autre. Ce champ se règle par l’API ou MCP, et un monitor créé dans le formulaire utilise 3. |
interval_secondsIntervalle de check | facultatif | Défaut 300. Relevé au minimum de l’offre, plafonné à 24 h | La fréquence à laquelle chaque région exécute le check. Le formulaire propose des préréglages de 30 s à 1 h, et les intervalles de 15 s ou 10 s passent par MCP. |
regionsRégions | facultatif | Sous-ensemble de na, eu, as, sa, af, oce. Défaut : les régions de l’offre | Les continents qui exécutent le check. Une liste qui dépasse la limite de l’offre est rejetée, pas tronquée. |
Familles IP
Avec les deux familles, chaque adresse résolue de chaque famille est pinguée séparément. Le résultat garde un sous-résultat par famille et par adresse, un échec limité à IPv6 reste donc visible comme tel. Le formulaire ne propose IPv6 que si l’hôte a un enregistrement AAAA ou est un littéral IPv6, et seules les régions qui sondent IPv6 restent alors sélectionnables.
| Champ | Requis | Valeurs et défaut | Signification |
|---|---|---|---|
address_familiesFamilles IP | facultatif | Liste de ipv4, ipv6 ou des deux. Absent ou vide vaut ["ipv4"] | Les familles IP que couvre le check. |
family_fail_severity | facultatif | degraded (défaut) ou failed | Ce que signifie l’échec d’une famille pendant que l’autre répond. Au sein d’une famille, une adresse muette parmi plusieurs donne toujours un état dégradé. |
Déroulement d’un check
- Chaque région dont l’intervalle est échu résout l’hôte par le résolveur du nœud. Un nom qui se résout dans une plage bloquée termine le check en panne.
- Chaque adresse résolue de la famille choisie reçoit
countrequêtes echo de 32 octets, l’une après l’autre. Chaque requête attend sa réponse jusqu’à 10 s, et une réponse manquante compte comme perdue. - Par adresse, la sonde calcule les pertes en pourcentage et l’aller-retour moyen des réponses. Si toutes les réponses arrivent, l’adresse réussit. Si certaines se perdent, elle est dégradée, et sans aucune réponse, elle échoue.
- Plusieurs adresses d’une même famille se fondent en un verdict : en panne si toutes sont muettes, dégradé si certaines le sont, sinon le pire résultat d’adresse. Entre les familles,
family_fail_severitydécide de ce que signifie l’échec d’une seule famille. - Le résultat de la région part au plan de contrôle. Un incident s’ouvre dès que le quorum de la politique d’alerte est atteint, par défaut 2 régions et 2 checks consécutifs.
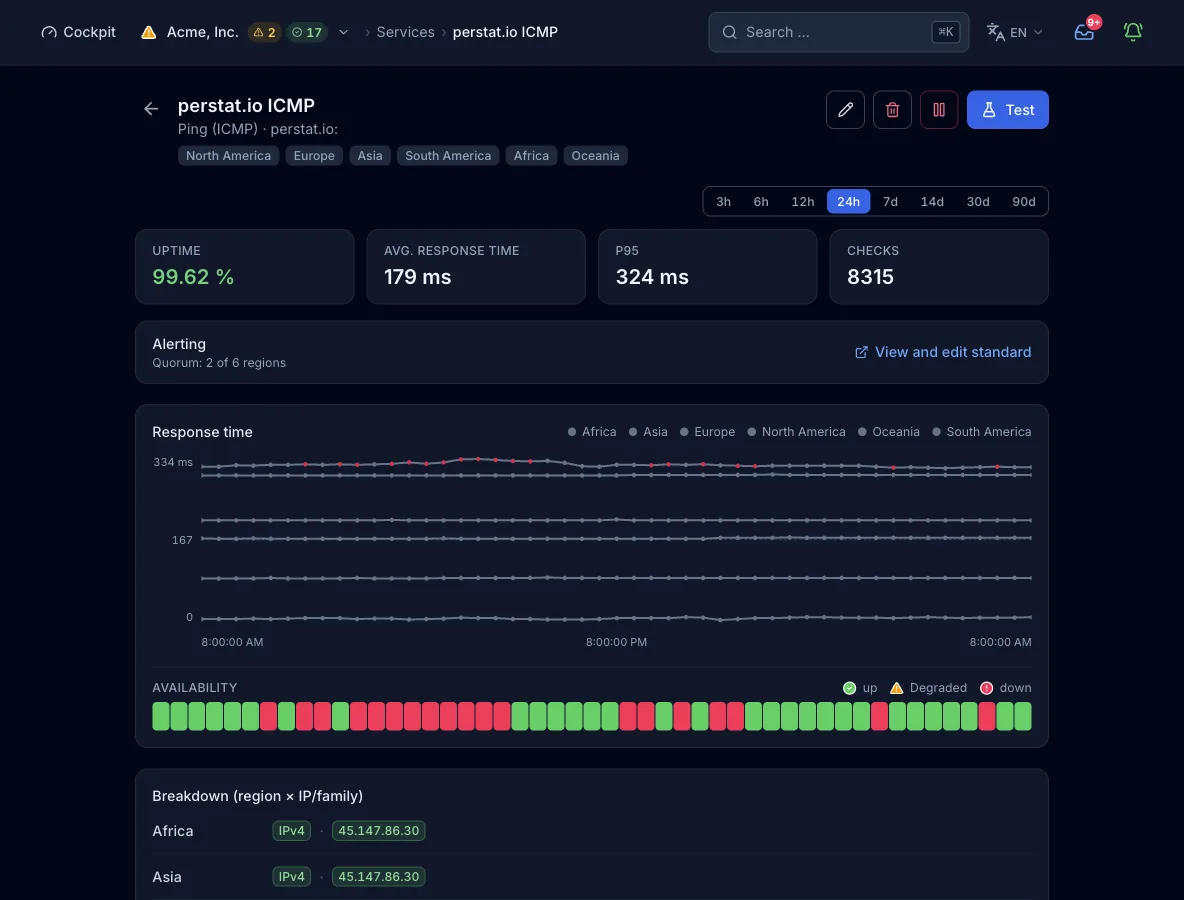
Ce que contient un résultat
- Réponses et pertes
- Une ligne par adresse avec les réponses reçues sur les paquets envoyés, les pertes en pourcentage et l’aller-retour moyen. Par exemple : 3 réponses sur 3 envoyés, aucune perte, 12 ms en moyenne.
- Temps de réponse
- L’aller-retour moyen des réponses par adresse. Sur plusieurs adresses, le minimum devient le temps de réponse du check.
- Couche de cause
- Un nom qui n’existe pas (NXDOMAIN ou NODATA) est attribué au DNS de la cible. Les autres échecs de résolution restent sans attribution. Une fois la résolution réussie, les réponses perdues sont attribuées à la cible.
- Région, famille, adresse
- Chaque résultat porte la région qui l’a mesuré. Il contient un sous-résultat par famille IP et par adresse, chacun avec son propre état, son aller-retour et sa ligne de détail.
États et gravité
- okChaque paquet vers chaque adresse a reçu une réponse.
- dégradéCertains paquets ont été perdus, ou l’une de plusieurs adresses est restée muette. À la gravité par défaut, une famille IP qui échoue pendant que l’autre répond donne aussi un état dégradé.
- en panneAucune adresse n’a répondu, que l’hôte soit éteint, injoignable ou qu’il filtre ICMP. Le check est aussi en panne quand le nom ne se résout pas, quand la cible se trouve dans une plage bloquée, ou quand une famille échoue avec
family_fail_severityréglé surfailed. - erreurLe nœud ne peut pas envoyer d’ICMP, par exemple parce que le socket brut est refusé. L’état compte comme une panne de gravité critique.
Confirmé par quorum : par défaut, 2 régions doivent signaler l’échec avant l’ouverture d’un incident. Par défaut, l’organisation exige 2 régions et 2 checks consécutifs. Un monitor peut porter sa propre règle (nombre ou pourcentage, checks consécutifs, durée minimale).
Offres et limites
- Intervalle minimal
- 300 s en Free, 60 s en Pulse et 30 s en Sentinel. Command permet 15 s et Enterprise 10 s, dans les deux cas uniquement par MCP. Le formulaire propose des préréglages de 30 s à 1 h.
- Régions
- 2 sur 6 en Free, 3 sur 6 en Pulse et les 6 à partir de Sentinel.
- Monitors
- 10 en Free, 50 en Pulse, 150 en Sentinel et 500 en Command. Les quotas Enterprise sont sur mesure. Le quota se compte sur l’ensemble des onze types de sonde, et agents hôtes et heartbeats ont leurs propres quotas.
Depuis le pipeline ou un agent
La même config fonctionne dans l’étape de déploiement, dans un client MCP comme Claude Code et dans le formulaire ci-dessus. create_monitor exige une clé API valable pour toute l’organisation. Si vous omettez regions, l’offre applique sa valeur par défaut.
{
  "name": "Office gateway",
  "type": "ping",
  "interval_seconds": 60,
  "config": {
    "host": "gateway.example.com",
    "count": 5
  }
}
Chaque interface, avec sa limite
Limites
- Un hôte qui filtre ICMP échoue au check même quand ses services répondent. Associez-lui un check TCP ou HTTP(S) sur le service.
- Le check n’enregistre que les pertes et l’aller-retour moyen, sans gigue, sans percentiles et sans temps par paquet.
- La taille des paquets est fixée à 32 octets, et
countse règle par l’API ou MCP, pas dans le formulaire. Face à un hôte muet, chaque paquet attend 10 s et le nœud arrête une exécution à 120 s, gardez donccountà 12 ou moins. - Les résultats sont par adresse, pas par saut. Le chemin relève du check traceroute.
- Les cibles sur des adresses privées, de boucle locale, link-local et de métadonnées cloud sont bloquées.
- Toutes les régions ne sondent pas IPv6, sélectionner
ipv6restreint donc les régions utilisables.