Sur cette page
Dernière vérification : 15 septembre 2026.
Décider selon le workflow
Perstat convient si Opsgenie alerte surtout votre équipe sur la disponibilité et que vous voulez réunir mesure, astreinte, communication de statut et registre obtenu dans un seul produit.
Une autre alternative convient si Opsgenie sert surtout de boîte de réception qui agrège les alertes de nombreux outils tiers. Perstat ne reproduit volontairement pas ce modèle de sources d’alertes, et les alertes des autres outils restent où elles sont.
Les voies de migration d’Atlassian sont Jira Service Management et Compass. Examinez-les d’abord si l’intégration à Atlassian ou l’agrégation d’alertes tierces est le critère décisif.
Ce que Perstat remplace : les plannings d’astreinte, l’escalade du push au SMS puis à l’appel téléphonique, l’acquittement, la chronologie des incidents.
Ce que vous gagnez au passage : un monitoring avec 2 régions sur Free, 3 sur Pulse et les 6 dès Sentinel. Le quorum est configurable pour 11 types de checks régionaux, hors agent et heartbeat. Vous gagnez aussi des pages de statut sur votre propre domaine dès Sentinel et un registre de disponibilité à remettre à vos clients.
Ce qu’il faut migrer, et quand : le guide de migration pas à pas est sur le blog. L’échéance vient d’Atlassian, pas de nous. L’ avis de fin de vente et de support d’Opsgenie la fixe au 5 avril 2027, date à laquelle les données clients non migrées sont supprimées.
Transposer les concepts d’Opsgenie dans Perstat
Opsgenie a mis fin aux nouvelles ventes le 4 juin 2025. Selon la page de licence, les clients existants peuvent ajouter des utilisateurs jusqu’au 5 avril 2027 et ne renouveler que si leur période d’abonnement se termine avant cette date. Après une migration, Opsgenie s’arrête 120 jours plus tard. Il n’y a donc pas de tableau de prix ici, et le comparatif porte sur les concepts.
Le tableau montre où chaque concept d’Opsgenie trouve sa place dans Perstat, y compris les deux manques.
| Concept Opsgenie | Dans Perstat |
|---|---|
| Alertes | incidents confirmés par quorum depuis le monitoring ou ouverts à la main |
| Règles d’escalade | niveaux d’escalade par planning : push, puis SMS, puis appel téléphonique |
| Plannings et rotations d’astreinte | rotations avec alerte sur les trous de couverture, dès Sentinel |
| Acquittement | l’acquittement attribue l’incident, fait taire tous les appareils, les rappels vont à la personne responsable |
| Notifications par appel et SMS | SMS personnels dès Pulse. SMS et appels d’astreinte dès Sentinel, uniquement vers des numéros vérifiés, 2 appels au maximum par incident |
| Monitoring heartbeat | votre job appelle une URL secrète. Un appel manquant au-delà de la période et du délai de grâce ouvre un incident |
| Intégrations vers les outils de monitoring | autre modèle, car Perstat est le monitoring. Les webhooks signés et Slack partent vers l’extérieur |
| Chronologie et post-mortem de l’incident | sur l’incident, avec des actions à suivre, publiables sur votre page de statut |
| Rapports | registre de disponibilité arbitré, exemple de rapport éditorial, rapport PDF par monitor sur 7, 14, 30 ou 90 jours, export manuel CSV avec manifeste sur demande |
| Agrégation d’alertes de nombreux outils | volontairement non reproduite. Perstat remplace la couche d’alerte pour la disponibilité et n’agrège pas les alertes d’outils tiers |
Dans Perstat, le planning et ses niveaux d’escalade remplacent les rotations et les règles d’escalade d’Opsgenie. Il n’existe pas d’import automatique. Recréez à la main la rotation et les niveaux d’escalade avant la période en parallèle.
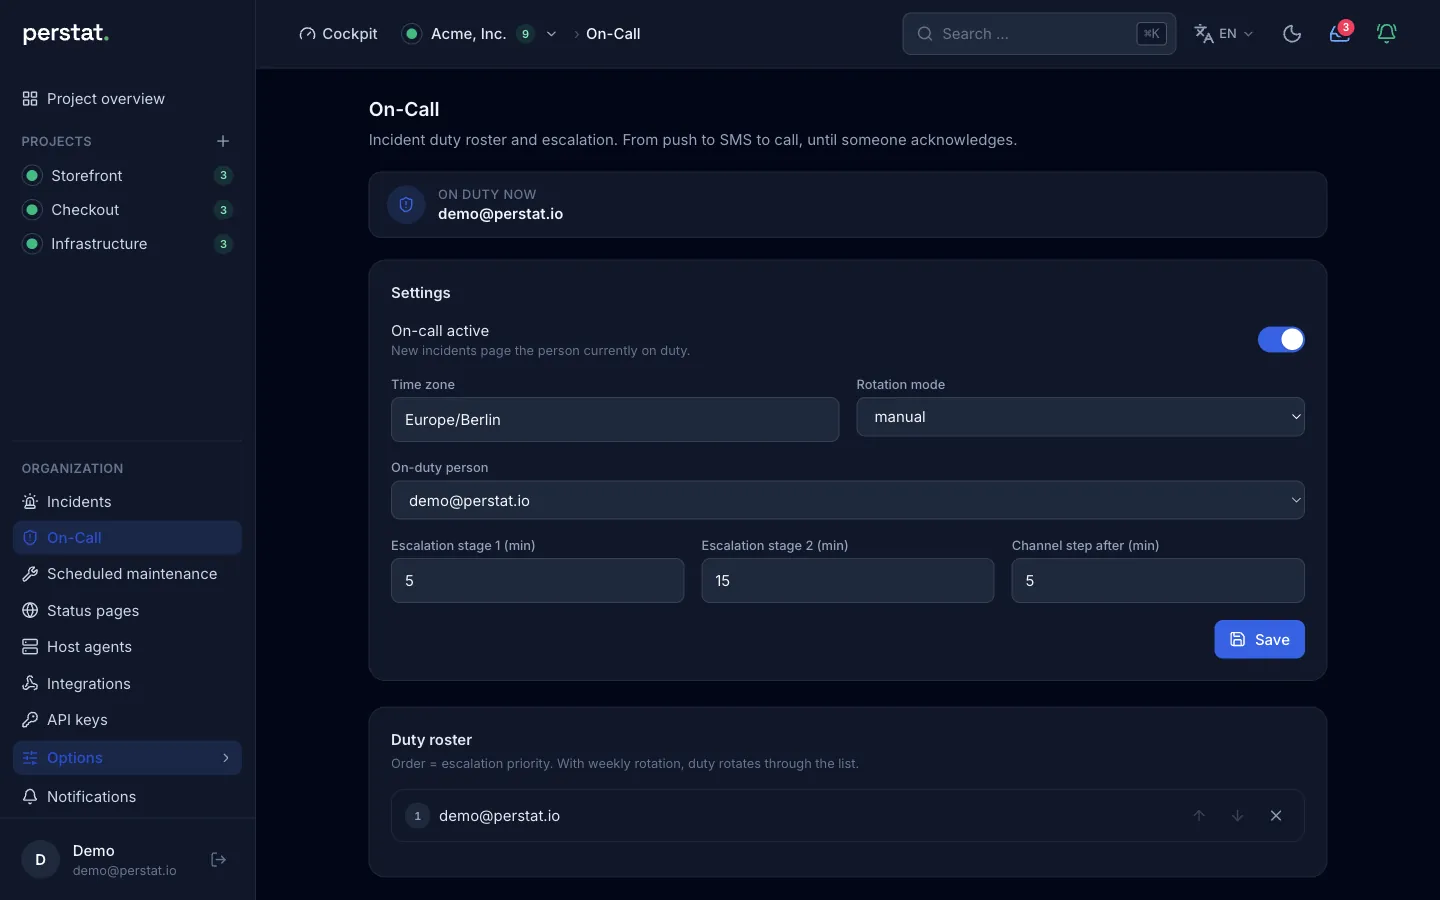
Personne dans la rotation n’a besoin d’un iPhone. Les SMS dès Pulse et les appels de l’escalade d’astreinte dès Sentinel atteignent n’importe quel téléphone.
Mener la migration en parallèle
- Inventoriez plannings, règles d’escalade, utilisateurs et sources d’alertes. Séparez l’alerte de disponibilité de l’agrégation d’alertes tierces avant de choisir une cible.
- Recréez une rotation et son escalade dans Perstat et gardez Opsgenie actif pendant une rotation complète. Déclenchez un incident contrôlé sur un endpoint de test. Vérifiez le push, le SMS et l’appel vocal, puis l’acquittement et le rétablissement.
- Ne déplacez les monitors de disponibilité et le workflow de statut qu’une fois les chemins alignés. Conservez une autre voie d’agrégation si nécessaire, et suivez les indications d’Atlassian pour préserver les données requises avant l’échéance du cycle de vie.
Commencez le monitoring gratuitement ou suivez la visite du produit. La visite ne demande aucune inscription, et le prix s’affiche sans rendez-vous commercial.