Sur cette page
Un seul parcours, des services aux jobs
Toutes les offres incluent 13 types de checks : HTTP, en-têtes HTTP, TCP, DNS, hygiène DNS, domaine, certificat TLS, SMTP, IMAP, ping, traceroute, agent et heartbeat. Ils couvrent les services joignables depuis l’extérieur, les signaux des hôtes et les jobs qui remontent leur propre résultat. Chaque résultat suit un seul parcours de monitor et d’incident, au lieu d’être réparti entre plusieurs outils.
Perstat se limite volontairement à l’uptime et au registre qui en découle. Ce n’est pas un APM, et il ne gère pas les logs.
D’un résultat à un incident confirmé
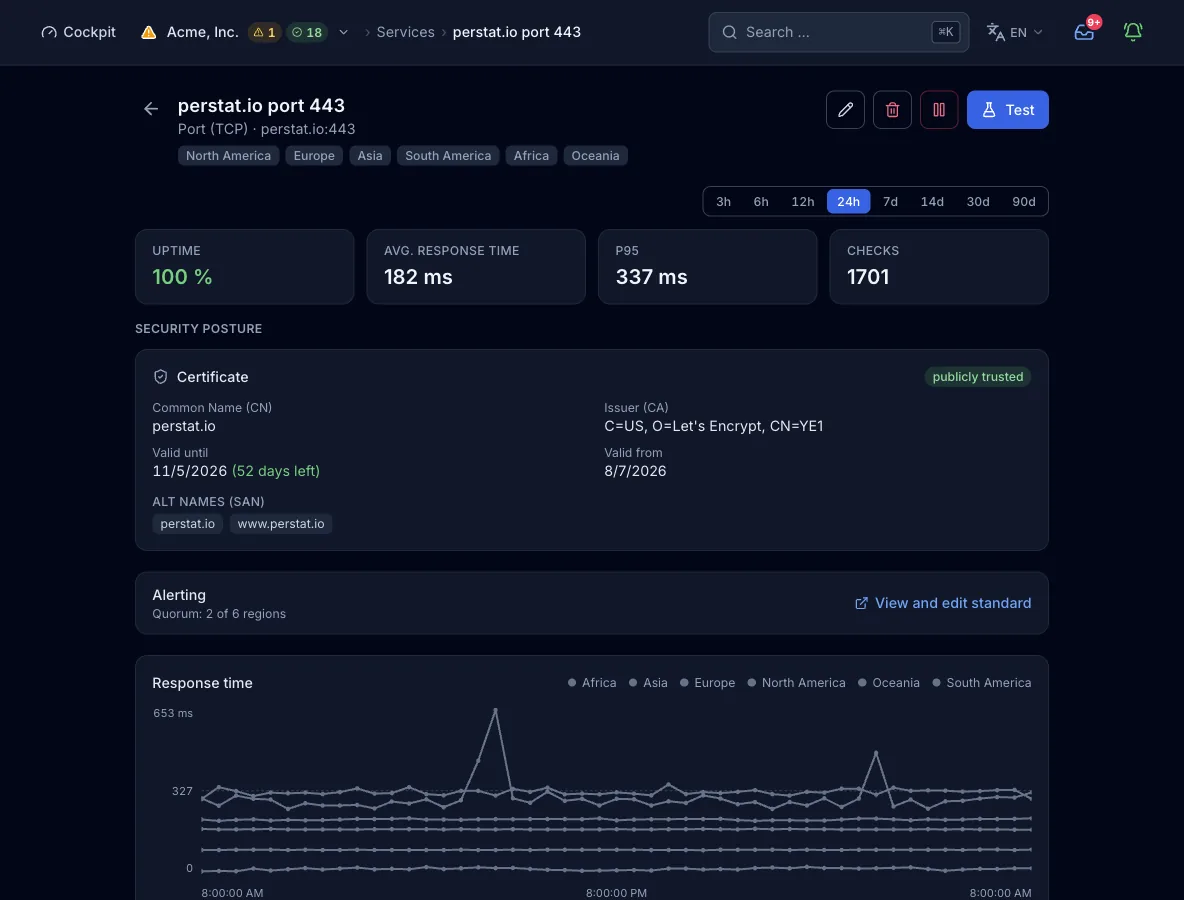
Onze types de checks passent par des sondes régionales. Avec la politique standard, une seule région n’ouvre pas d’incident. Le monitor exige un quorum de 2 régions, et cette règle est configurable.
L’agent et le heartbeat sont les deux exceptions. Ils remontent directement et n’utilisent ni régions de sondes ni quorum régional.
La documentation du quorum détaille les deux parcours. La page du réseau documente la topologie actuelle et l’agrégation régionale.
Voir le signal avant l’alerte
Perstat affiche un état en formation avant que la politique configurée ne confirme une panne régionale. La liste de veille conserve les divergences par région, par famille IP, par adresse IP et par nœud. L’opérateur obtient ainsi un signal précoce sans traiter le premier écart comme un incident.
Les résultats confirmés conservent aussi leur contexte de diagnostic. Lorsque c’est pertinent, Perstat isole le temps DNS et attribue l’échec à l’une de ces couches :
- application cible
- DNS cible
- réseau
- résolveur Perstat
- nœud de sonde
HTTP, réseau et DNS restent consultables
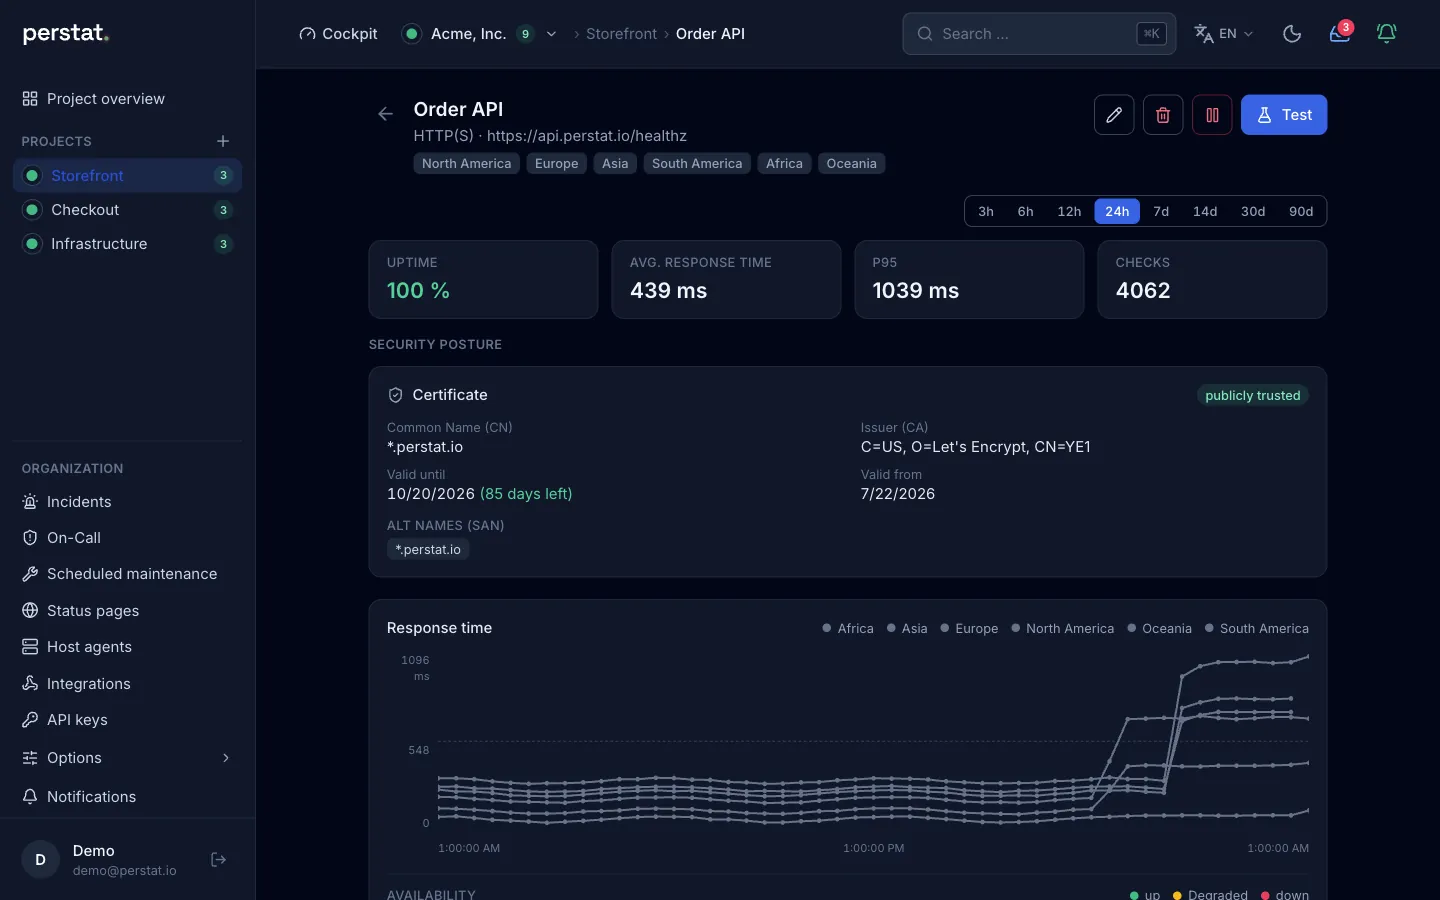
Un monitor HTTP peut vérifier un statut attendu, un mot-clé ou une expression régulière. Le même monitor peut porter des sous-checks TLS, en-têtes de sécurité et hygiène DNS. Perstat suit les redirections sur 5 sauts au maximum et vérifie chaque destination de la chaîne à l’aide de la même liste de blocage SSRF.
Les checks sur les enregistrements A et AAAA conservent les résultats par famille d’adresses et par IP. Un monitor DNS peut comparer son ensemble de réponses à celui d’un autre monitor, en correspondance identique, en sous-ensemble ou en recouvrement.
Les hôtes et les jobs remontent directement
L’agent hôte natif prend en charge Linux sur x86_64 et aarch64, ainsi que macOS en binaire universel. Il remonte la disponibilité et les services nommés, avec le CPU, la mémoire et le disque.
L’agent ne lit ni lignes de commande, ni variables d’environnement, ni noms d’utilisateur. Il n’a aucun canal de commande à distance. Windows n’est pas pris en charge aujourd’hui.
Un heartbeat donne deux endpoints à un job : healthy et failure. Un silence qui dépasse la période configurée plus le délai de grâce place le heartbeat en panne. L’endpoint d’échec signale explicitement une exécution en échec, sans attendre cette fenêtre de silence.
La maintenance suspend les alertes et reste dans l’historique
Une fenêtre de maintenance planifiée empêche l’ouverture de nouveaux incidents, reste dans le registre de disponibilité et est exclue de l’uptime. Un faux positif écarté crée une fenêtre d’exclusion distincte et réversible, avec un motif et un auteur. Le registre de disponibilité explique ce parcours de revue.
Examiner un vrai monitor
L’offre fixe les régions et l’intervalle minimal
| Offre | Régions de sondes | Intervalle minimal (secondes) |
|---|---|---|
| Free | 2 | 300 |
| Pulse | 3 | 60 |
| Sentinel | 6 | 30 |
| Command | 6 | 15 |
| Enterprise | 6 | 10 |
Le formulaire web propose 30 secondes et plus. Sur Command et Enterprise, vous réglez 15 ou 10 secondes via MCP.
Les régions de sondes sont :
- Amérique du Nord
- Amérique du Sud
- Europe
- Afrique
- Asie
- Océanie
Les limites exactes de monitors, d’agents, de heartbeats et de rétention figurent sur la page des tarifs.
Commencez le monitoring gratuitement, ou configurez votre premier monitor avec la documentation des monitors.