Inserisci un indirizzo
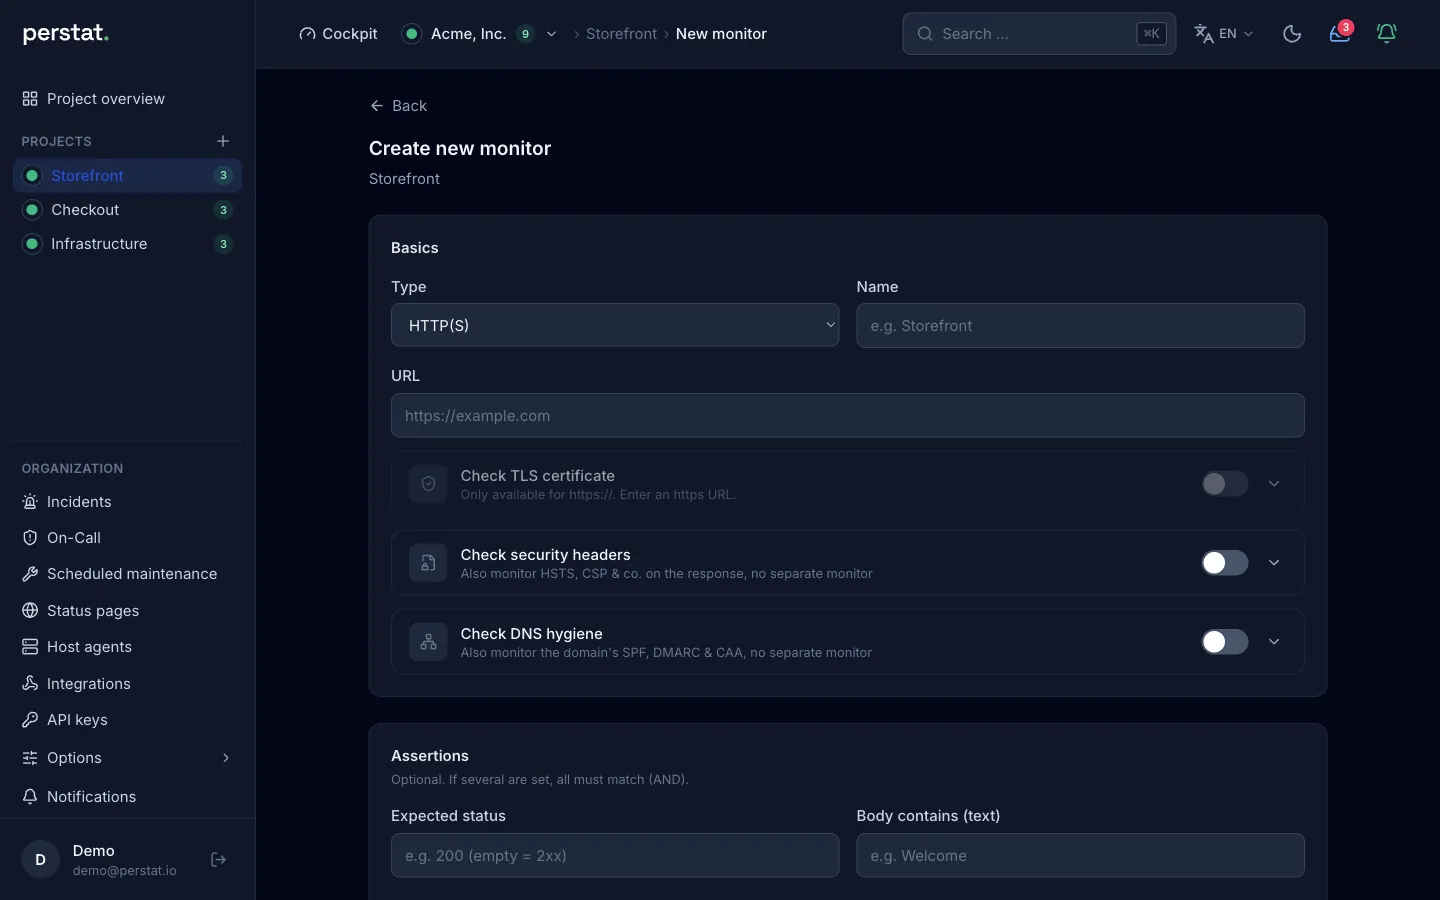
Crea un monitor HTTP per il sito o l’API. Scegli regioni e intervallo disponibili nel piano.
Free · 0 € / mese
10 monitor per siti e API, check da due regioni e una pagina di stato. Rileva i guasti e tieni informati i clienti.
Senza limiti di tempo. Senza carta di credito. Check ogni 5 minuti.
Stato di Perstatpagina di statoCrea un monitor HTTP per il sito o l’API. Scegli regioni e intervallo disponibili nel piano.
Attiva le notifiche push su iPhone o scegli un connettore esistente. SMS personali da Pulse, chiamate di reperibilità da Sentinel.
Fai fallire in modo controllato un endpoint di prova che gestisci. Attendi il guasto confermato e verifica l’avviso. Poi ripristina l’endpoint.
Il pulsante Test verifica solo il check e non registra un incident. Non sostituisce questa prova. Usa un servizio di test, non quello di un cliente.
Un check fallisce. Raggiunto il quorum, Perstat apre un incident. Una persona lo prende in carico; il ripristino confermato lo chiude. Incident automatici e presa in carico in ogni piano. Reperibilità con SMS e chiamate da Sentinel a 89 € netti al mese.
Apri la guidaEsempio: dieci clienti, ciascuno con un progetto e una pagina di stato sul proprio dominio. Sentinel include cinque pagine; cinque aggiuntive portano a 89 € + 5 × 9 € = 134 € netti al mese. White-label richiede Command a 249 €, fino a 20 pagine.
I progetti non sono console private per i clienti. I check HTTP verificano una richiesta, non un acquisto completo nel browser o tutte le immagini.
Apri la guidaCrea un heartbeat, copia l’URL segreto e invia il primo ping. Segnala solo successi reali; usa l’URL di errore per i fallimenti. Per provare l’avviso, lascia scadere un job di test dopo il primo ping.
if /path/to/job.sh; then
  curl --fail --silent --show-error "$PERSTAT_PING_URL"
else
  curl --fail --silent --show-error "$PERSTAT_PING_URL/fail"
  exit 1
fi
Free include due heartbeat. Il segnale conferma il rapporto del job, non il ripristino riuscito di un backup.
Apri la guidaQuattro rapporti pubblici sugli incidenti mostrano il valore di uno sguardo esterno.
Verifica la disponibilità dall’esterno della tua piattaforma.
Google Cloud
Durante il guasto del cloud, anche il monitoring di alcuni clienti ha smesso di funzionare.
Un check dell’URL usato dai tuoi clienti ti fornisce un segnale di guasto indipendente.
Atlassian
Il primo ticket di un cliente è arrivato 8 minuti dopo l’inizio del guasto.
I check DNS segnalano quando un nome di dominio non si risolve più.
Marketo
Un problema DNS ha reso irraggiungibile la pagina di accesso.
Un heartbeat ti avvisa quando manca un segnale di successo atteso.
GitLab
I job di backup sono falliti e le loro e-mail di errore sono state respinte.
Perstat copre la catena che va dal check fallito fino alle evidenze. Non è una suite di osservabilità, per scelta.
Al posto di UptimeRobot, Pingdom o dei check di uptime di una suite più ampia: 13 tipi di check da regioni indicate per nome.
Al posto di Atlassian Statuspage: pagine pubbliche o protette, alimentate dagli stessi monitor e incident.
Al posto della parte uptime di Opsgenie o PagerDuty: presa in carico dal telefono, più turni ed escalation.
Log, trace, APM e alert di altri strumenti restano dove sono. Perstat non li acquisisce.
L’endpoint MCP che registra i monitor serve anche agenti e script. Ogni scrittura è attribuita alla persona che ha creato la chiave, e il suo ruolo attuale viene verificato a ogni chiamata.
Leggi la documentazione MCPcreate_projectCrea un progettocreate_monitorCrea un monitorupdate_monitorModifica nome, impostazioni, intervallo o regioniset_monitor_enabledMetti in pausa o riattiva un monitorarchive_monitorArchivia un monitor e libera il suo posto nel pianorestore_monitorRipristina un monitor archiviato, in pausaacknowledge_incidentPrendi in carico un incidentresolve_incidentRisolvi un incidentdelete_monitorLe app mostrano alert a tutto schermo, ti fanno prendere in carico con uno swipe e mettono l’incident aperto sulla schermata di blocco come Attività in tempo reale. Non esiste un’app Android nativa, ma gli SMS da Pulse e le telefonate di reperibilità da Sentinel raggiungono ogni telefono.
Vedi su App StoreFree costa 0 € al mese, senza limiti di tempo. Passa a un piano a pagamento quando servono più monitor o funzionalità.
0 € al mese. 10 monitor, due heartbeat e una pagina di stato. Incident automatici e presa in carico inclusi.
SMS personali, 50 monitor e tre posti. 29 € netti/mese.
Rotazioni, SMS e chiamate, 150 monitor e 15 posti. 89 € netti/mese.
Domini di stato da 89 €, white-label da 249 € netti/mese. Controlla i limiti delle pagine.
Scorri di lato per confrontare tutti i piani
| Cosa cambia con ogni piano | Free0 €/ meseSenza limiti di tempo | Pulse29 €/ mese | Sentinel89 €/ mese | Command249 €/ mese | Enterpriseda 690 €/ mese |
|---|---|---|---|---|---|
| Monitor | 10 | 50 | 150 | 500 | su misura |
| Utenti | 1 | 3 | 15 | 30 | su misura |
| Intervallo minimo | 300 s | 60 s | 30 s | 15 s | 10 s |
| Regioni delle sonde | 2 su 6 | 3 su 6 | tutte e 6 | tutte e 6 | tutte e 6 |
| Storico pubblico* | 7 giorni | 30 giorni | 90 giorni | 1 anno | 2 anni |
| Pagine di stato | 1 | 1 | 5 | 20 | su misura |
| Reperibilità, incident manuali, post-mortem | no | no | inclusi | inclusi | inclusi |
Prezzi al mese in EUR, netti, IVA esclusa. Enterprise parte dall’importo indicato. *Questi valori limitano lo storico pubblico degli incident risolti. Gli altri oggetti dati seguono oggi regole separate di archiviazione e cancellazione. Verifica i limiti di conservazione documentati prima dell’acquisto.
Gestito da Datargo GmbH in Germania.
Le sedi delle sonde sono elencate per nome, non nascoste dietro una mappa del mondo.
Screenshot del prodotto, pagina di stato pubblica, report di esempio e limiti attuali per il procurement sono visibili senza login.
Un dialogo di esempio mostra la configurazione con un agente. Le immagini Perstat mostrano il prodotto reale con dati di esempio, non una registrazione del dialogo.
Il tuo sito o la tua API sono pronti. Chiedi all’agente collegato di includere il monitoraggio, senza aprire un secondo modulo.
L’esempio presuppone che Perstat sia collegato e che l’agente abbia permessi di scrittura sul progetto.
Esplora il monitoraggio della disponibilitàL’agente può creare un monitor URL tramite MCP o modificare un monitor esistente. Conferma la configurazione nel dialogo.
La creazione precede il primo controllo. Intervallo e regioni dipendono dal piano.
Esplora il monitoraggio della disponibilitàPerstat controlla l’URL dall’esterno. Risultati e tempi di risposta compaiono nel monitor anche dopo aver chiuso l’agente.
Un controllo HTTP riuscito verifica l’endpoint configurato. Non testa un intero percorso d’acquisto.
Esplora il monitoraggio della disponibilità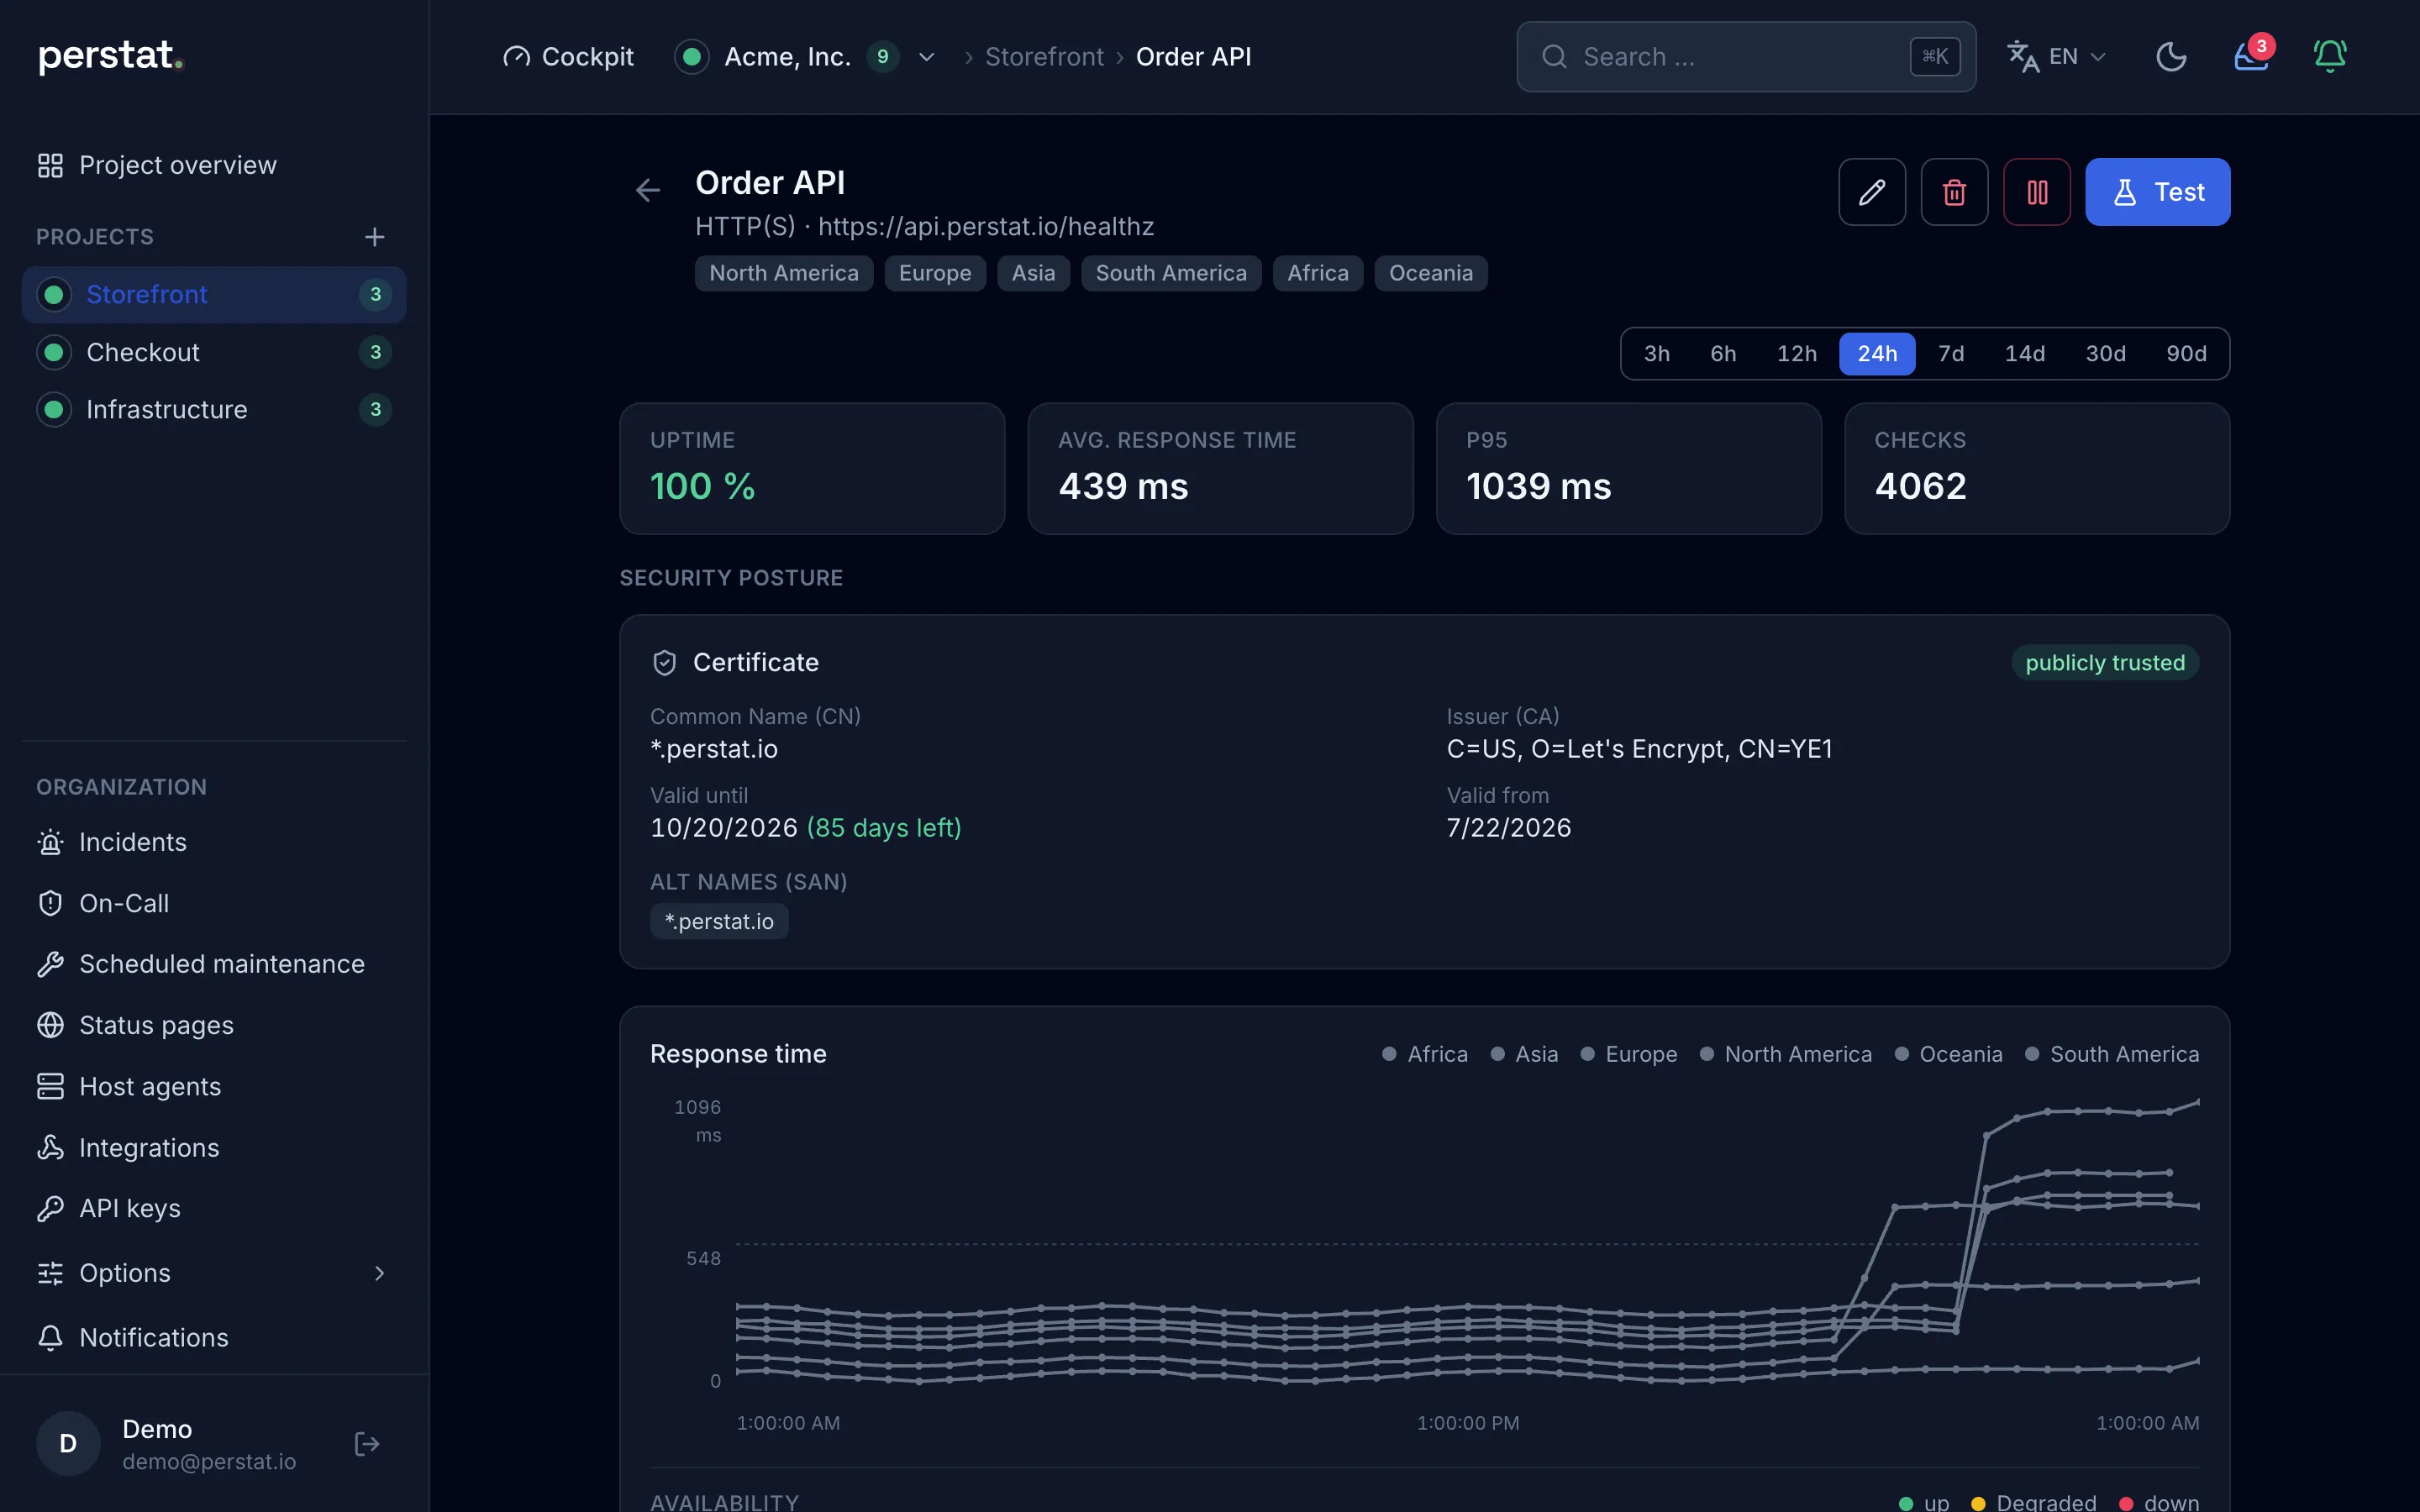
Quando si verificano le condizioni di errore configurate, Perstat apre un incidente e ti avvisa tramite i canali scelti.
Per i controlli regionali servono due regioni per la conferma predefinita. Prendere in carico l’allarme non ripara il servizio.
Esplora il monitoraggio della disponibilità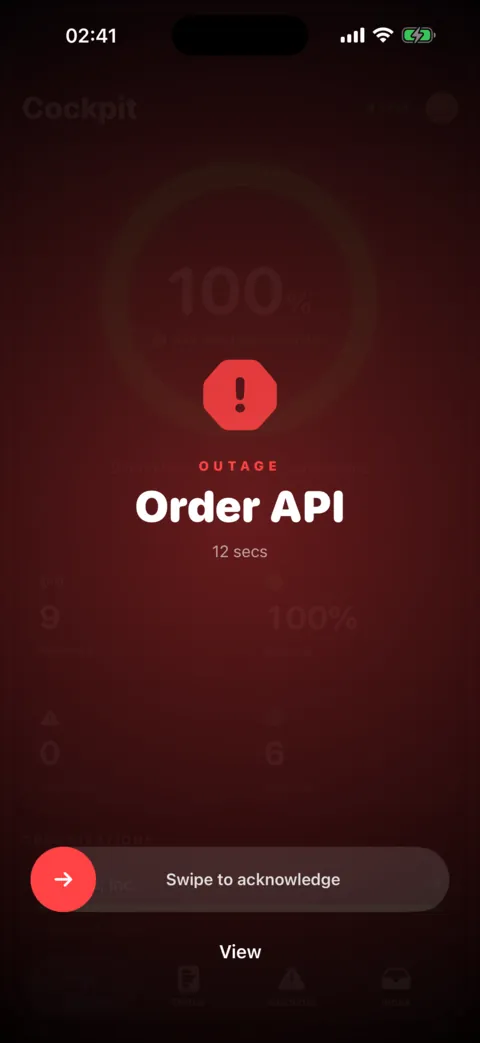
Un processo può fermarsi mentre il server risponde. Un heartbeat indica a Perstat quando quel processo invia il proprio segnale.
L’esempio segue un rapporto orario. Lo stesso principio vale per un processo di backup.
Esplora il monitoraggio heartbeatCrea l’heartbeat e aggiungi il suo indirizzo privato al processo. Invia il segnale di successo dopo la conclusione corretta.
Mantieni segreto l’indirizzo. Il supporto MCP dipende dal server e dal client collegati.
Esplora il monitoraggio heartbeatEsegui il processo e verifica la ricezione del segnale in Perstat. Le esecuzioni successive seguono lo stesso calendario.
L’heartbeat di un backup conferma il segnale. Non verifica che il backup possa essere ripristinato.
Esplora il monitoraggio heartbeatSe il segnale supera intervallo e tolleranza, Perstat può aprire un incidente e avvisare i destinatari configurati.
Gli heartbeat seguono il calendario del processo, senza quorum regionale.
Esplora il monitoraggio heartbeatAPI e MCP sono opzioni aggiuntive. Il percorso seguente è un esempio dichiarato.
Salta la storiaorder-api 2.16.0 aggiunge un webhook dei pagamenti. Degli ultimi 8 deploy, 3 hanno rilasciato un endpoint, un job o un servizio senza monitor, perché crearlo era un compito separato.
09-10 11:47search-indexer 1.9.3worker poolmonitorato09-09 09:15auth-service 3.1.1token rotationmonitorato09-08 10:05mail-relay 1.4.2patchmonitorato09-05 15:30order-api 2.15.4patchmonitorato09-05 08:12status-sync 0.3.0cron jobmonitorato3 deploy su 8 hanno aggiunto qualcosa senza monitor
Un passaggio dopo il deploy crea il monitor tramite l’API REST. La chiave API dell’organizzazione richiede monitors:write e l’accesso al progetto. Gli errori HTTP fanno fallire il passaggio.
# dopo il job di release: registra il monitor
- name: Register monitor
  run: |
    curl --silent --show-error --fail-with-body \
      "https://api.perstat.io/projects/$PERSTAT_PROJECT_ID/monitors" \
      --header "Authorization: Bearer $PERSTAT_API_KEY" \
      --header "Content-Type: application/json" \
      --data '{
        "name": "Order API", "type": "http",
        "config": {"url": "https://orders.example.com/health"},
        "interval_seconds": 300,
        "regions": ["na", "eu", "as", "sa", "af", "oce"]
}'L’API restituisce il monitor con il suo ID. Conservatelo e usate PATCH per le modifiche successive. Creare di nuovo lo stesso nome restituisce un conflitto, non un successo implicito.
{
  "id": "mon_…",
  "name": "Order API",
  "type": "http",
  "enabled": true,
  "interval_seconds": 300,
  "regions": [
    "na",
    "eu",
    "as",
    "sa",
    "af",
    "oce"
  ]
}Aggiornare l’ID salvato con PATCH /monitors/{monitor_id}.
I nodi sonda su 6 continenti eseguono il check all’intervallo impostato. Perstat salva ogni risultato con la regione che l’ha misurato.
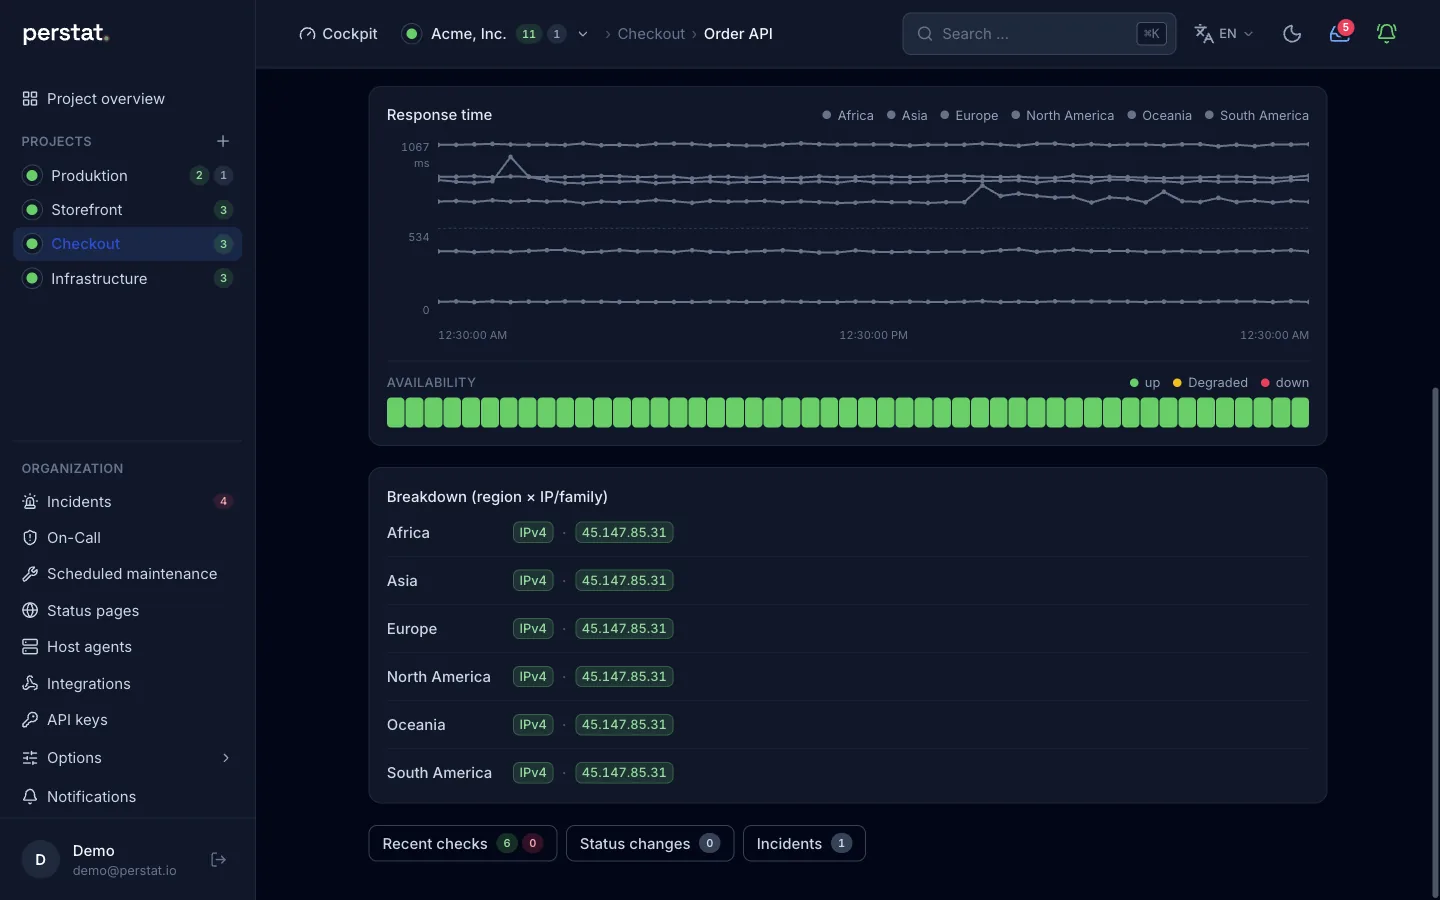
naNord AmericasaSud AmericaeuEuropaafAfricaasAsiaoceOceaniaUn errore in una sola regione è una segnalazione silenziosa, non un alert. Quando anche una seconda regione segnala un errore, il quorum predefinito conferma il disservizio e apre esattamente un incident.
naewrNewarkOKErroresagruSão PauloOKeufraFrancoforteOKafjnbJohannesburgOKassgpSingaporeOKErroreocesydSydneyOKna (Newark) segnala un errore: segnalazione silenziosa, nessuno viene ancora avvisato.
Anche as (Singapore) segnala un errore: quorum raggiunto, incident aperto alle 02:41:12 UTC.
Perstat invia l’alert a iPhone e Apple Watch, e a Slack, Teams o PagerDuty tramite i connettori. L’escalation di reperibilità passa poi a SMS e a una telefonata, fino alla presa in carico.
Escalation di reperibilità: Sentinel e superiori
Alert SMS personali senza turni: Pulse e superiori
acknowledge_incidentOppure dal terminale: il tuo agente chiama acknowledge_incident via MCP, e la presa in carico viene attribuita al titolare della chiave.
L’incident aperto dal quorum compare sulla pagina di stato collegata con la sua fase attuale, e il componente passa a Down. Nessuno deve ricopiarlo a mano.
02:41:12 UTCQuando le regioni segnalano il ripristino, l’incident si chiude con inizio, fine e durata confermati. La manutenzione annunciata viene esclusa per la durata della sua finestra. Perstat calcola la disponibilità dallo stesso registro.
Order APIQ2 20262026-05-03 02:41:12Incident confermato dal quorum00:07:122026-05-17 22:00:00Manutenzione annunciata ed esclusa01:30:00Export: report PDF per monitor da 7 a 90 giorni. CSV con manifest su richiesta.
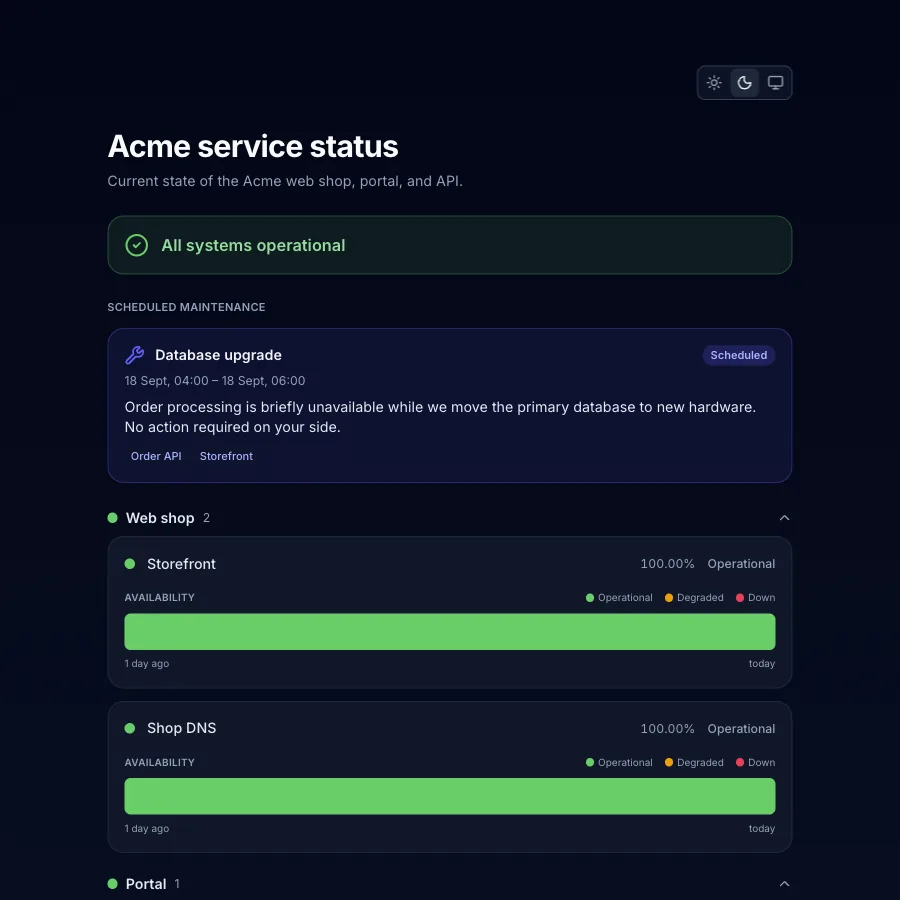
La pagina di stato sul tuo dominio mostra lo stato dei servizi, come questo aggiornamento programmato del database. La pagina e il badge sul tuo sito leggono dal registro su cui si basa la cifra di disponibilità.
Dominio personalizzato: Sentinel e superiori

<img src="https://status.example.com/badge.svg" alt="Service status">
Lo stesso badge sul tuo sito, servito dal tuo dominio. Mostra quello che mostra la pagina.Inizia con un sito o una API. Free include 10 monitor, due regioni di check e una pagina di stato, senza carta di credito né limiti di tempo.
