In questa pagina
Cosa verifica
Un monitor dell’host agent si lega a un agent installato su uno dei tuoi host e osserva una metrica. availability osserva se l’agent si fa ancora vivo. cpu, mem e disk confrontano l’uso in percentuale con una soglia, e service verifica che un processo indicato per nome sia in esecuzione. L’agent riporta al control plane, e il server giudica l’ultimo rapporto circa ogni 30 s. Una violazione apre un incident, con un push secondo notify_push, oppure genera solo un avviso in-app, come stabilisce breach_severity. Un agent porta più monitor, uno per metrica o processo.
Da usare quando
- Un host esegue qualcosa senza una porta da sondare, oppure la porta risponde ancora mentre l’host ha esaurito memoria o disco.
- Un processo deve restare in esecuzione: un database, un worker di coda o un reverse proxy. Un riavvio più breve della tolleranza non conta come violazione.
- Un host deve dare l’allarme quando smette del tutto di riportare, con una tolleranza tale che un reboot entro quel tempo non apra un incident.
Il check non misura nulla via rete. La raggiungibilità di una porta o di un URL da internet richiede il check ping, TCP o HTTP(S). Un job cron o un batch senza un processo da osservare richiede il check heartbeat.
Configurazione
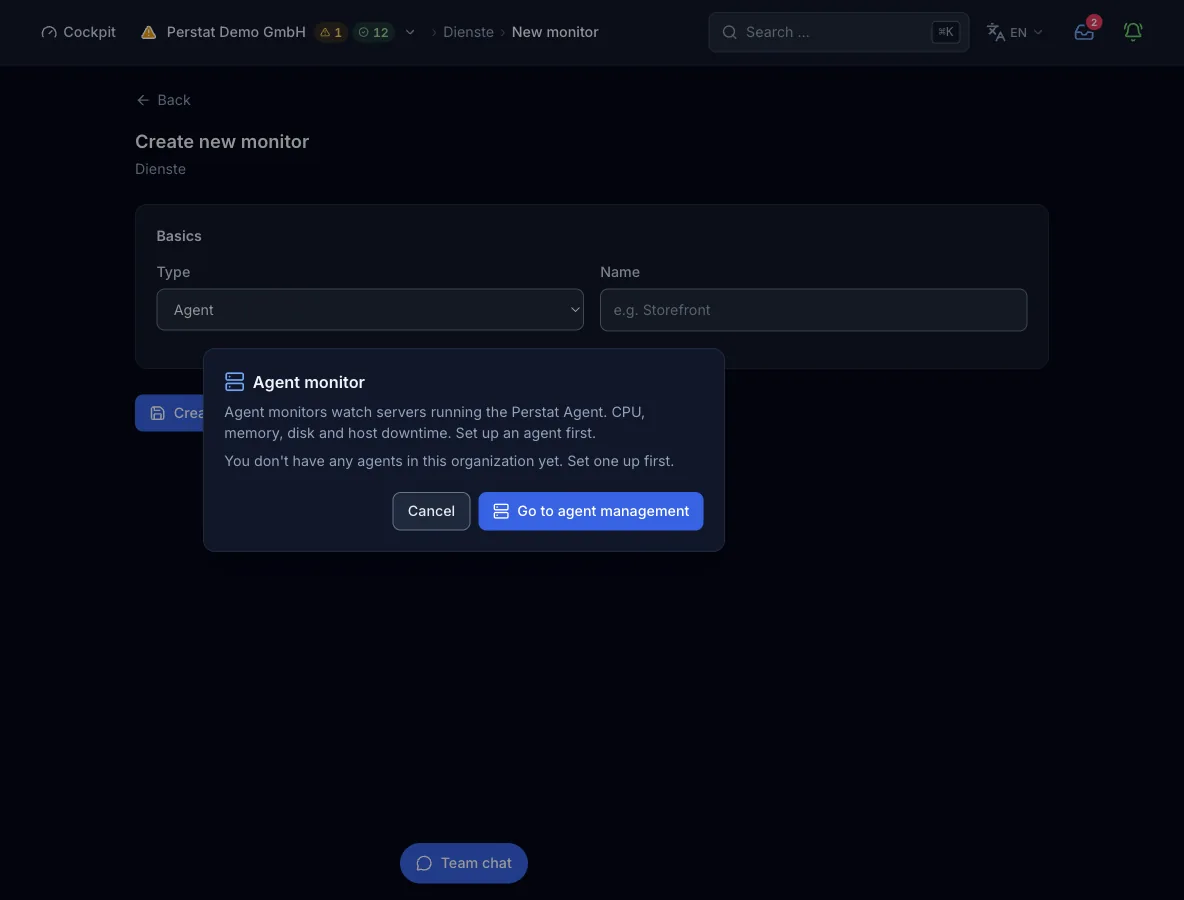
Agent. Nessun target di rete. Il monitor si lega a un host agent della tua organizzazione tramite il suo agent_id, e il modulo elenca gli agent registrati. Il rapporto arriva dall’host, quindi il check non ha regioni, famiglie IP né un intervallo proprio.
| Campo | Obbligatorio | Valori e default | Significato |
|---|---|---|---|
agent_idAgent | sì | ID pubblico di un agent registrato nella tua organizzazione | Quale host osserva il monitor. Il modulo elenca gli agent registrati, mentre API e MCP accettano l’ID. |
metricMetrica | sì | availability, cpu, mem, disk, service | Cosa giudica il server: i rapporti dell’agent, un valore d’uso in percentuale per CPU, memoria o disco, oppure un processo in esecuzione. Un monitor osserva una metrica. |
thresholdSoglia | opzionale | Percentuale, da 0 a 100, default 90. Usata da cpu, mem e disk | Un valore sopra la soglia è una violazione. Ignorata da availability e service. |
grace_seconds | opzionale | Da 60 a 3600 s. Default 180 per availability, 120 per service | Per quanto l’agent può restare muto, o il processo fermo, prima che la passata conti una violazione. Un intervallo più breve non conta. Si imposta tramite API o MCP, e il modulo mantiene il valore memorizzato quando modifichi. |
service_nameNome del servizio | opzionale | Da 1 a 64 caratteri tra lettere, cifre, ., _ e -. Obbligatorio con service | Il nome del processo sull’host, per esempio nginx. La passata cerca una voce recente con quel nome nel rapporto dell’agent. |
breach_severityGravità | opzionale | critical (default) oppure degraded | critical registra un check fallito e apre un incident, con un push secondo notify_push. degraded registra un check degradato e genera solo l’avviso in-app. |
notify_pushNotifica push | opzionale | true (default) oppure false | Invia una notifica push a una violazione critica. Non ha effetto con degraded. |
Come si svolge un check
- L’agent sull’host riporta al control plane. Circa ogni 30 s il server carica l’ultimo rapporto dell’agent per questo monitor. Nessuna regione di sonda partecipa, e il check non tocca mai l’host via rete.
availability: il server confronta l’età dell’ultimo rapporto congrace_seconds. Un rapporto più vecchio della tolleranza è una violazione.cpu,mem,disk: giudicati solo finché l’ultimo rapporto ha al massimo 180 s, e un valore soprathresholdè una violazione. Senza un valore recente la passata non registra alcun risultato, invece di un falso allarme. L’host muto è compito della metricaavailability.service: giudicato solo con un rapporto recente e una voce recente per il processo indicato. Un processo che non è in esecuzione da più digrace_secondsè una violazione.- Una violazione diventa un check fallito con gravità critica oppure un check degradato, come stabilisce
breach_severity. La gravità critica apre un incident con un push secondonotify_push, quella degradata genera solo un avviso in-app. Allarme e ripristino sono fissi a 1 valutazione ciascuno, quindi decide la passata successiva.
Cosa contiene un risultato
- Stato e gravità
- passed, degraded o failed, con gravità ok, degraded o critical. La regione è
agent, il marcatore di un check lato server. - Riga di dettaglio
- Una riga con il fatto giudicato. Mostra l’età dell’ultimo rapporto rispetto alla tolleranza, il valore rispetto alla soglia (
CPU 95% > 90%), oppure il processo con il numero di processi e la quota di CPU. - Latenza e codice di risposta
- Nulla viene misurato via rete, quindi un risultato non porta né un tempo di risposta né un codice di stato.
Stati e gravità
- okL’ultimo rapporto è entro la tolleranza, il valore è pari o inferiore alla soglia, oppure il processo è in esecuzione.
- degradatoUna violazione con
breach_severityimpostato sudegraded. Viene registrata e mostrata come avviso in-app, senza incident e senza push. - downUna violazione con
breach_severityimpostato sucritical, il default. L’agent è rimasto muto oltre la tolleranza, un valore ha superato la soglia oppure il processo si è fermato per più della tolleranza. Apre un incident, con un push secondonotify_push. - erroreCompare solo in un’esecuzione di prova. Quando la metrica non può essere giudicata, per esempio senza un rapporto recente, l’esecuzione risponde errore con una diagnosi. Nulla viene memorizzato e nessun incident si apre.
- in attesaNessun risultato ancora, subito dopo la creazione o finché l’agent non ha inviato un valore recente per la metrica. La passata non registra nulla invece di un falso allarme.
Il segnale arriva dal tuo host o dal tuo job, senza regioni né quorum, quindi conta anche un solo report mancato. Allarme e ripristino sono fissi a 1 valutazione ciascuno. La passata che vede la violazione apre l’incident, e una valutazione superata conta come ripristino.
Piani e limiti
- Host agent
- 2 in Free, 10 in Pulse, 50 in Sentinel e 200 in Command. Le quote di Enterprise sono su misura. Un pacchetto aggiuntivo aggiunge 10 agent per 19 €.
- Monitor per agent
- 25 in Free, Pulse, Sentinel e Command. Le quote di Enterprise sono su misura. Un monitor dell’host agent conta qui, non nella quota dei monitor di sonda.
- Intervallo e regioni
- Non applicabili. Il server valuta circa ogni 30 s, e i minimi di intervallo e il numero di regioni dei piani non valgono per questo tipo.
Dalla pipeline o da un agente
La stessa config funziona nello step di deploy, in un client MCP come Claude Code e nel modulo qui sopra. create_monitor richiede una chiave API valida per tutta l’organizzazione. Se ometti regions, il piano sceglie il suo default.
{
  "name": "web-01 CPU",
  "type": "agent",
  "config": {
    "agent_id": "agt_...",
    "metric": "cpu",
    "threshold": 90,
    "breach_severity": "degraded",
    "notify_push": true
  }
}
Ogni interfaccia, con il suo limite
Limiti
- L’agent riporta quattro metriche (disponibilità, CPU, memoria e disco) e lo stato di un processo indicato per nome. Altre metriche e valori personalizzati non sono disponibili.
- CPU, memoria e disco non vengono giudicati mentre l’agent è muto. Affianca a un monitor con soglia un monitor
availabilitysullo stesso agent per intercettare l’host muto. grace_secondssi imposta tramite API o MCP. Il modulo mantiene il valore memorizzato quando modifichi.- Il tipo non ha intervallo, regioni o regola di alert propri, e il modulo li nasconde tutti e tre. Il server valuta tutti i monitor agent in una sola passata circa ogni 30 s e ignora
regionsin una richiesta.interval_secondsviene memorizzato a una modifica e mostrato nel monitor, ma la valutazione non legge né quel valore né i 60 s impostati alla creazione. agent_iddeve indicare un agent già registrato nella tua organizzazione. L’ID arriva dalla registrazione dell’agent, e il monitor non lo crea.