In questa pagina
Cosa verifica
Un monitor heartbeat verifica che un job sia girato quando doveva. La creazione del monitor genera un URL segreto, e il job lo richiede alla fine di ogni esecuzione. Circa ogni 30 s il control plane confronta l’età dell’ultimo ping con il periodo atteso più la tolleranza. Un ping più vecchio, o un ultimo ping arrivato sull’URL di fallimento, è una violazione. Finché non arriva il primo ping il monitor è in attesa, non down.
Da usare quando
- Un job pianificato non ha un indirizzo da sondare: un’esecuzione di cron, un backup notturno, un importer o un worker che deve finire in tempo.
- Il guasto che devi vedere è che qualcosa non è successo. Un job che non è mai partito non lascia nulla di rotto che una sonda possa raggiungere.
- Il job può giudicare la propria esecuzione. Chiama l’URL di ping dopo il successo e l’URL di fallimento quando i suoi controlli falliscono. Il monitor va allora in down alla valutazione successiva, senza aspettare la scadenza della pianificazione.
Il check registra solo quando arriva la chiamata. Un servizio in ascolto su una porta richiede il check HTTP(S) o TCP. CPU, memoria, disco e processi dell’host stesso richiedono il check dell’host agent.
Configurazione
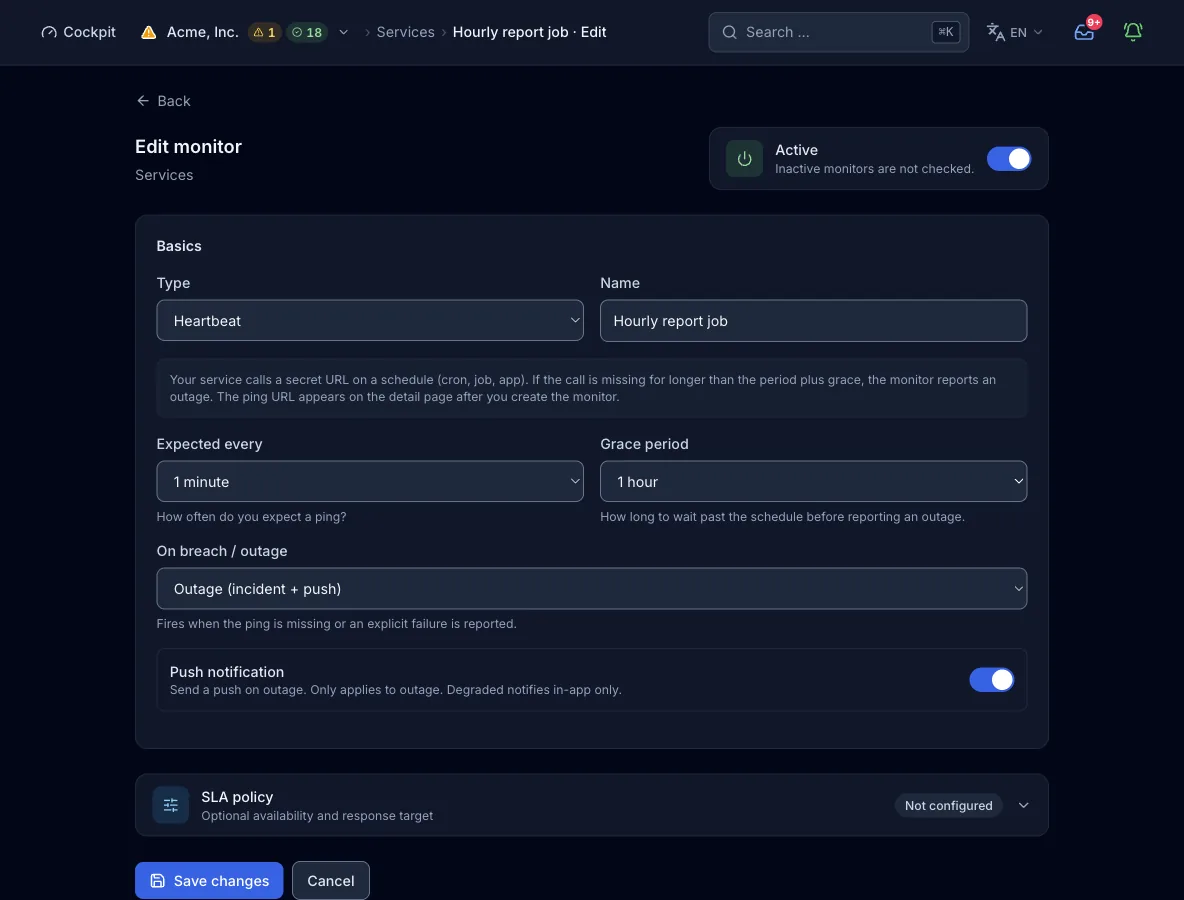
Target. Nessuno. Un heartbeat non ha target, regioni di sonda, famiglie IP né un intervallo di check proprio. Il modulo nasconde quei campi, e il control plane valuta il monitor circa ogni 30 s sotto la pseudo-regione heartbeat. La creazione del monitor genera l’URL segreto https://api.perstat.io/ping/{token}. La vista del monitor lo mostra insieme all’URL di fallimento (con /fail in coda).
| Campo | Obbligatorio | Valori e default | Significato |
|---|---|---|---|
period_secondsAtteso ogni | opzionale | Secondi, da 30 a 2.592.000 (30 giorni), default 3600 | Ogni quanto il job deve inviare il ping. Il modulo offre valori predefiniti, e l’API normalizza qualsiasi numero di secondi nell’intervallo ammesso. |
grace_secondsPeriodo di tolleranza | opzionale | Secondi, da 0 a 86.400 (24 h). Default: un quinto del periodo, mantenuto tra 60 e 3600 | Per quanto tempo, trascorso il periodo, un ping può ancora arrivare prima che il monitor conti una violazione. Il valore 0 imposta una scadenza rigida. Imposta la tolleranza a una frazione reale del periodo, perché un backup notturno con 60 s di tolleranza fa scattare un avviso a ogni notte lenta. |
breach_severityIn caso di violazione / disservizio | opzionale | critical (default) oppure degraded | critical mette il monitor in down e apre un incident, con un push secondo notify_push. degraded lo mette in degradato con solo un avviso in-app, e qualsiasi altro valore viene memorizzato come critical. |
notify_pushNotifica push | opzionale | true (default) oppure false | Invia una notifica push in caso di disservizio con critical. Una violazione degradata avvisa comunque in-app. |
Come si svolge un check
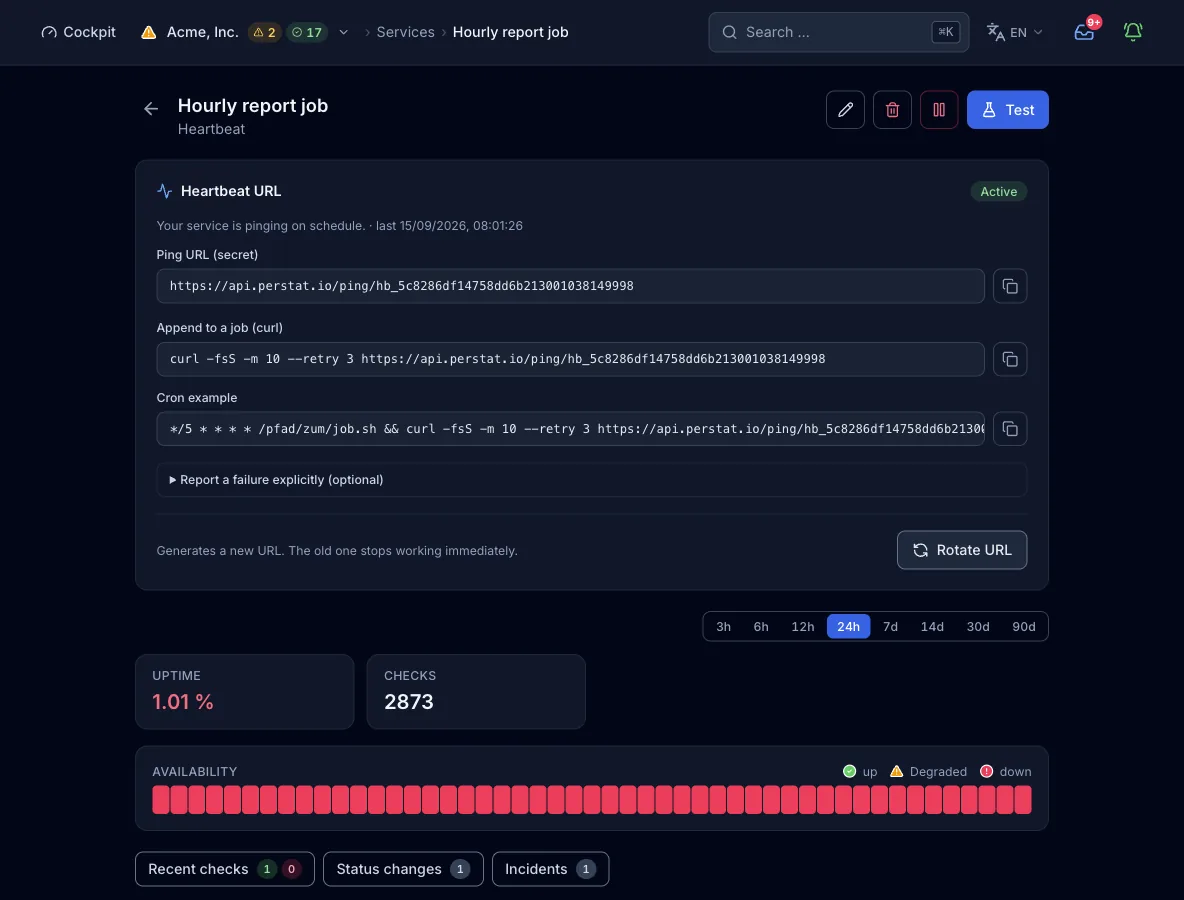
- La creazione del monitor genera il token, e la vista del monitor mostra l’URL di ping e l’URL di fallimento. Collega l’URL di ping al job, per esempio come ultimo comando della riga di cron.
- Il job richiede l’URL di ping con GET o POST quando un’esecuzione termina. Quando l’esecuzione stabilisce di essere fallita, il job richiede invece l’URL di fallimento.
- Circa ogni 30 s il control plane valuta il monitor. Fino al primo ping il monitor resta in attesa e nessun risultato viene scritto.
- Un ultimo ping arrivato sull’URL di fallimento è una violazione. Lo è anche un ultimo ping più vecchio di periodo più tolleranza.
- Una violazione prende la gravità configurata.
criticalmette il monitor in down e apre un incident, con un push se abilitato, mentredegradedlo mette in degradato con solo un avviso in-app. Allarme e ripristino sono fissi a 1 check ciascuno, quindi il ping sano successivo risolve l’incident alla valutazione successiva. - Il pulsante Test esegue la stessa valutazione su richiesta e mostra il risultato solo a te. Nulla viene memorizzato e nessun incident si apre.
Cosa contiene un risultato
- Stato e gravità
- passed, failed o degraded, con gravità ok, degraded o critical. Un heartbeat che non ha mai fatto ping mostra in attesa.
- Riga di dettaglio
- Una riga che dice cosa è successo. Riporta un heartbeat aggiornato con l’età dell’ultimo ping, nessun heartbeat da N secondi rispetto al periodo atteso e alla tolleranza, oppure un fallimento riportato dal job.
- Ultimo ping
- Il pannello heartbeat della vista del monitor mostra l’ora dell’ultimo ping. Sta nella riga di stato sopra l’URL di ping, accanto al badge Active o Waiting. Se quel ping era sano o un fallimento lo dice la riga di dettaglio della valutazione successiva, non il pannello.
- Regione
- Ogni risultato porta la pseudo-regione
heartbeat. Non ci sono latenza, codice di risposta né sotto-risultati.
Stati e gravità
- okL’ultimo ping è arrivato entro periodo più tolleranza ed era un ping sano.
- degradatoUna violazione con
breach_severityimpostato sudegraded. Genera un avviso in-app, senza incident e senza push. - downUna violazione con la gravità predefinita
critical: l’ultimo ping è più vecchio di periodo più tolleranza, oppure il job ha chiamato l’URL di fallimento. Apre un incident, con un push secondonotify_push. - in attesaNessun ping è ancora arrivato. Il monitor mostra in attesa finché il job non chiama l’URL per la prima volta.
Il segnale arriva dal tuo host o dal tuo job, senza regioni né quorum, quindi conta anche un solo report mancato. Il control plane valuta circa ogni 30 s, con allarme e ripristino fissi a 1 check ciascuno. Una violazione diventa un incident alla prima valutazione dopo che periodo più tolleranza sono trascorsi.
Piani e limiti
- Intervallo di valutazione
- Circa 30 s in ogni piano, fissato dal server. Il minimo di intervallo del piano vale solo per i tipi di check regionali.
- Regioni
- Nessuna. Il job si fa vivo e nulla viene sondato, quindi il numero di regioni del piano non si applica.
- Heartbeat
- 2 in Free, 10 in Pulse, 50 in Sentinel e 200 in Command. Le quote di Enterprise sono su misura. Gli heartbeat hanno una quota propria e non occupano posti tra i monitor di sonda. Un pacchetto di 25 in più costa 9 €.
Dalla pipeline o da un agente
La stessa config funziona nello step di deploy, in un client MCP come Claude Code e nel modulo qui sopra. create_monitor richiede una chiave API valida per tutta l’organizzazione. Se ometti regions, il piano sceglie il suo default.
{
  "name": "Nightly backup",
  "type": "heartbeat",
  "config": {
    "period_seconds": 86400,
    "grace_seconds": 1800,
    "breach_severity": "critical",
    "notify_push": true
  }
}
Ogni interfaccia, con il suo limite
Limiti
- Viene misurata solo l’ora della chiamata, senza durata, codice di uscita o payload.
- Fino al primo ping il monitor è in attesa. Un heartbeat che nessun job chiama sembra copertura, ma non lo è.
- L’URL di ping non è autenticato, quindi chi ha il token può fare ping. Trattalo come una credenziale. Se trapela, ruotalo nella vista del monitor, e il vecchio URL smette subito di funzionare.
- L’endpoint di ping accetta 240 richieste ogni 60 s per IP di origine. Un token sconosciuto riceve 404.
- Una richiesta di creazione via API o MCP non restituisce l’URL di ping. Leggilo nella vista del monitor e collegalo al job.
- La valutazione gira circa ogni 30 s, quindi una violazione viene notata fino a circa 30 s dopo che periodo più tolleranza sono trascorsi.