In questa pagina
Cosa verifica
A ogni intervallo, ciascuna regione di un monitor ping invia richieste ICMP echo a ogni indirizzo risolto dell’host. Per default sono 3 pacchetti da 32 byte, uno dopo l’altro, e ognuno attende fino a 10 s la sua risposta. Il monitor registra quante risposte sono tornate, la perdita in percentuale e il round trip medio. Tutte le risposte significano check superato, una perdita parziale significa degradato e il silenzio significa down, così un host sparito si distingue da un collegamento che perde pacchetti.
Da usare quando
- Un host non ha un servizio che valga la pena sondare, ma deve essere raggiungibile: un gateway, un router, un endpoint VPN o un semplice server.
- La perdita sul percorso verso un host deve essere visibile come segnale a sé, non confusa in un timeout applicativo.
- La raggiungibilità va misurata da più regioni, così un problema di routing in una regione risalta rispetto alle regioni che ricevono ancora risposte.
Un risultato ping non dice nulla sui servizi dell’host. Un host che risponde al ping può comunque avere un’applicazione in crash, e un host che filtra ICMP fallisce questo check pur servendo regolarmente. Usa il check TCP per una porta, il check HTTP(S) per un’applicazione, il check traceroute per il percorso in mezzo e l’host agent per un host tuo.
Configurazione
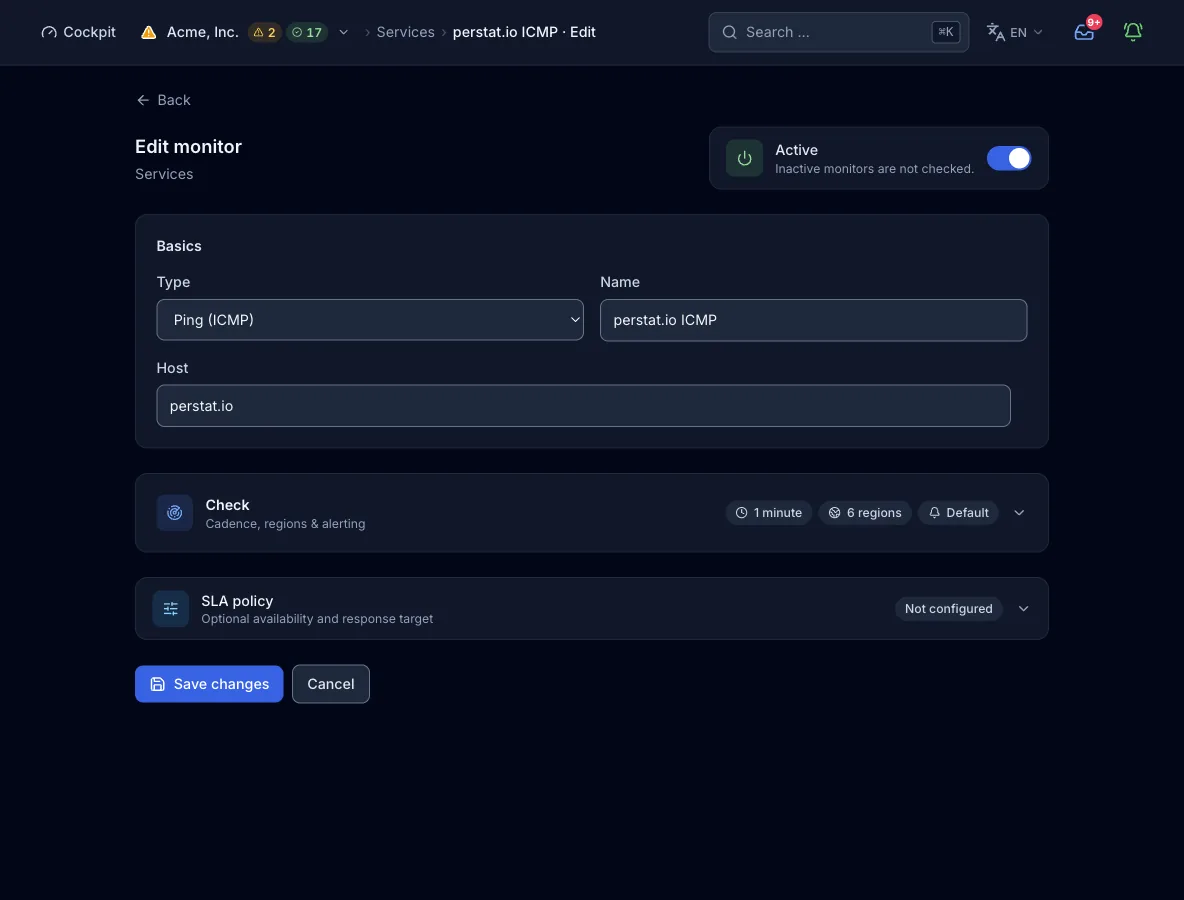
Target. Un nome host o un indirizzo IP, senza schema, percorso o porta. Le label arrivano a 63 caratteri, il nome intero a 253. La sonda risolve il nome tramite il proprio resolver e blocca gli indirizzi loopback, privati e link-local. Sono bloccati anche gli indirizzi di metadata cloud, carrier-grade NAT, multicast e broadcast, così il monitor non può essere puntato verso una rete interna.
| Campo | Obbligatorio | Valori e default | Significato |
|---|---|---|---|
hostHost | sì | Nome host o indirizzo IP | L’host che riceve le richieste echo. Ogni indirizzo verso cui risolve nella famiglia IP scelta viene pingato separatamente. |
count | opzionale | 1-255, default 3. Il valore 0 conta come 1, e sopra 255 il check termina in errore | Pacchetti echo per indirizzo e per check, inviati uno dopo l’altro. Si imposta tramite API o MCP, e un monitor creato nel modulo usa 3. |
interval_secondsIntervallo del check | opzionale | Default 300. Alzato al minimo del piano, massimo 24 h | Ogni quanto ciascuna regione esegue il check. Il modulo offre valori preimpostati da 30 s a 1 h, e gli intervalli di 15 s o 10 s richiedono MCP. |
regionsRegioni | opzionale | Sottoinsieme di na, eu, as, sa, af, oce. Default: le regioni del piano | Quali continenti eseguono il check. Più regioni di quante il piano ne consenta vengono rifiutate, non tagliate. |
Famiglie IP
Con entrambe le famiglie, ogni indirizzo risolto di ciascuna famiglia viene pingato separatamente. Il risultato conserva un sotto-risultato per famiglia e per indirizzo, così un guasto limitato a IPv6 resta visibile come tale. Il modulo offre IPv6 solo quando l’host ha un record AAAA o è un letterale IPv6, e allora restano selezionabili solo le regioni che sondano IPv6.
| Campo | Obbligatorio | Valori e default | Significato |
|---|---|---|---|
address_familiesFamiglie IP | opzionale | Lista di ipv4, ipv6 o entrambi. Assente o vuota significa ["ipv4"] | Quali famiglie IP copre il check. |
family_fail_severity | opzionale | degraded (default) oppure failed | Cosa significa il fallimento di una famiglia mentre l’altra risponde. Dentro una famiglia, un indirizzo muto tra più è sempre degradato. |
Come si svolge un check
- Ogni regione a cui tocca l’intervallo risolve l’host tramite il resolver del proprio nodo. Un nome che risolve in un intervallo bloccato chiude il check come down.
- Ogni indirizzo risolto della famiglia scelta riceve
countrichieste echo da 32 byte, una dopo l’altra. Ogni richiesta attende fino a 10 s la sua risposta, e una risposta mancante conta come persa. - Per ogni indirizzo la sonda calcola la perdita in percentuale e il round trip medio delle risposte. Tutte le risposte significano superato, alcune risposte perse degradato e nessuna risposta fallito.
- Più indirizzi di una famiglia confluiscono in un solo verdetto: se tutti sono muti il check è down, se alcuni lo sono è degradato, altrimenti conta il risultato peggiore. Tra le famiglie,
family_fail_severitydecide cosa significa il fallimento di una sola famiglia. - Il risultato della regione va al control plane. Un incident si apre quando concorda il quorum della regola di alert, di default 2 regioni e 2 check consecutivi.
Cosa contiene un risultato
- Risposte e perdita
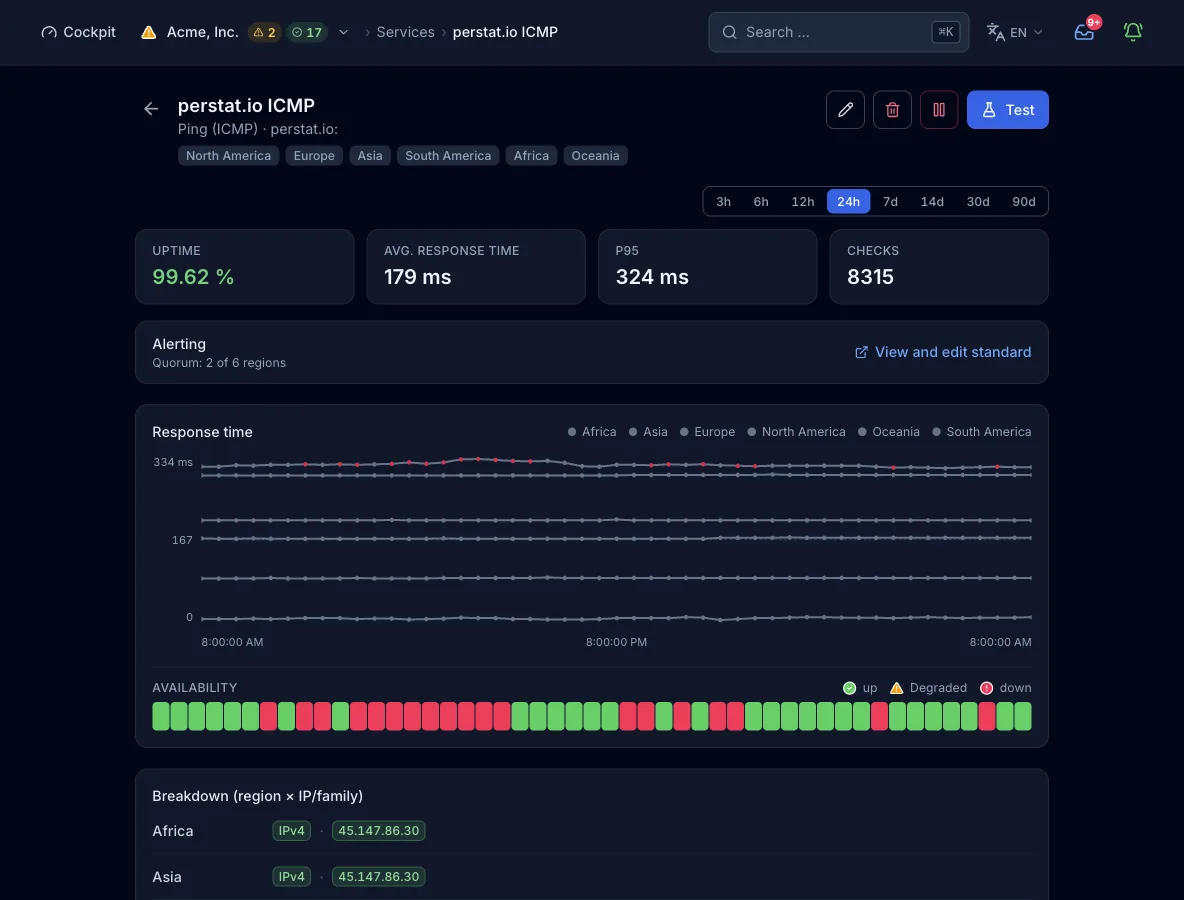
- Una riga per indirizzo con le risposte ricevute sui pacchetti inviati, la perdita in percentuale e il round trip medio. Per esempio: 3 risposte su 3 inviati, nessuna perdita, 12 ms di media.
- Tempo di risposta
- Il round trip medio delle risposte per indirizzo. Con più indirizzi, il minimo diventa il tempo di risposta del check.
- Livello della causa
- Un nome che non esiste (NXDOMAIN o NODATA) viene attribuito al DNS del target. Gli altri fallimenti di lookup restano senza attribuzione. Una volta riuscito il lookup, le risposte perse vengono attribuite al target.
- Regione, famiglia, indirizzo
- Ogni risultato porta la regione che l’ha misurato. Contiene un sotto-risultato per famiglia IP e per indirizzo, ciascuno con il proprio stato, round trip e riga di dettaglio.
Stati e gravità
- okOgni pacchetto verso ogni indirizzo ha ricevuto risposta.
- degradatoAlcuni pacchetti sono andati persi, oppure uno di più indirizzi è rimasto muto. Con la gravità predefinita è degradato anche il caso in cui una famiglia IP fallisce mentre l’altra risponde.
- downNessun indirizzo ha risposto, che l’host sia spento, irraggiungibile o filtri ICMP. Il check è down anche quando il nome non si risolve, quando il target sta in un intervallo bloccato o quando una famiglia fallisce con
family_fail_severityimpostato sufailed. - erroreIl nodo non può inviare ICMP, per esempio perché il raw socket viene rifiutato. Conta come disservizio con gravità critica.
Confermato dal quorum: di default, 2 regioni devono segnalare il guasto prima che si apra un incident. Il default dell’organizzazione richiede 2 regioni e 2 check consecutivi. Un monitor può avere una regola propria (numero o percentuale, check consecutivi, durata minima).
Piani e limiti
- Intervallo minimo
- 300 s in Free, 60 s in Pulse e 30 s in Sentinel. Command consente 15 s ed Enterprise 10 s, entrambi impostabili solo tramite MCP. Il modulo offre valori preimpostati da 30 s a 1 h.
- Regioni
- 2 su 6 in Free, 3 su 6 in Pulse e tutte e 6 da Sentinel.
- Monitor
- 10 in Free, 50 in Pulse, 150 in Sentinel e 500 in Command. Le quote di Enterprise sono su misura. La quota vale per tutti gli undici tipi di check regionali, e host agent e heartbeat hanno quote proprie.
Dalla pipeline o da un agente
La stessa config funziona nello step di deploy, in un client MCP come Claude Code e nel modulo qui sopra. create_monitor richiede una chiave API valida per tutta l’organizzazione. Se ometti regions, il piano sceglie il suo default.
{
  "name": "Office gateway",
  "type": "ping",
  "interval_seconds": 60,
  "config": {
    "host": "gateway.example.com",
    "count": 5
  }
}
Ogni interfaccia, con il suo limite
Limiti
- Un host che filtra ICMP fallisce il check anche mentre i suoi servizi rispondono. Affiancagli un check TCP o HTTP(S) sul servizio.
- Il check registra solo perdita e round trip medio, senza jitter, percentili o tempi per pacchetto.
- La dimensione del pacchetto è fissa a 32 byte, e
countsi imposta tramite API o MCP, non nel modulo. Con un host muto ogni pacchetto attende 10 s e il nodo interrompe un’esecuzione a 120 s, quindi tienicounta 12 o meno. - I risultati sono per indirizzo, non per salto. Il percorso spetta al check traceroute.
- I target su indirizzi privati, loopback, link-local e di metadata cloud vengono bloccati.
- Non tutte le regioni sondano IPv6, quindi selezionare
ipv6restringe le regioni utilizzabili.