In questa pagina
Cosa verifica
Un monitor traceroute esegue il traceroute di sistema verso l’host da ciascuna delle sue regioni, a ogni intervallo. Invia una sonda per salto con 2 s di attesa e segue di default fino a 20 salti. Il risultato contiene il numero di salti e l’ultima riga, e il target conta come raggiunto quando quell’ultimo salto ha risposto. Il tipo non misura tempi di risposta e non emette un verdetto di disponibilità. Un target non raggiunto è degradato, non down, e non apre mai un incident.
Da usare quando
- Un check ping o HTTP(S) accanto fallisce, e vuoi un registro per regione che dica se in quel momento il percorso raggiungeva ancora il target.
- Un host risponde da alcune regioni ma non da altre, e vuoi nel registro il numero di salti e l’ultimo salto di ogni regione.
- Il numero di salti e la riga dell’ultimo salto vanno registrati a ogni check, per regione, così un cambio di routing ha una marca temporale.
Un risultato traceroute non è un verdetto di disponibilità. Un target che filtra l’ultimo salto riporta degradato, mai down, e un percorso non completato non apre alcun incident. Per la raggiungibilità usa il check ping, per la risposta di un servizio il check HTTP(S) o TCP.
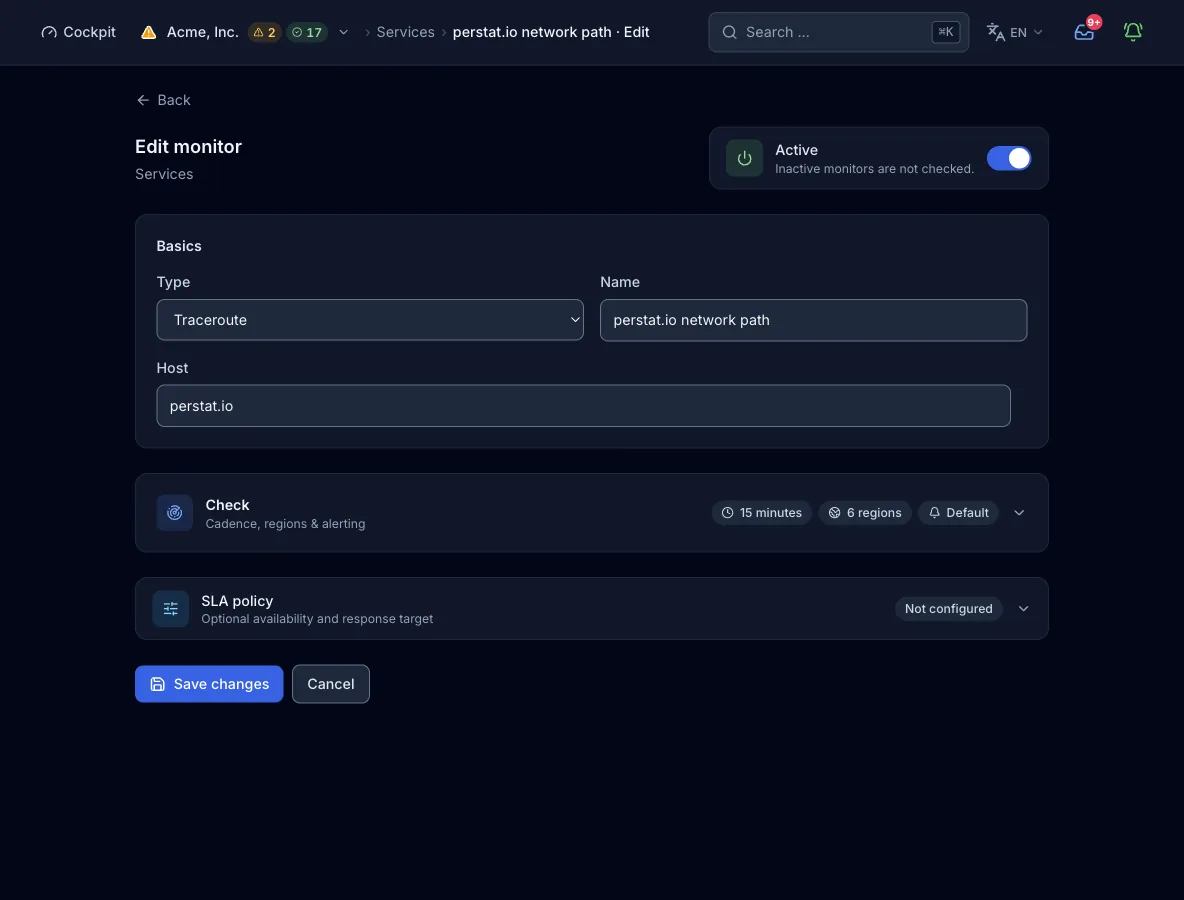
Configurazione
Target. Un nome host o un indirizzo IP, senza porta. Il nodo risolve il primo indirizzo della famiglia scelta tramite il proprio resolver e lo valida. Gli indirizzi loopback, privati, link-local e di metadata cloud vengono rifiutati, così il monitor non può essere puntato verso una rete interna.
| Campo | Obbligatorio | Valori e default | Significato |
|---|---|---|---|
hostHost | sì | Nome host o indirizzo IP | L’host verso cui viene tracciata la rotta, un indirizzo per famiglia. Il nodo controlla il primo indirizzo di quella famiglia contro la blocklist, poi avvia traceroute sul nome host, fissato alla famiglia. |
max_hops | opzionale | Default 20 | Il numero massimo di salti, passato a traceroute come -m. Si imposta tramite API o MCP, e un monitor creato nel modulo gira con 20. |
interval_secondsIntervallo del check | opzionale | Default 300. Alzato al minimo del piano, massimo 24 h | Ogni quanto ciascuna regione esegue il check. Il modulo offre valori preimpostati da 30 s a 1 h, e gli intervalli di 15 s o 10 s richiedono MCP. |
regionsRegioni | opzionale | Sottoinsieme di na, eu, as, sa, af, oce. Default: le prime n di quella lista, con n = limite di regioni del piano | Quali continenti eseguono il check. Più regioni di quante il piano ne consenta vengono rifiutate, non tagliate. |
address_familiesFamiglie IP | opzionale | ["ipv4"] (default), ["ipv6"] oppure ["ipv4", "ipv6"] | Traccia la rotta su una o entrambe le famiglie, un indirizzo ciascuna. Con entrambe, family_fail_severity decide cosa significa una famiglia che non si risolve o è bloccata. |
Famiglie IP
La rotta viene tracciata per famiglia IP, un indirizzo ciascuna, e ogni famiglia diventa un sotto-risultato a sé. Una famiglia il cui indirizzo non si risolve o è bloccato fallisce. Se una sola famiglia su due è in questa condizione decide family_fail_severity, se lo sono entrambe il check fallisce. Una famiglia che si risolve ma non raggiunge il target è degradata, e il check prende il peggiore dei due risultati. Il modulo offre IPv6 solo quando l’host ha un record AAAA o è un letterale IPv6, e allora restano selezionabili solo le regioni che sondano IPv6.
| Campo | Obbligatorio | Valori e default | Significato |
|---|---|---|---|
address_families | opzionale | ["ipv4"] (default), ["ipv6"] oppure ["ipv4", "ipv6"] | Quali famiglie vengono tracciate. Vuoto o assente significa solo IPv4. |
family_fail_severity | opzionale | degraded (default) oppure failed | Cosa comporta per lo stato del monitor una famiglia fallita su due. |
Come si svolge un check
- Ogni regione a cui tocca l’intervallo risolve l’host tramite il resolver del proprio nodo. Prende il primo indirizzo della famiglia scelta e lo valida contro gli intervalli di indirizzi bloccati.
- Il nodo esegue il traceroute di sistema verso l’host, fissato a quella famiglia. Usa l’output numerico, una sonda e 2 s di attesa per salto e al massimo
max_hopssalti. L’intera esecuzione può durare fino a 20 s, il maggiore tra 20 s e il limite di 10 s del monitor. - L’output viene letto: la riga di intestazione viene scartata, le righe dei salti vengono contate e l’ultima riga viene conservata.
- Il target conta come raggiunto quando l’ultima riga non contiene un
*, cioè quando l’ultimo salto ha risposto. Altrimenti, o se non è tornata nessuna riga di salto, il risultato è degradato. - Il risultato della regione va al control plane. La regola di alert decide poi, secondo il suo quorum, se una risoluzione fallita o un target bloccato diventa un incident. Un percorso degradato non ne apre uno.
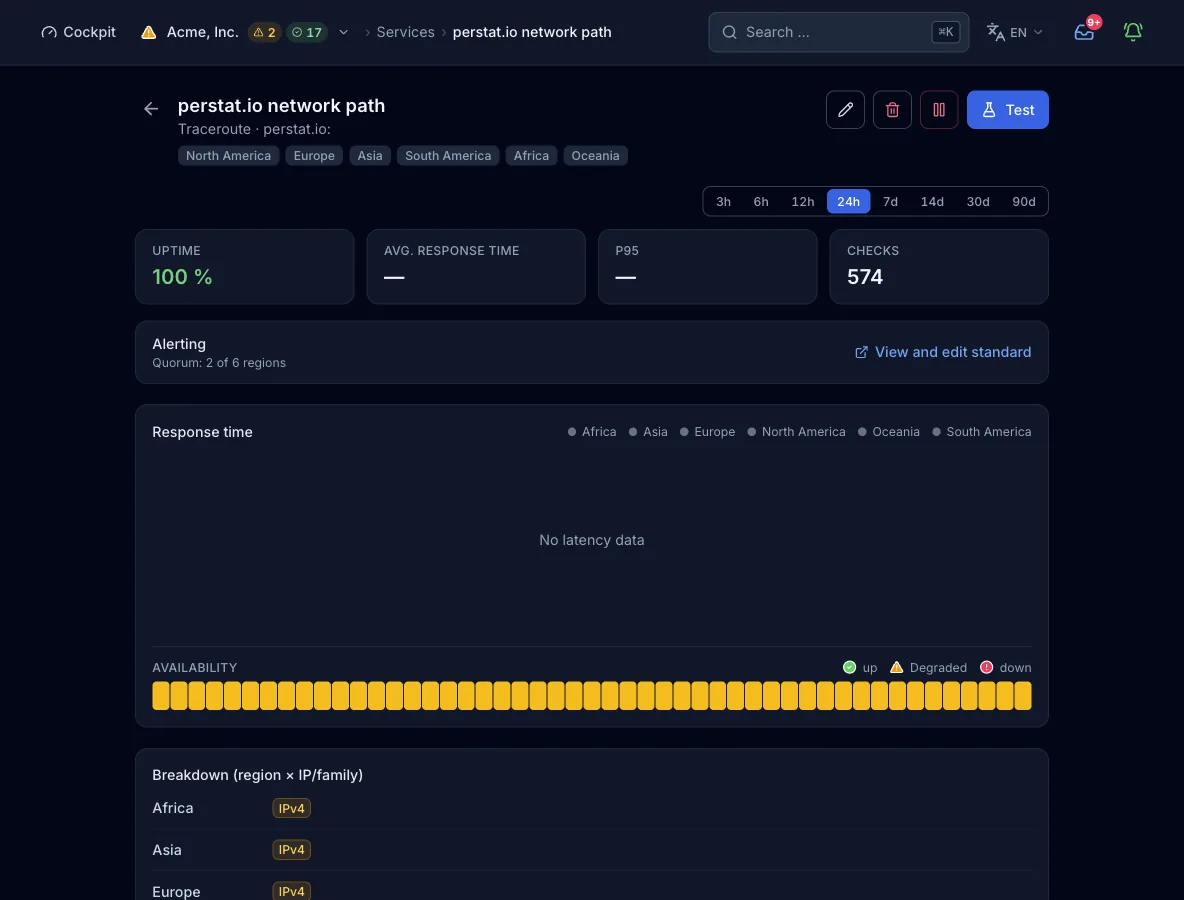
Cosa contiene un risultato
- Numero di salti
- Quante righe di salto ha prodotto l’esecuzione, per regione e per famiglia.
- Ultimo salto
- L’ultima riga dell’output di traceroute, testuale. È il salto del target quando il target è stato raggiunto, oppure una riga
*quando l’ultimo salto è rimasto muto. - Riga di dettaglio
- Una riga per check con il numero di salti e l’ultimo salto.
- Raggiunto o no
- Se l’ultimo salto ha risposto. Questo decide tra ok e degradato.
- Regione e famiglia
- Ogni risultato porta la regione che l’ha misurato e un sotto-risultato per famiglia IP. Non esistono sotto-risultati per indirizzo né per salto, e la lista completa dei salti non viene conservata.
- Tempo di risposta e codice di stato
- Il tipo non registra né l’uno né l’altro, quindi il grafico del tempo di risposta nella vista del monitor resta vuoto.
Stati e gravità
- okL’ultimo salto ha risposto: il target è stato raggiunto entro
max_hops. - degradatoL’ultima riga contiene un
*, quindi il target non è stato raggiunto, oppure l’esecuzione non ha restituito righe di salto. Con la gravità predefinita, anche una famiglia IP che non si risolve mentre l’altra traccia rende il check degradato. - downL’host non si risolve o risolve verso un indirizzo bloccato. Con entrambe le famiglie e
family_fail_severityimpostato sufailed, anche una famiglia che non si risolve rende il check down. Il percorso in sé non produce mai questo stato. - erroreIl nodo non può eseguire il check, perché manca il binario di traceroute o l’esecuzione ha superato il limite di 20 s. Conta come disservizio con gravità critica.
Confermato dal quorum: di default, 2 regioni devono segnalare il guasto prima che si apra un incident. Il default dell’organizzazione richiede 2 regioni e 2 check consecutivi. Un monitor può avere una regola propria (numero o percentuale, check consecutivi, durata minima). Solo down ed errore entrano nella valutazione degli incident, quindi un percorso non completato resta degradato e da solo non apre mai un incident.
Piani e limiti
- Intervallo minimo
- 300 s in Free, 60 s in Pulse e 30 s in Sentinel. Command consente 15 s ed Enterprise 10 s, entrambi impostabili solo tramite MCP. Il modulo offre valori preimpostati da 30 s a 1 h.
- Regioni
- 2 su 6 in Free, 3 su 6 in Pulse e tutte e 6 da Sentinel.
- Monitor
- 10 in Free, 50 in Pulse, 150 in Sentinel e 500 in Command. Le quote di Enterprise sono su misura. La quota vale per tutti gli undici tipi di check regionali, e i monitor agent e heartbeat hanno quote proprie.
Dalla pipeline o da un agente
La stessa config funziona nello step di deploy, in un client MCP come Claude Code e nel modulo qui sopra. create_monitor richiede una chiave API valida per tutta l’organizzazione. Se ometti regions, il piano sceglie il suo default.
{
  "name": "Gateway path",
  "type": "traceroute",
  "interval_seconds": 900,
  "config": {
    "host": "gateway.example.com",
    "max_hops": 30,
    "address_families": ["ipv4", "ipv6"],
    "family_fail_severity": "degraded"
  }
}
Ogni interfaccia, con il suo limite
Limiti
- Il check serve alla diagnosi, non come segnale di disponibilità, quindi un target non raggiunto è degradato e non apre alcun incident. L’esecuzione in sé causa un disservizio solo quando traceroute non può partire o supera il limite di 20 s. Affiancagli il check ping o HTTP(S).
- Ogni salto riceve una sonda con 2 s di attesa, e il default è di 20 salti. L’intera esecuzione è limitata a 20 s.
max_hopssi imposta tramite API o MCP, non nel modulo.- Il check traccia un indirizzo per famiglia, senza sotto-risultati per indirizzo né per salto. Oltre al numero di salti e all’ultima riga, la lista dei salti non viene conservata.
- Il check non registra né tempo di risposta né codice di stato.
- I target su indirizzi privati, loopback, link-local e di metadata cloud vengono rifiutati.
- Non tutte le regioni sondano IPv6, quindi selezionare
ipv6restringe le regioni utilizzabili.