In questa pagina
Un percorso per servizi, reti, host e job
Ogni piano include 13 tipi di check: HTTP, header HTTP, TCP, DNS, igiene DNS, dominio, certificato TLS, SMTP, IMAP, ping, traceroute, agent e heartbeat. Coprono servizi raggiungibili dall’esterno, segnali dell’host e job che comunicano il proprio esito. Ogni risultato segue un solo monitor e un solo percorso di incident, invece di dividersi fra strumenti diversi.
Perstat si limita di proposito all’uptime e al registro che ne deriva. Non è un APM e non gestisce i log.
Da un risultato a un incident confermato
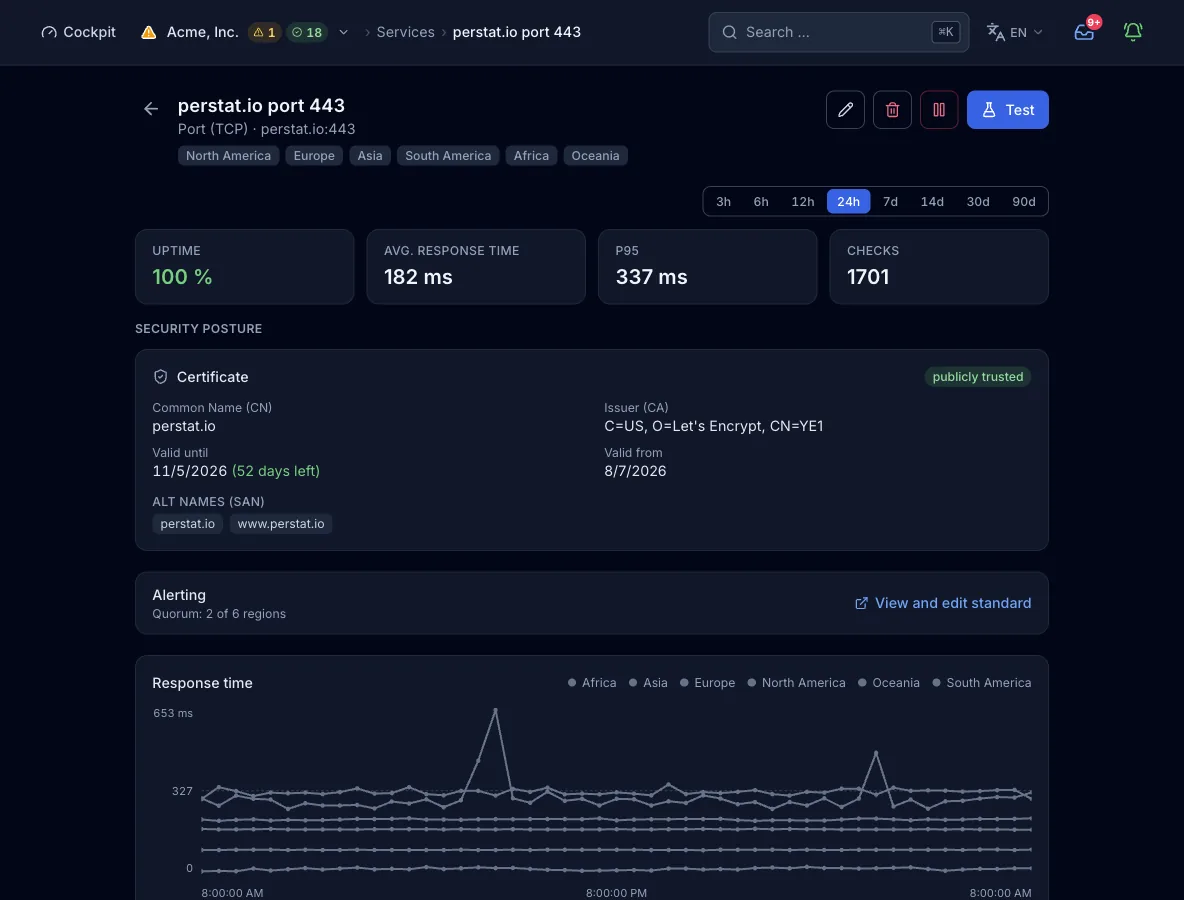
Undici tipi di check passano dalle sonde regionali. Con la regola standard, una sola regione non apre un incident. Il monitor richiede un quorum di 2 regioni, e la regola è configurabile.
Agent e heartbeat sono le due eccezioni. Segnalano direttamente e non usano né regioni di sonda né quorum regionale.
La documentazione sul quorum descrive entrambi i percorsi. La pagina della rete di sonde documenta la topologia attuale e l’aggregazione regionale.
Vedi il segnale prima che diventi un alert
Perstat mostra lo stato in formazione prima che la regola configurata confermi un guasto regionale. La lista di osservazione conserva le divergenze di regione, famiglia IP, singolo IP e nodo. Così l’operatore riceve un segnale precoce senza trattare la prima deviazione come un incident.
I risultati confermati mantengono anche il contesto diagnostico. Dove applicabile, Perstat separa il tempo DNS e attribuisce l’errore a uno di questi livelli:
- applicazione target
- DNS target
- rete
- resolver Perstat
- nodo di sonda
HTTP, rete e DNS restano verificabili
Un monitor HTTP può verificare un codice di stato atteso, una parola chiave o un’espressione regolare. Lo stesso monitor può includere subcheck per TLS, header di sicurezza e igiene DNS. Perstat segue i redirect fino a 5 salti e verifica ogni destinazione della catena contro la stessa blocklist SSRF.
I check sui record A e AAAA mantengono i risultati per famiglia di indirizzi e per IP. Un monitor DNS può confrontare il proprio insieme di risposte con un altro monitor, per corrispondenza identica, sottoinsieme o sovrapposizione.
Host e job segnalano direttamente
L’host agent nativo supporta Linux su x86_64 e aarch64, e macOS come binario universale. Segnala la disponibilità e i servizi per nome, insieme a CPU, memoria e disco.
L’agent non legge righe di comando, variabili d’ambiente o nomi utente. Non ha un canale per comandi remoti. Windows oggi non è supportato.
Un heartbeat dà a un job due URL: uno di ping e uno di fallimento. Se il silenzio supera il periodo configurato più la tolleranza, l’heartbeat risulta down. L’URL di fallimento segnala in modo esplicito un’esecuzione fallita, senza attendere quella finestra di silenzio.
La manutenzione sopprime gli alert e resta registrata
Una finestra di manutenzione pianificata sopprime i nuovi incident, resta nel registro di disponibilità ed è esclusa dall’uptime. Un falso positivo scartato crea una finestra di esclusione separata e reversibile, con motivazione e autore. Il registro di disponibilità spiega questo percorso di revisione.
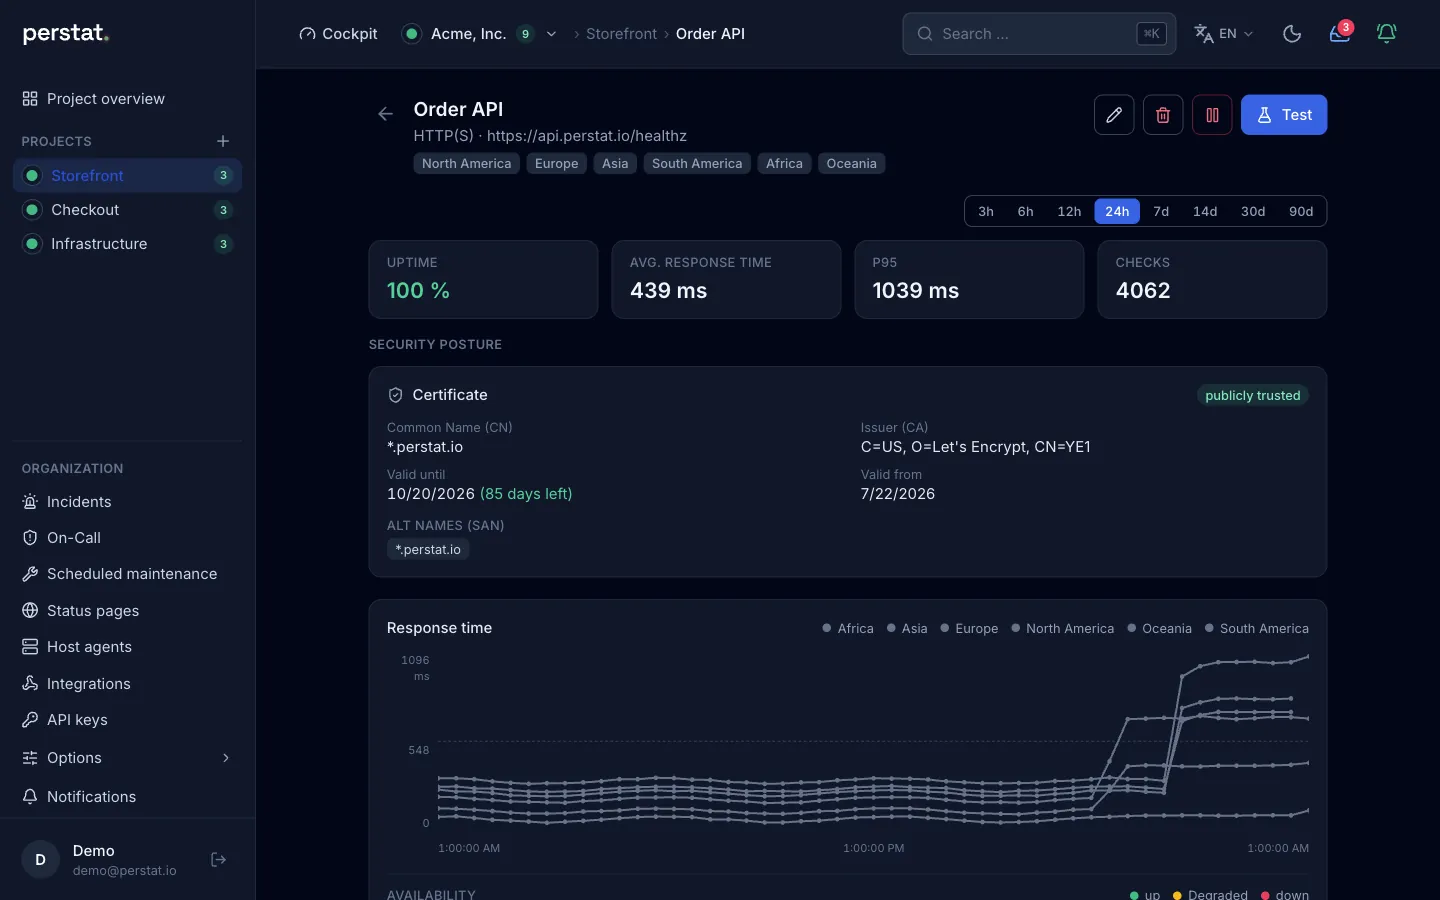
Esamina un monitor reale
Il piano fissa regioni e intervallo minimo
| Piano | Regioni di sonda | Intervallo minimo (secondi) |
|---|---|---|
| Free | 2 | 300 |
| Pulse | 3 | 60 |
| Sentinel | 6 | 30 |
| Command | 6 | 15 |
| Enterprise | 6 | 10 |
Il modulo web offre 30 secondi e oltre. Con Command ed Enterprise imposti 15 o 10 secondi tramite MCP.
Le regioni di sonda sono:
- Nord America
- Sud America
- Europa
- Africa
- Asia
- Oceania
I limiti esatti per monitor, agent, heartbeat e conservazione sono nella pagina dei prezzi.
Inizia a monitorare gratis, oppure configura il primo monitor con la documentazione dei monitor.